

 O SGBD InterSystems IRIS suporta estruturas curiosas para armazenamento de dados — globais. Essencialmente, são chaves em múltiplos níveis com diversas funcionalidades adicionais, como transações, funções rápidas para navegação em árvores de dados, bloqueios e sua própria linguagem ObjectScript.
Saiba mais sobre globais na série de artigos "Globais — espadas mágicas para armazenamento de dados":
Fiquei curioso sobre como as transações são implementadas em globais, quais são suas particularidades. Afinal, trata-se de uma estrutura totalmente diferente para armazenamento de dados em comparação com as tabelas habituais. É muito mais de baixo nível.
Como é sabido na teoria de bancos de dados relacionais, uma boa implementação de transações deve satisfazer os requisitos :
A — Atomicidade. Todas as alterações feitas na transação são registradas ou nenhuma delas é.
C — Consistência. Após a conclusão da transação, o estado lógico do BD deve ser internamente consistente. Em grande parte, esse requisito diz respeito ao programador, mas, no caso de bancos de dados SQL, também se relaciona a chaves externas.
I — Isolamento. Transações executadas em paralelo não devem influenciar umas às outras.
D — Durabilidade. Após a conclusão bem-sucedida da transação, problemas em níveis inferiores (como uma falha de energia) não devem afetar os dados alterados pela transação.
Globais são estruturas de dados não relacionais. Elas foram criadas para operar em alta velocidade em hardware muito limitado. Vamos examinar a implementação de transações em globais usando .
Para suportar transações no IRIS, são utilizados os comandos: , , .
1. Atomicidade
É mais fácil verificar a atomicidade. Vamos testar pelo console do banco de dados.
Kill ^a
TSTART
Set ^a(1) = 1
Set ^a(2) = 2
Set ^a(3) = 3
TCOMMIT
Depois, faremos a seguinte verificação:
Write ^a(1), “ ”, ^a(2), “ ”, ^a(3)Receberemos:
1 2 3Tudo em ordem. Atomicidade cumprida: todas as alterações foram gravadas.
Vamos complicar a situação, introduzindo um erro e vendo como a transação será mantida, parcialmente ou não.
Mais uma vez, vamos verificar a atomicidade:
Kill ^A
TSTART
Set ^a(1) = 1
Set ^a(2) = 2
Set ^a(3) = 3
Em seguida, pararemos o contêiner forçosamente, reiniciaremos e veremos.
docker kill my-irisEste comando é praticamente equivalente a uma interrupção forçada de energia, pois envia um sinal de parada imediata do processo SIGKILL.
Pode ser que a transação tenha sido salva parcialmente?
WRITE ^a(1), ^a(2), ^a(3)
^
 ^a(1)
— Não, não foi salva.
Testaremos o comando de reversão:
Kill ^A
TSTART
Set ^a(1) = 1
Set ^a(2) = 2
Set ^a(3) = 3
TROLLBACK

WRITE ^a(1), ^a(2), ^a(3)
^
 ^a(1)
Nada foi salvo também.
2. Consistência
Como nas bases de dados globais as chaves também são feitas em globais (lembro que global é uma estrutura de nível inferior para armazenamento de dados, comparado a uma tabela relacional), para atender à exigência de consistência, a modificação da chave deve ser incluída na mesma transação que a modificação do global.
Por exemplo, temos o global ^person, onde armazenamos personalidades e usamos o CPF como chave.
^person(1234567, 'firstname') = 'Sergey'
^person(1234567, 'lastname') = 'Kamenev'
^person(1234567, 'phone') = '+74995555555
...
Para ter uma busca rápida pelo sobrenome e nome, criamos a chave ^index.
^index('Kamenev', 'Sergey', 1234567) = 1Para que o banco esteja consistente, devemos adicionar a personalidade da seguinte forma:
TSTART
^person(1234567, 'firstname') = 'Sergey'
^person(1234567, 'lastname') = 'Kamenev'
^person(1234567, 'phone') = '+74995555555
^index('Kamenev', 'Sergey', 1234567) = 1
TCOMMIT
Portanto, ao excluir, também devemos usar uma transação:
TSTART
Kill ^person(1234567)
ZKill ^index('Kamenev', 'Sergey', 1234567)
TCOMMIT
Em outras palavras, o cumprimento da exigência de consistência recai completamente sobre os ombros do programador. Mas quando se trata de globais, isso é normal, devido à sua natureza de nível inferior.
3. Isolamento
Aqui começam as complicações. Muitos usuários trabalham simultaneamente em um mesmo banco de dados, alterando os mesmos dados.
A situação é comparável a muitos usuários trabalhando simultaneamente em um mesmo repositório de código e tentando commitar mudanças em muitos arquivos ao mesmo tempo.
O banco de dados deve lidar com tudo isso em tempo real. Considerando que em empresas sérias há até uma pessoa específica responsável pelo controle de versões (por fusões de branches, resolução de conflitos etc.), e que o BD deve fazer tudo isso em tempo real, a complexidade da tarefa e a correção do design do banco de dados e do código que o suporta tornam-se evidentes.
O banco de dados não consegue entender o significado das ações executadas pelos usuários para evitar conflitos ao trabalharem com os mesmos dados. Ele pode apenas desfazer uma transação que contradiz outra ou executá-las de forma sequencial.
Outro problema é que, durante a execução da transação (antes do commit), o estado do banco pode estar inconsistente, por isso é desejável que outras transações não tenham acesso a esse estado inconsistente do banco de dados, o que é alcançado em bancos de dados relacionais de várias maneiras: criação de snapshots, multiversionamento de linhas, etc.
Durante a execução paralela de transações, é importante que elas não interfiram uma na outra. Essa é a propriedade de isolamento.
O SQL define 4 níveis de isolamento:
- LEITURA NÃO CONFIRMADA
- LEITURA CONFIRMADA
- LEITURA REPETÍVEL
- SERIALIZÁVEL
Vamos considerar cada nível separadamente. Os custos de implementação de cada nível aumentam quase exponencialmente.
LEITURA NÃO CONFIRMADA — este é o nível mais baixo de isolamento, mas o mais rápido. As transações podem ler as mudanças feitas umas pelas outras.
LEITURA CONFIRMADA — este é o próximo nível de isolamento que é um compromisso. As transações não podem ler as mudanças feitas umas pelas outras até o commit, mas podem ler quaisquer alterações feitas após o commit.
Se tivermos uma longa transação T1, durante a qual ocorreram commits nas transações T2, T3 ... Tn, que trabalharam com os mesmos dados que T1, ao solicitar dados em T1, sempre receberemos resultados diferentes. Esse fenômeno é chamado de leitura não repetível.
LEITURA REPETÍVEL — neste nível de isolamento não temos o fenômeno de leitura não repetível, pois para cada solicitação de leitura de dados é criado um snapshot dos dados resultantes e, ao reutilizá-los nesta mesma transação, são utilizados os dados do snapshot. No entanto, neste nível de isolamento é possível a leitura de dados fantasmas. Refere-se à leitura de novas linhas que foram adicionadas por transações paralelas confirmadas.
SERIALIZÁVEL — o mais alto nível de isolamento. Ele é caracterizado pelo fato de que os dados de alguma forma utilizados na transação (leitura ou alteração) tornam-se acessíveis a outras transações apenas após a conclusão da primeira transação.
Para começar, vamos verificar se há isolamento das operações na transação em relação ao fluxo principal. Vamos abrir 2 janelas de terminal.
Kill ^t

Write ^t(1)
2
TSTART
Set ^t(1)=2
Não há isolamento. Um fluxo vê o que o segundo, que abriu a transação, está fazendo.
Vamos ver se as transações em diferentes fluxos veem o que acontece dentro delas.
Vamos abrir 2 janelas de terminal e abrir 2 transações em paralelo.
kill ^t
TSTART
Write ^t(1)
3
TSTART
Set ^t(1)=3
Transações paralelas veem os dados umas das outras. Assim, temos o nível mais simples, mas também o mais rápido de isolamento: READ UNCOMMITTED.
Isso era de se esperar para globais, para os quais a performance sempre foi uma prioridade.
O que fazer, se precisarmos de um nível de isolamento mais alto em operações sobre globais?
Aqui, é preciso pensar sobre por que os níveis de isolamento são necessários e como eles funcionam.
O nível mais alto de isolamento, SERIALIZE, significa que o resultado de transações executadas em paralelo é equivalente à sua execução sequencial, garantindo a ausência de colisões.
Isso podemos fazer com bloqueios adequados em ObjectScript, que têm uma variedade de formas de aplicação: podemos fazer bloqueios normais, incrementais, múltiplos com o comando .
Níveis mais baixos de isolamento são compromissos destinados a aumentar a velocidade de operação do banco de dados.
Vamos ver como podemos alcançar diferentes níveis de isolamento com bloqueios.
Este operador permite obter não apenas bloqueios exclusivos, necessários para modificar dados, mas também bloqueios compartilhados, que podem ser obtidos por vários fluxos simultaneamente, quando precisam ler dados que não devem ser alterados por outros processos durante a leitura.
Mais detalhes sobre o método de bloqueio de duas fases em russo e inglês:
→
→
A complexidade reside no fato de que durante a transação, o estado do banco pode estar inconsistente, no entanto, esses dados inconsistentes são visíveis para outros processos. Como evitar isso?
Faremos isso com bloqueios, criando janelas de visibilidade onde o estado do banco estará consistente. E todas as chamadas a essas janelas de visibilidade de estado consistente serão controladas por bloqueios.
As bloqueios compartilhados de dados duplicados podem ser adquiridos por vários processos. Esses bloqueios impedem que outros processos alterem os dados, ou seja, são usados para formar janelas de estado consistente do banco de dados.
Os bloqueios exclusivos são utilizados para alterações de dados - esse tipo de bloqueio pode ser adquirido apenas por um único processo. Um bloqueio exclusivo pode ser adquirido por:
- Qualquer processo, se os dados estiverem livres.
- Somente o processo que possui um bloqueio compartilhado sobre esses dados e solicitou primeiro o bloqueio exclusivo.
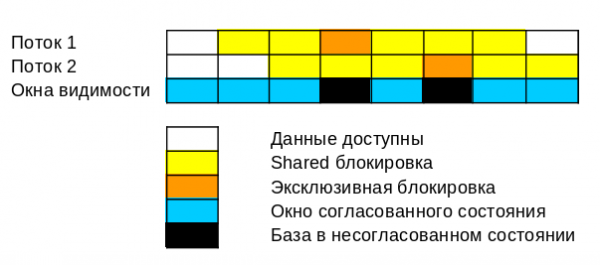
Quanto mais estreita for a janela de visibilidade, mais tempo outros processos terão que esperar, mas mais consistente pode ser o estado do banco de dados nela.
READ_COMMITED — a essência deste nível é que vemos apenas os dados confirmados de outras transações. Se os dados em outra transação ainda não foram confirmados, vemos sua versão antiga.
Isso nos permite paralelizar o trabalho em vez de esperar pela liberação do bloqueio.
Sem artifícios especiais, não conseguiremos ver a versão antiga dos dados no IRIS, então teremos que nos basear em bloqueios.
Consequentemente, teremos que permitir a leitura de dados só em momentos de consistência, usando bloqueios compartilhados.
Suponha que temos um banco de usuários ^person, que transferem dinheiro entre si.
O momento da transferência da pessoa 123 para a pessoa 242:
LOCK +^person(123), +^person(242)
Set ^person(123, amount) = ^person(123, amount) - amount
Set ^person(242, amount) = ^person(242, amount) + amount
LOCK -^person(123), -^person(242)
O momento em que se solicita a quantidade de dinheiro da pessoa 123 antes da dedução deve ser acompanhado de um bloqueio exclusivo (por padrão):
LOCK +^person(123)
Write ^person(123)
E se precisar mostrar o estado da conta no painel, pode-se usar um bloqueio compartilhado ou não usar bloqueio algum:
LOCK +^person(123)#”S”
Write ^person(123)
No entanto, se admitirmos que as operações com o banco de dados são realizadas praticamente instantaneamente (lembro que os globais são uma estrutura muito mais de baixo nível do que uma tabela relacional), a necessidade desse nível diminui.
LEITURA REPETÍVEL — neste nível de isolamento, é permitido que haja várias leituras de dados que podem ser alteradas por transações paralelas.
Consequentemente, teremos que colocar bloqueios compartilhados para a leitura de dados que alteramos e bloqueios exclusivos para os dados que modificamos.
O operador LOCK permite detalhar bloqueios necessários em um único operador, que podem ser muitos.
LOCK +^person(123, amount)#”S”
leitura ^person(123, amount)
outras operações (durante esse tempo, fluxos paralelos tentam alterar ^person(123, amount), mas não conseguem)
LOCK +^person(123, amount)
modificação ^person(123, amount)
LOCK -^person(123, amount)

leitura ^person(123, amount)
LOCK -^person(123, amount)#”S”
Ao listar bloqueios separados por vírgula, eles são tratados sequencialmente, mas se fizer assim:
LOCK +(^person(123),^person(242))eles serão tratados atomicamente todos de uma só vez.
SERIALIZE — teremos que aplicar bloqueios de forma que, no final, todas as transações que compartilham dados sejam executadas sequencialmente. Para essa abordagem, a maioria dos bloqueios deve ser exclusiva e abranger as menores áreas globais para maior desempenho.
No que diz respeito a retiradas de fundos da global ^person, apenas o nível de isolamento SERIALIZE é aceitável, já que o dinheiro deve ser gasto estritamente de forma sequencial, caso contrário, é possível gastar a mesma quantia várias vezes.
4. Permanência
Realizei testes com a interrupção abrupta do contêiner através de
docker kill my-irisO banco se adaptou bem. Nenhum problema foi identificado.
Conclusão
Para globais no InterSystems IRIS, há suporte a transações. Elas são realmente atômicas e confiáveis. No entanto, para garantir a consistência do banco de dados nas globais, é necessário o esforço do programador e o uso de transações, pois não há complexas construções embutidas, como chaves estrangeiras.
O nível de isolamento nas globais sem o uso de bloqueios é READ UNCOMMITED, e com o uso de bloqueios, pode-se garantir até o nível SERIALIZE.
A correção e a velocidade das transações nas globais dependem muito da habilidade do programador: quanto mais amplamente são usadas bloqueios compartilhados durante a leitura, maior é o nível de isolamento, e quanto mais restritivamente são usadas bloqueios exclusivos, maior é a velocidade.
Fonte: habr.com
