

O princípio da incerteza de Heisenberg afirma que não é possível medir simultaneamente a posição de um objeto e sua velocidade. Se um objeto está em movimento, ele não tem uma localização definida. E se há uma localização, significa que não possui velocidade.
No que diz respeito aos microsserviços na plataforma Red Hat OpenShift (e sob a gestão do Kubernetes), devido ao software de código aberto, eles podem relatar simultaneamente seu desempenho e sua integridade. Isso, é claro, não refuta o velho Heisenberg, mas elimina a incerteza ao trabalhar com aplicações em nuvem. O Istio permite organizar facilmente a rastreabilidade e o monitoramento dessas aplicações para mantê-las sob controle.
Definindo a terminologia
Por rastreamento (Tracing) entendemos como o registro da atividade do sistema. Parece bastante genérico, mas na verdade uma das principais regras aqui é despejar os dados de rastreamento no repositório apropriado, sem se preocupar com sua formatação. E todo o trabalho de busca e análise dos dados é responsabilidade do consumidor. O Istio usa o sistema de rastreamento Jaeger, que implementa o modelo de dados OpenTracing.
Rastros (Traces, e a palavra "rastros" aqui é usada no sentido de "marcas", como na análise balística) chamaremos de dados que descrevem completamente o percurso de uma solicitação ou unidade de trabalho, ou seja, "do início ao fim". Por exemplo, tudo o que acontece desde o momento em que o usuário clica em um botão na página da web até o retorno dos dados, incluindo todos os microsserviços envolvidos. Pode-se dizer que um rastro descreve completamente (ou modela) o percurso de uma solicitação de ida e volta. Na interface do Jaeger, os rastros são dispostos em componentes ao longo do tempo, como uma corrente pode ser dividida em elos individuais. Mas, em vez de elos, o rastro consiste nos chamados spans.
Span – é o intervalo desde o início da execução de uma unidade de trabalho até sua conclusão. Continuando a analogia, pode-se dizer que cada span é um elo separado da corrente. Um span pode ter (ou não ter) um ou mais spans filhos. Como consequência, o span de nível mais alto (root span) terá a mesma duração geral que o rastro ao qual está associado.
Monitoramento – é, na verdade, a própria observação do seu sistema – através dos olhos, pelo UI ou por meio de ferramentas de automação. A base da monitorização está nos dados de rastreamento. No Istio, a monitorização é implementada usando o Prometheus e possui uma interface correspondente. O Prometheus suporta a monitorização automática com o uso de alertas e Alert Managers.
Deixamos marcas
Para que o rastreamento seja possível, a aplicação deve criar uma coleção de spans. Depois, eles precisam ser exportados para o Jaeger, que por sua vez irá criar uma representação visual do rastreamento. Entre outras coisas, esses spans marcam o nome da operação, bem como as marcas de tempo de início e término. A transferência dos spans é feita redirecionando os cabeçalhos HTTP destinados ao Jaeger das requisições de entrada para as requisições de saída. Dependendo da linguagem de programação utilizada, isso pode exigir uma pequena modificação no código-fonte das aplicações. Abaixo está um exemplo de código em Java (usando o framework Spring Boot) que adiciona cabeçalhos B3 (estilo Zipkin) à sua solicitação na classe de configuração do Spring:
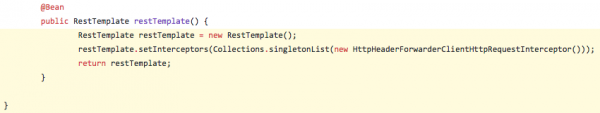
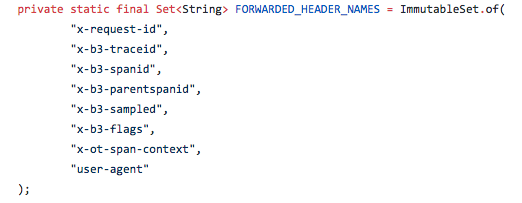
As seguintes configurações de cabeçalho são utilizadas:
Se você estiver usando Java, não é necessário alterar o código, apenas adicionar algumas linhas no arquivo POM do Maven e definir variáveis de ambiente. Aqui estão as linhas que devem ser adicionadas ao arquivo POM.XML para implementar o Jaeger Tracer Resolver:
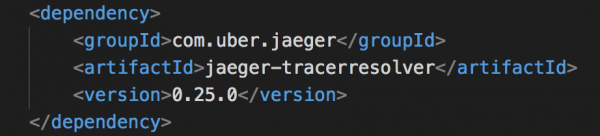
As correspondentes variáveis de ambiente são definidas no Dockerfile:
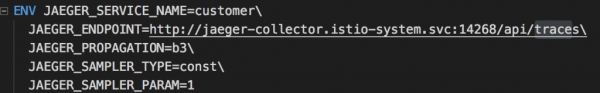
Pronto, agora tudo está configurado, e nossos microserviços começarão a gerar dados de rastreamento.
Vamos dar uma olhada de forma geral
O Istio inclui um painel de controle simples baseado no Grafana. Quando tudo está configurado e funcionando na plataforma Red Hat OpenShift PaaS (no nosso exemplo, Red Hat OpenShift e Kubernetes estão implementados no minishift), este painel é iniciado com o seguinte comando:
open "$(minishift openshift service grafana -u)\/d\/1\/istio-dashboard?refresh=5⩝Id=1"
O painel do Grafana permite avaliar rapidamente o desempenho do sistema. Um fragmento deste painel é mostrado na figura abaixo:
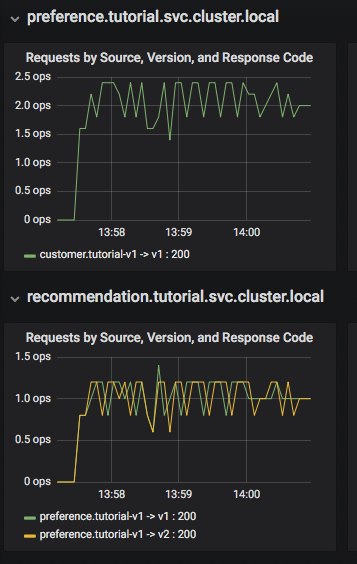
Aqui podemos ver que o microsserviço customer chama o microsserviço preference v1, que por sua vez chama os microsserviços recommendation v1 e v2. No painel Grafana, há um bloco Dashboard Row para métricas de alto nível, como o volume total de solicitações (Global Request Volume), a taxa de solicitações bem-sucedidas (success rates) e erros 4xx. Além disso, há uma visualização Server Mesh com gráficos para cada serviço e um bloco Services Row para ver detalhes sobre cada contêiner de cada serviço.
Agora vamos mergulhar mais fundo
Com o rastreamento do Istio configurado corretamente, o que pode ser feito praticamente direto da caixa, é possível aprofundar na análise de desempenho do sistema. Na interface do Jaeger, você pode visualizar rastreamentos e ver quão longe e profundo eles vão, além de localizar visualmente os gargalos de desempenho. Ao usar o Red Hat OpenShift na plataforma minishift, você pode iniciar a interface do Jaeger com o seguinte comando:
minishift openshift service jaeger-query --in-browser
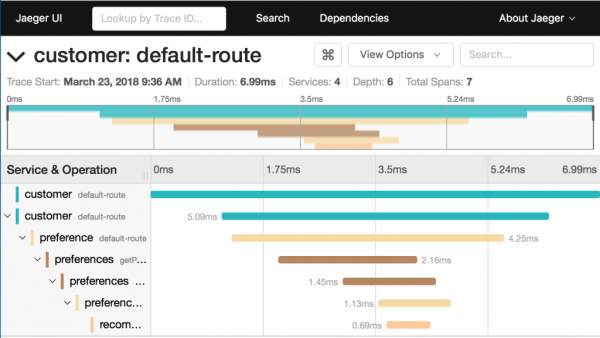
O que podemos dizer sobre o rastreamento nesta tela:
- Ele é dividido em 7 spans.
- O tempo total de execução é de 6,99 ms.
- O microsserviço recommendation, que é o último da cadeia, leva 0,69 ms.
Diagramas desse tipo permitem entender rapidamente a situação quando um serviço que não está funcionando bem afeta o desempenho de todo o sistema.
Agora vamos complicar a tarefa e iniciar duas instâncias do microsserviço recommendation:v2 com o comando oc scale —replicas=2 deployment/recommendation-v2. Aqui estão os pods que teremos após isso:
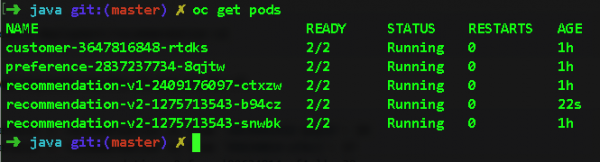
Se agora voltarmos ao Jaeger e expandirmos o span para o serviço recommendation, veremos para qual pod as solicitações estão sendo roteadas. Assim, podemos facilmente localizar os delays no nível de um pod específico. Observe o campo node_id:
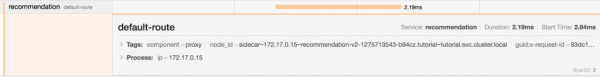
Para onde e como tudo é encaminhado
Agora, vamos para a interface do Prometheus e, como era de se esperar, vemos que as solicitações entre a segunda e a primeira versões do serviço recommendation estão sendo divididas na proporção de 2:1, estritamente de acordo com o número de pods em funcionamento. Além disso, esse gráfico mudará dinamicamente com a escalonamento dos pods para cima e para baixo, o que será especialmente útil durante o Canary Deployment (veremos essa estratégia de implantação em mais detalhes da próxima vez).
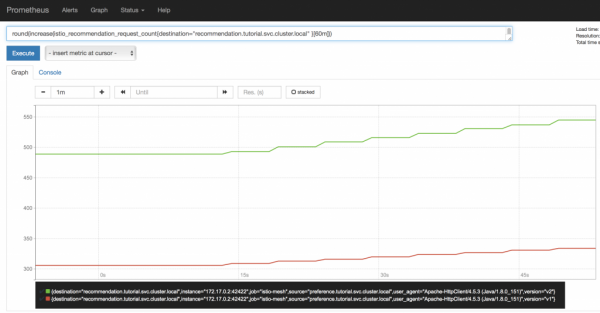
Tudo está apenas começando
Na verdade, hoje apenas tocamos levemente na fonte de informações úteis sobre Jaeger, Grafana e Prometheus. Esse era, de fato, nosso objetivo – direcioná-lo na direção certa e abrir as perspectivas do Istio.
E lembre-se, tudo isso já está embutido no Istio. Ao usar certas linguagens de programação (como Java) e frameworks (como Spring Boot), tudo isso pode ser implementado sem alterar o código das aplicações. Sim, será necessário modificar um pouco o código se você estiver usando outras linguagens, principalmente Nodejs ou C#. Mas como a rastreabilidade (ou 'traçabilidade') é um dos requisitos obrigatórios na construção de sistemas de nuvem confiáveis, você precisará ajustar o código de qualquer forma, independentemente de ter ou não o Istio. Então, por que não direcionar seu esforço de forma mais produtiva?
Pelo menos para sempre responder às perguntas 'onde?' e 'com que rapidez?' com 100% de certeza.
Engenharia do caos no Istio: assim foi planejado
A habilidade de quebrar coisas ajuda a garantir que elas não quebrem
Testar software é algo não apenas complicado, mas também importante. Ao mesmo tempo, testar a correção (por exemplo, se uma função retorna o resultado correto) é uma coisa, enquanto testar em condições de rede instável é uma tarefa completamente diferente (frequentemente, assume-se que a rede sempre funciona sem falhas, e essa é a primeira de oito falácias sobre computação distribuída). Uma das dificuldades ao enfrentar essa tarefa é como simular falhas no sistema ou introduzi-las deliberadamente, realizando o que é conhecido como injeção de falhas. Isso pode ser feito modificando o código-fonte da própria aplicação. Mas então você estará testando não seu código original, mas uma versão que simula falhas. Como resultado, você corre o risco de cair nos abraços mortais da injeção de falhas e enfrentar 'geysers bugs' – falhas que desaparecem ao tentar detectá-las.
Agora, vamos mostrar como o Istio ajuda a enfrentar essas complexidades de maneira simples.
Como tudo parece quando está tudo ótimo
Vamos considerar o seguinte cenário: temos dois pods para nosso microsserviço de recomendação, que pegamos do manual do Istio. Um pod está marcado como v1 e o outro como v2. Como podemos ver, tudo está funcionando perfeitamente até agora.
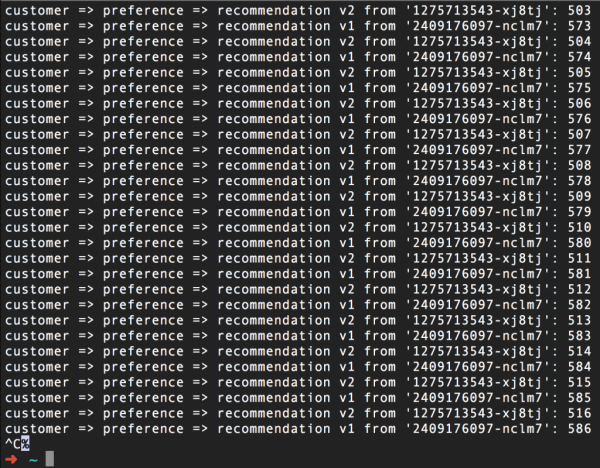
(A propósito, o número à direita é apenas um contador de chamadas para cada pod.)
Mas precisamos de algo muito diferente, certo? Bem, vamos tentar quebrar tudo, sem tocar no código fonte.
Causando interrupções no funcionamento do microserviço
Abaixo está o arquivo yaml para a regra de roteamento do Istio, que falhará em metade das vezes (erro servidor 503):
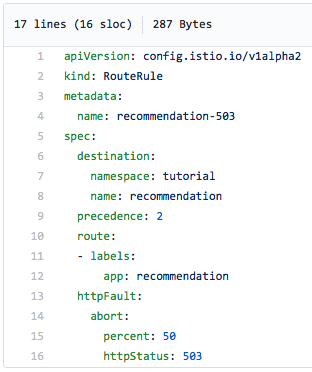
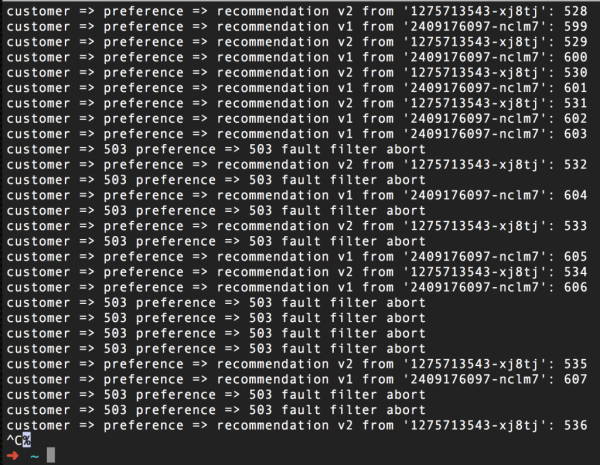
Observe que estamos especificando claramente que em metade das vezes deve retornar um erro 503.
E dá uma olhada em como será a captura de tela do comando curl em execução em loop após ativarmos essa regra para simular falhas. Como vemos, metade das requisições retorna o erro 503, independentemente de para qual pod – v1 ou v2 – elas estão indo:
Para restaurar o funcionamento normal, basta remover essa regra, que neste caso é feita com o comando istioctl delete routerule recommendation-503 -n tutorial. Aqui, Tutorial é o nome do projeto Red Hat OpenShift em que nosso tutorial de Istio está sendo executado.
Introduzindo atrasos artificiais
Erros artificiais 503 ajudam a testar o sistema quanto à resistência a falhas, mas a capacidade de prever e lidar com atrasos deve impressioná-lo ainda mais. Além disso, atrasos na vida real ocorrem com mais frequência do que falhas. Um microserviço lento é um veneno que afeta todo o sistema. Com o Istio, podemos testar o código relacionado ao manejo de atrasos sem alterá-lo. Para começar, vamos mostrar como fazer isso no caso de atrasos de rede introduzidos artificialmente.
Observe que, após esse teste, pode ser que você precise (ou queira) ajustar seu código. A boa notícia é que, neste caso, você estará agindo de forma proativa, e não reativa. É assim que o ciclo de desenvolvimento deve ser construído: codificação-teste-feedback-codificação-teste…
Aqui está como parece a regra que... Embora você saiba o quê? O Istio é tão simples e este arquivo yaml é tão claro que tudo neste exemplo fala por si só, basta dar uma olhada:
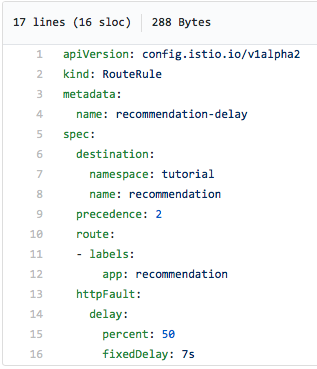
Na metade dos casos, teremos um atraso de 7 segundos. E isso não é o mesmo que se tivéssemos inserido um comando sleep no código-fonte, pois o Istio realmente atrasa a solicitação em 7 segundos. Como o Istio suporta rastreamento Jaeger, esse atraso é claramente visível na interface do Jaeger, como mostrado na captura de tela abaixo. Observe a longa solicitação no canto superior direito do gráfico – sua duração é de 7,02 segundos:
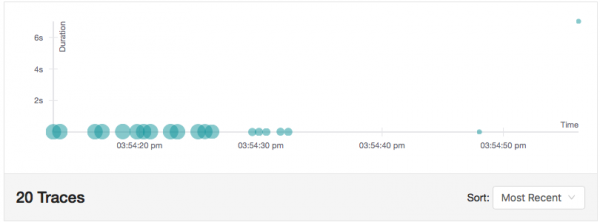
Esse cenário permite testar o código em condições de atrasos de rede. E é evidente que, ao remover essa regra, eliminaremos o atraso artificial. Reiteramos, mas fizemos tudo isso sem tocar no código-fonte.
Não recuar e não desistir
Outra função útil do Istio para engenharia do caos é a possibilidade de fazer novas tentativas ao serviço um número determinado de vezes. A ideia aqui é não parar de tentar quando a primeira solicitação resulta em erro 503 – e assim, talvez na N-ésima tentativa tenhamos sorte. Pode ser que o serviço tenha apenas se desacelerado por algum motivo. Sim, essa causa precisa ser investigada e resolvida. Mas isso fica para depois; por enquanto, vamos tentar manter o sistema em funcionamento.
Então, queremos que o serviço ocasionalmente retorne um erro 503, e o Istio, após isso, tente se reconectar. E aqui claramente precisamos de uma forma de gerar um erro 503 sem tocar no código…
Espere, um momento! Acabamos de fazer isso.
Este arquivo fará com que o serviço recommendation-v2 retorne um erro 503 em metade das vezes:
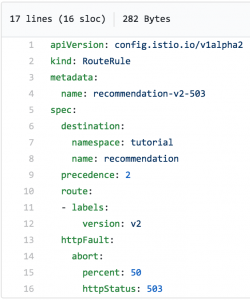
É evidente que parte das solicitações terminará em falha:
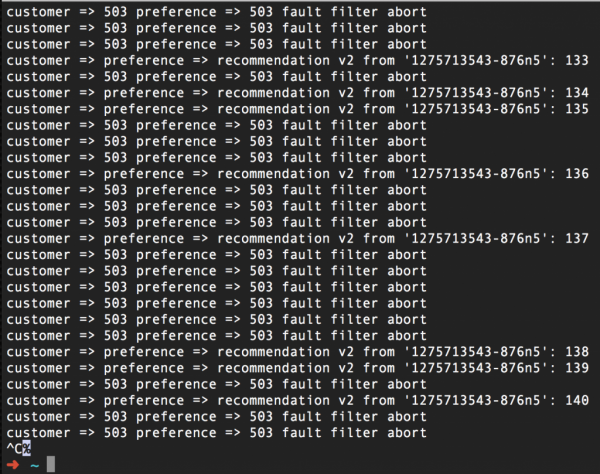
E agora vamos ativar a função Retry do Istio:
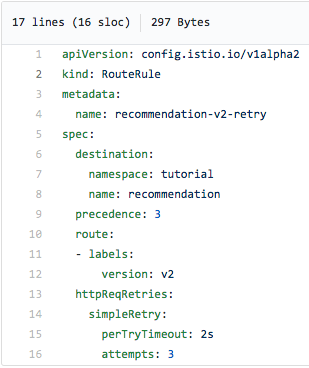
Esta regra de roteamento faz três tentativas com um intervalo de dois segundos e deve reduzir (e idealmente eliminar) os erros 503:
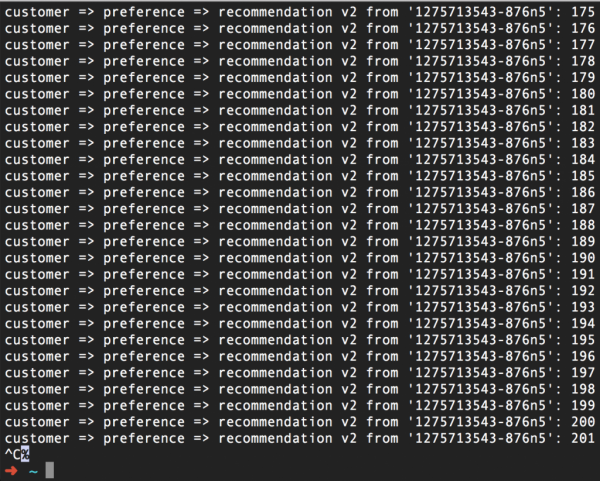
Resumindo: fizemos com que o Istio, em primeiro lugar, gerasse um erro 503 para metade das solicitações. E, em segundo lugar, o mesmo Istio realiza três tentativas de se reconectar ao serviço em caso de erro 503. Como resultado, tudo funciona perfeitamente. Assim, usando a função Retry, cumprimos nossa promessa de não recuar e não desistir.
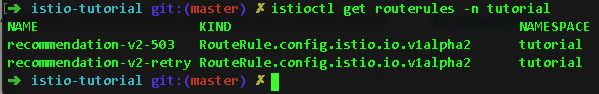
E sim, fizemos isso novamente, sem tocar no código. Tudo o que precisamos foi de duas regras de roteamento do Istio:
Como não decepcionar o usuário ou sete pessoas não esperam
E agora vamos inverter a situação e considerar um cenário em que não devemos recuar e desistir apenas por um tempo fixo. Depois, devemos simplesmente parar de tentar processar a solicitação, para não fazer todos aguardarem por um único serviço que está lento. Em outras palavras, não iremos proteger uma posição perdida, mas recuaremos para uma linha de defesa secundária, para não desapontar o usuário do site e não forçá-lo a ficar na incerteza.
No Istio, é possível definir um timeout para a execução da solicitação. Se o serviço exceder esse timeout, um erro 504 (Gateway Timeout) será retornado – novamente, tudo isso é feito através da configuração do Istio. Mas teremos que adicionar um comando sleep no código-fonte do serviço (e, claro, realizar o rebuild e redeploy), para simular um desempenho lento do serviço. Infelizmente, não há outra maneira.
Assim, inserimos um sleep de três segundos no código do serviço recommendation v2, recompilemos a imagem correspondente e fizemos o redeploy do contêiner, e agora vamos adicionar um timeout usando a seguinte regra de roteamento do Istio:
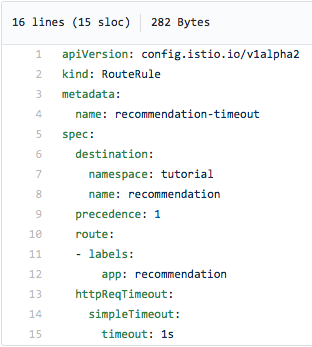
Na captura de tela acima, você pode ver que desistimos de tentar nos conectar ao serviço recommendation se não recebermos uma resposta em um segundo, ou seja, ainda antes de ocorrer o erro 504. Após aplicar essa regra de roteamento (e adicionar um sleep de três segundos no código do serviço recommendation:v2), teremos o seguinte resultado:
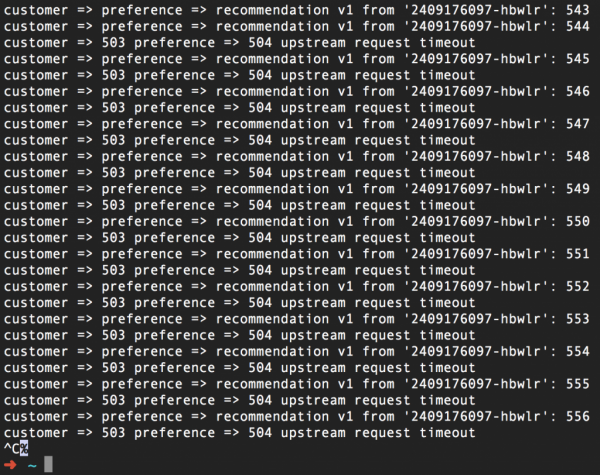
Novamente, reiteramos que o timeout pode ser definido sem alterar o código-fonte. Um benefício adicional aqui é que agora você pode modificar seu código para que ele reaja ao timeout, e testar facilmente essas modificações usando o Istio.
E agora tudo junto
Adicionar um pouco de caos com o Istio é uma excelente maneira de testar seu código e a confiabilidade do seu sistema como um todo. Padrões de fallback, bulkhead e circuit breaker, mecanismos para criar falhas e atrasos artificiais, bem como re-execuções e timeouts, serão muito úteis na construção de sistemas em nuvem resilientes. Em conjunto com o Kubernetes e o Red Hat OpenShift, essas ferramentas ajudarão a enfrentar o futuro com confiança.
Fonte: habr.com
