

Em nossos projetos, utilizamos uma arquitetura de microsserviços. Quando surgem gargalos de desempenho, é comum gastar muito tempo monitorando e analisando logs. Ao registrar os tempos de operações individuais em um arquivo de log, geralmente é difícil entender o que levou à chamada dessas operações, rastrear a sequência de ações ou o deslocamento temporal de uma operação em relação a outra em diferentes serviços.
Para minimizar o trabalho manual, decidimos usar uma das ferramentas de rastreamento. Esta artigo discutirá como e para que pode ser utilizado o rastreamento, além de compartilhar nossa experiência.
Quais problemas podem ser resolvidos com o rastreamento
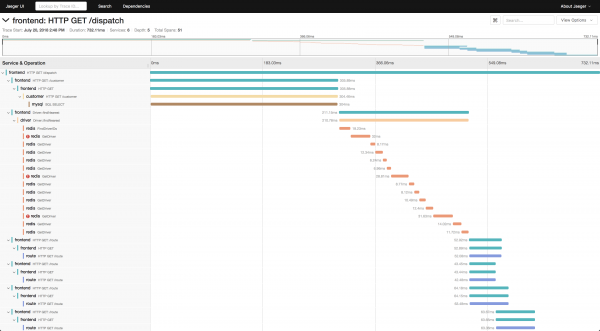
- Identificar gargalos de desempenho tanto dentro de um único serviço quanto em toda a árvore de execução entre todos os serviços envolvidos. Por exemplo:
- Vários chamados curtos consecutivos entre serviços, como em geocodificação ou acesso a banco de dados.
- Longas esperas de entrada/saída, como a transferência de dados pela rede ou leitura de disco.
- Longa análise de dados.
- Operações longas que consomem CPU.
- Trechos de código que não são necessários para obter o resultado final e podem ser removidos ou executados de forma assíncrona.
- Visualizar claramente a sequência em que as chamadas ocorrem e o que acontece quando uma operação é executada.

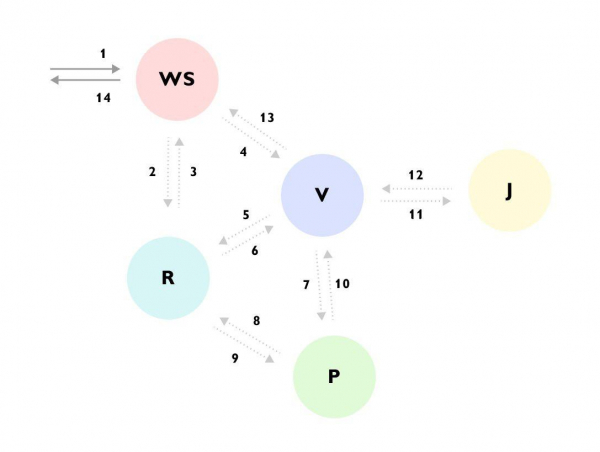
É evidente que, por exemplo, a solicitação chegou ao serviço WS -> o serviço WS complementou os dados através do serviço R -> em seguida, enviou uma solicitação ao serviço V -> o serviço V carregou muitos dados do serviço R -> fez uma chamada ao serviço P -> o serviço P fez mais uma chamada ao serviço R -> o serviço V ignorou o resultado e seguiu para o serviço J -> e só depois retornou a resposta ao serviço WS, enquanto continuava a calcular algo em segundo plano.
Sem esse traço ou documentação detalhada de todo o processo, é muito difícil entender o que está acontecendo ao olhar o código pela primeira vez, sendo que o código está distribuído entre diferentes serviços e oculto por vários beans e interfaces. - Coleta de informações sobre a árvore de execução para análise posterior. Em cada etapa da execução, é possível adicionar informações de rastreamento que estão disponíveis naquele momento e então analisar quais dados de entrada levaram a esse cenário. Por exemplo:
- ID do usuário
- Permissões
- Tipo de método selecionado
- Log ou erro de execução
- Transformar rastros em um subconjunto de métricas e analisar esses dados como métricas.
O que a rastreabilidade pode registrar. Span
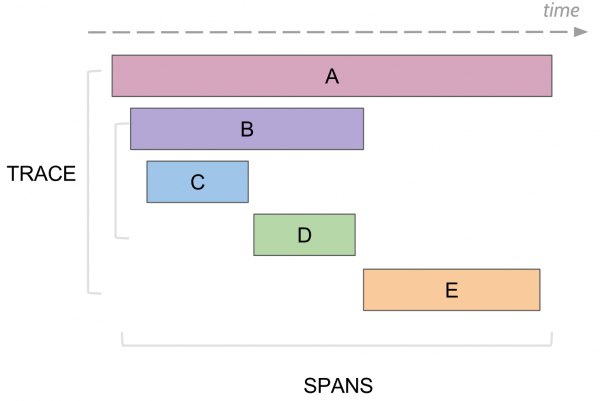
Na rastreabilidade, existe o conceito de span, que é análogo a um único log na console. O span possui:
- Nome, geralmente o nome do método que foi executado.
- Nome do serviço em que o span foi gerado.
- Um ID único próprio.
- Alguma meta informação no formato chave/valor que foi registrada nele. Por exemplo, parâmetros do método ou se o método terminou em erro ou não.
- Hora de início e fim da execução deste span.
- ID do span pai.
Cada span é enviado ao coletor de spans para ser salvo em um banco de dados para visualização posterior assim que sua execução é concluída. Posteriormente, é possível construir uma árvore de todos os spans conectando-os pelo ID do pai. Na análise, podemos encontrar, por exemplo, todos os spans em um determinado serviço que levaram mais de um certo tempo. Em seguida, ao acessar um span específico, ver toda a árvore acima e abaixo desse span.
Opentrace, Jaeger e como implementamos isso em nossos projetos.
Há um padrão geral. , que descreve como e o que deve ser coletado, sem vincular a rastreabilidade a uma implementação específica em qualquer linguagem. Por exemplo, em Java, todo o trabalho com rastros é feito através da API geral do Opentrace, e sob ela pode se esconder, por exemplo, o Jaeger ou uma implementação padrão vazia que não faz nada.
Nós usamos como implementação do Opentrace. Ele consiste em vários componentes:
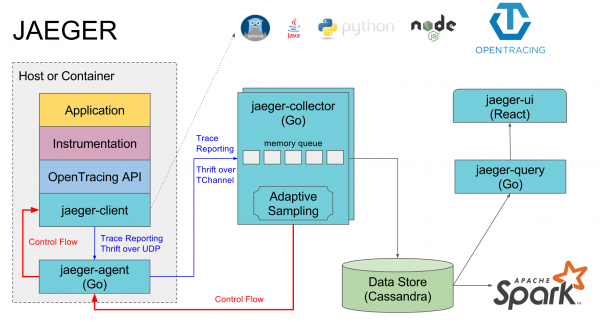
- Jaeger-agent — um agente local, que geralmente está em cada máquina e os serviços registram neste porta padrão local. Se o agente não estiver presente, os rastros de todos os serviços dessa máquina geralmente estão desativados.
- Jaeger-collector — para o qual todos os agentes enviam os rastros coletados, e ele os armazena no banco de dados escolhido.
- Banco de dados — preferencialmente Cassandra, mas usamos Elasticsearch; existem implementações para mais algumas outras bases de dados e uma implementação em memória que não salva nada no disco.
- Jaeger-query — é o serviço que consulta o banco de dados e fornece os rastros já coletados para análise.
- Jaeger-ui — é a interface web para busca e visualização de rastros, que consulta o jaeger-query.
Um componente separado pode ser a implementação do opentrace Jaeger para linguagens específicas, através da qual os spans são enviados ao jaeger-agent.
basicamente envolve a implementação da interface io.opentracing.Tracer, após o que todos os rastros serão enviados para o agente real através dela.
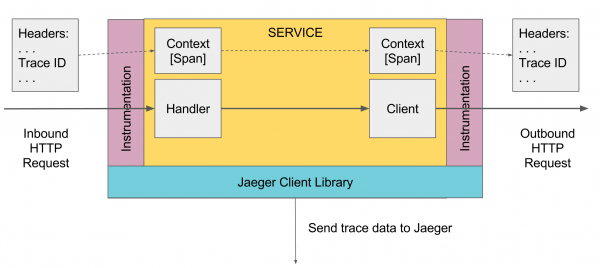
Além disso, para componentes do Spring, é possível integrar e a implementação da Jaeger que configurará automaticamente a rastreamento de tudo que passa por esses componentes, como requisições HTTP em controladores, consultas ao banco de dados via JDBC, etc.
Registro de rastros em Java
Em algum lugar no nível mais alto, o primeiro Span deve ser criado, isso pode ser feito automaticamente, por exemplo, por um controlador do Spring ao receber uma requisição, ou manualmente caso não exista. Em seguida, ele é passado para o Scope inferior. Se algum método abaixo quiser adicionar um Span, ele pega o activeSpan atual do Scope, cria um novo Span e define que seu span pai é o activeSpan recebido, ativando o novo Span. Ao chamar serviços externos, o span ativo atual é passado para eles, e esses serviços criam novos spans vinculados a esse span.
Todo o trabalho é feito através da instância Tracer, que pode ser obtida através do mecanismo DI ou GlobalTracer.get() como uma variável global, caso o mecanismo DI não funcione. Por padrão, se o tracer não foi inicializado, retornará NoopTracer, que não faz nada.
Em seguida, através do tracer, o ScopeManager obtém o scope atual, um novo scope é criado a partir do atual com a vinculação do novo span, depois o Scope criado é fechado, encerrando o span criado e retornando ao estado ativo do Scope anterior. O Scope está vinculado à thread, por isso, na programação multithreading, é importante lembrar de passar o span ativo para outra thread, para a ativação subsequente do Scope da outra thread vinculado a esse span.
io.opentracing.Tracer tracer = ...; // GlobalTracer.get()

void DoSmth () {
   try (Scope scope = tracer.buildSpan("DoSmth").startActive(true)) {
      ...
   }
}
void DoOther () {
    Span span = tracer.buildSpan("someWork").start();
    try (Scope scope = tracer.scopeManager().activate(span, false)) {
        // Realizar operações.
    } catch(Exception ex) {
        Tags.ERROR.set(span, true);
        span.log(Map.of(Fields.EVENT, "error", Fields.ERROR_OBJECT, ex, Fields.MESSAGE, ex.getMessage()));
    } finally {
        span.finish();
    }
}

void DoAsync () {
    try (Scope scope = tracer.buildSpan("ServiceHandlerSpan").startActive(false)) {
        ...
        final Span span = scope.span();
        doAsyncWork(() -> {
            // ETAPA 2 ACIMA: reativar o Span no callback, passando true para
            // startActive() se/quando o Span deve ser finalizado.
            try (Scope scope = tracer.scopeManager().activate(span, false)) {
                ...
            }
        });
    }
}
Para programação multijogos, também há TracedExecutorService e wrappers semelhantes que automaticamente passam o span atual para a thread ao iniciar tarefas assíncronas:
private ExecutorService executor = new TracedExecutorService(
    Executors.newFixedThreadPool(10), GlobalTracer.get()
);
Para chamadas http externas, existe
HttpClient httpClient = new TracingHttpClientBuilder().build();Os problemas que encontramos
- Beans e DI nem sempre funcionam se o tracer não for utilizado em um serviço ou componente, então O Tracer pode não funcionar e será necessário usar GlobalTracer.get().
- Anotações não funcionam se não forem um componente ou serviço, ou se a chamada de método ocorrer de um método adjacente da mesma classe. É preciso ter cuidado, verificar o que funciona e usar a criação manual do trace se @Traced não funcionar. Também é possível adicionar um compilador adicional para anotações java, então devem funcionar em todos os lugares.
- Em versões antigas do spring e spring boot, a autoconfiguração do opentracing spring cloud não funciona devido a bugs no DI, então se quiser que os traços funcionem automaticamente nos componentes do spring, pode-se fazer de maneira semelhante a
- Em groovy, não funciona try with resources, é necessário usar try finally.
- Cada serviço deve ter seu próprio spring.application.name sob o qual os traços serão registrados. Além disso, um nome separado para produção e teste, para não misturá-los.
- Se usar GlobalTracer e tomcat, todos os serviços iniciados nesse tomcat terão um único GlobalTracer, portanto, terão todos um nome de serviço idêntico.
- Ao adicionar traços a um método, deve-se ter certeza de que ele não é chamado em um ciclo várias vezes. É preciso adicionar um traço geral para todas as chamadas, que registrará o tempo total de execução. Caso contrário, uma carga excessiva será criada.
- Uma vez, no jaeger-ui, fizemos solicitações muito grandes para uma grande quantidade de traços e, como não aguardamos a resposta, fizemos novamente. No final, jaeger-query começou a consumir muita memória e a desacelerar o elastic. Um restart do jaeger-query ajudou.
A amostragem, armazenamento e visualização de traços
Existem três tipos :
- Constante que envia e armazena todos os traços.
- Probabilística que filtra traços com uma determinada probabilidade.
- O Ratelimiting que limita o número de traços por segundo. É possível configurar esses parâmetros no cliente, ou no jaeger-agent ou no coletor. Atualmente, usamos const 1 na pilha de validadores, pois o número de requisições não é muito alto, mas elas levam um tempo considerável. No futuro, se isso causar uma carga excessiva no sistema, podemos implementar uma limitação.
Se usar Cassandra, por padrão, ela armazena traços apenas por dois dias. Estamos usando e os traços são mantidos por todo o tempo e não são removidos. Para cada dia, um índice separado é criado, por exemplo, jaeger-service-2019-03-04. Futuramente, será necessário configurar uma limpeza automática de traços antigos.
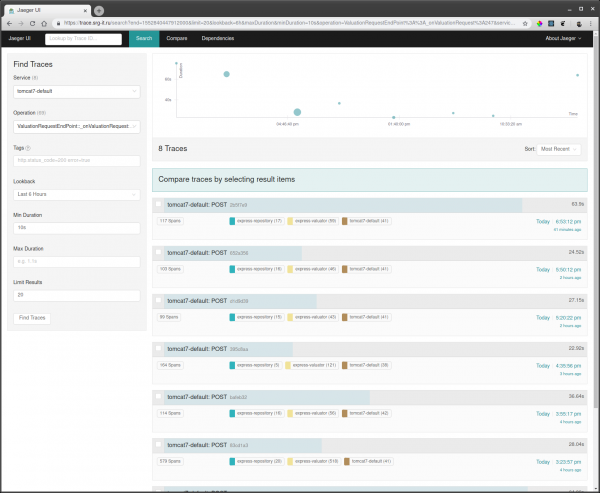
Para visualizar os traços, é preciso:
- Selecionar o serviço pelo qual se deseja filtrar os traços, como tomcat7-default para o serviço que está sendo executado no Tomcat e que não possui um nome próprio.
- Depois, escolha a operação, o intervalo de tempo e o tempo mínimo de operação, como a partir de 10 segundos, para capturar apenas as execuções longas.

- Acesse um dos traços e veja o que estava causando a lentidão.

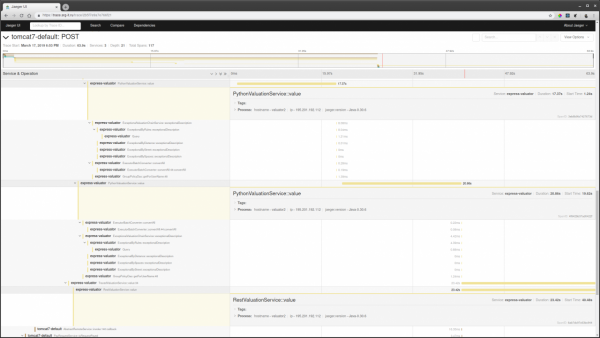
Além disso, se algum id da requisição for conhecido, pode-se encontrar o traço por esse id através da pesquisa por tags, se esse id estiver sendo registrado no span do traço.
Documentação
- Documentação opentracing
- Documentação jaeger
- Integração jaeger java
- Integração spring opentracing
Artigos
- Jaeger Opentracing e Microservices em um projeto real com PHP e Golang
- Evolving Distributed Tracing at Uber Engineering
- Executando o Jaeger Agent em bare metal
Vídeo
- Como usamos Jaeger e Prometheus para fornecer consultas de usuário incrivelmente rápidas — Bryan Boreham
- Introdução: Jaeger — Yuri Shkuro, Uber & Pavol Loffay, Red Hat
- Serghei Iakovlev, "Pequena história de uma grande vitória: OpenTracing, AWS e Jaeger"
Fonte: habr.com
