

Hoje começaremos a estudar o roteamento pelo protocolo OSPF. Este tópico, assim como a discussão sobre o protocolo EIGRP, é um dos mais importantes em todo o curso CCNA. Como vocês podem ver, a seção 2.4 chama-se "Configuração, verificação e solução de problemas de áreas únicas e múltiplas OSPFv2 para o protocolo IPv4 (exceto autenticação, filtragem, agregação manual de rotas, redistribuição, área de buraco negro, rede virtual e LSA)".
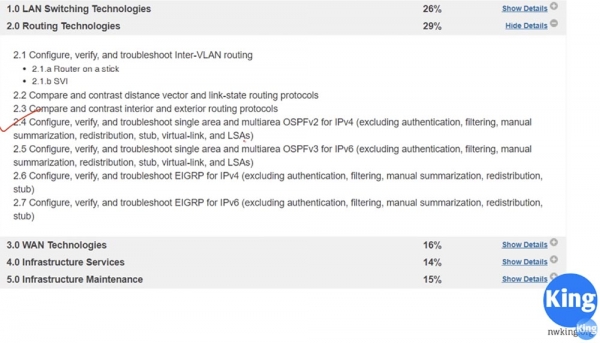
O tópico OSPF é bastante extenso, portanto ocupará 2, possivelmente 3 videoaulas. A aula de hoje será dedicada à parte teórica, onde explicarei o que é esse protocolo em termos gerais e como ele funciona. No próximo vídeo, passaremos para o modo de configuração do OSPF usando o Packet Tracer.
Então, nesta aula, abordaremos três aspectos: o que é OSPF, como ele funciona e o que são as áreas OSPF. Na aula anterior, mencionamos que OSPF é um protocolo de roteamento do tipo Link State, que analisa os canais de comunicação entre os roteadores e toma decisões com base na velocidade desses canais. Um canal longo com maior velocidade, ou seja, maior largura de banda, será priorizado em relação a um canal curto com menor largura de banda.
O protocolo RIP, sendo de vetor de distância, escolherá um caminho de um salto, mesmo que esse canal tenha baixa velocidade, enquanto o protocolo OSPF escolherá uma rota longa de vários saltos, se a velocidade total nessa rota for maior do que a velocidade do tráfego na rota curta.
Mais tarde, abordaremos o algoritmo de tomada de decisão, por enquanto vocês devem lembrar que OSPF é um protocolo de estado de enlace (Link State). Esse padrão aberto foi criado em 1988, permitindo que qualquer fabricante de equipamentos de rede e qualquer provedor de rede pudesse utilizá-lo. Portanto, OSPF é muito mais popular do que EIGRP.
O protocolo OSPF versão 2 suporta apenas o protocolo IPv4, e um ano depois, em 1989, os desenvolvedores anunciaram o lançamento da versão 3, que suporta IPv6. No entanto, a versão três do OSPF totalmente funcional para IPv6 só surgiu em 2008. Por que escolheram o OSPF? Na última aula, aprendemos que esse protocolo de gateway interno realiza a convergência de rotas consideravelmente mais rápido do que o RIP. Este é um protocolo sem classe.
Se você se lembra, o RIP é um protocolo de classe, ou seja, ele não envia informações sobre a máscara de sub-rede, e se encontrar um endereço IP da classe A/24, ele não o aceitará. Por exemplo, se você apresentar um endereço IP no formato 10.1.1.0/24, ele o entenderá como a rede 10.0.0.0, pois não compreende quando uma rede é dividida em sub-redes usando mais de uma máscara de sub-rede.
O OSPF é um protocolo seguro. Por exemplo, se dois roteadores trocam informações OSPF, você pode configurar a autenticação de forma que a informação só pode ser compartilhada com o roteador vizinho após a digitação de uma senha. Como já foi mencionado, este é um padrão aberto, portanto, o OSPF é utilizado por muitos fabricantes de equipamentos de rede.
De forma global, o OSPF é um mecanismo de troca de anúncios de estado de link, ou LSA (Link State Advertisement). As mensagens LSA são geradas pelo roteador e contêm muitas informações: um identificador único do roteador (router-id), dados sobre as redes conhecidas pelo roteador, dados sobre seus custos e assim por diante. Todas essas informações são necessárias para que o roteador tome decisões de roteamento.
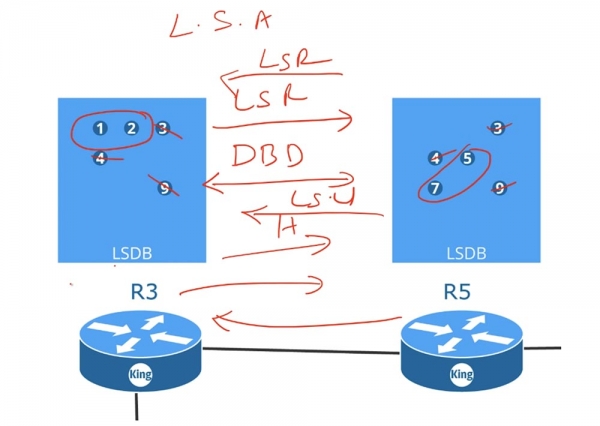
O roteador R3 envia suas informações LSA para o roteador R5, e o roteador R5 compartilha suas informações LSA com o R3. Esses LSA representam uma estrutura de dados que forma o banco de dados de estado dos links (Link State Data Base, ou LSDB). O roteador coleta todos os LSA recebidos e os coloca em sua LSDB. Após ambos os roteadores terem criado seus bancos de dados, eles trocam mensagens Hello, que servem para a descoberta de vizinhos, e iniciam o processo de comparação de suas LSDB.
O roteador R3 envia ao roteador R5 uma mensagem DBD, ou 'descrição do banco de dados', e o R5 envia seu DBD para o roteador R3. Essas mensagens contêm os índices LSA que estão nos bancos de dados de cada roteador. Ao receber o DBD, o roteador R3 envia uma solicitação de estado de rede LSR para o roteador R5, na qual diz: 'já possuo as mensagens 3, 4 e 9, portanto, envie-me apenas 5 e 7'.
Da mesma forma, o R5 informa o terceiro roteador: "tenho informações 3, 4 e 9, então me envie 1 e 2". Ao receber os pedidos LSR, os roteadores enviam pacotes de atualização de estado da rede LSU em resposta, ou seja, em resposta ao seu LSR, o terceiro roteador recebe LSU do roteador R5. Após atualizarem seus bancos de dados, todos eles, mesmo que você tenha 100 roteadores, terão os mesmos bancos de dados LSDB. Assim que os bancos de dados LSDB forem criados nos roteadores, cada um deles conhecerá toda a rede como um todo. O protocolo OSPF utiliza o algoritmo Shortest Path First para criar a tabela de roteamento, portanto, a sincronização do LSDB de todos os dispositivos na rede é uma condição crucial para seu funcionamento correto.
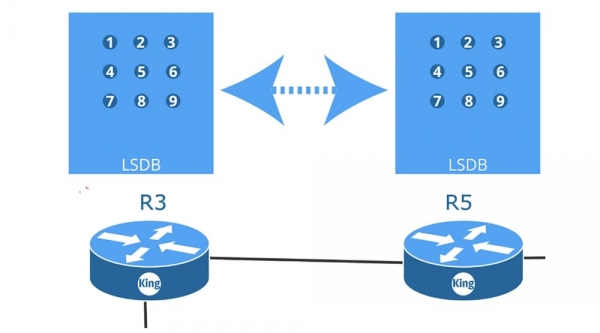
No diagrama apresentado estão 9 roteadores, cada um trocando mensagens LSR, LSU, etc., com seus vizinhos. Todos eles estão interconectados por interfaces do tipo p2p, ou "ponto a ponto", que suportam o funcionamento do protocolo OSPF, e interagem entre si visando criar LSDB idênticos.
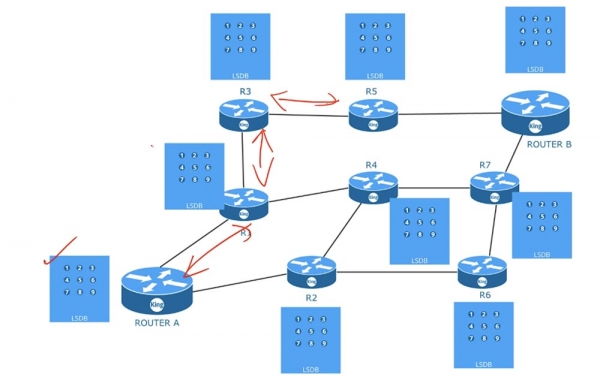
Assim que os bancos de dados estiverem sincronizados, cada roteador, utilizando o algoritmo de caminho mais curto, formará sua tabela de roteamento. As tabelas desses roteadores serão diferentes. Ou seja, todos os roteadores utilizam os mesmos LSDB, mas criam tabelas de roteamento com base em suas próprias considerações sobre os caminhos mais curtos. Para usar esse algoritmo, o OSPF necessita de atualizações regulares do banco de dados LSDB.
Portanto, para seu funcionamento, o OSPF deve primeiro garantir 3 condições: encontrar vizinhos, criar e atualizar o LSDB e formar a tabela de roteamento. Para atender à primeira condição, o administrador de rede pode precisar configurar manualmente o router-id, os tempos ou a máscara wildcard. No próximo vídeo, abordaremos a configuração do dispositivo para operar com OSPF, mas até lá você deve saber que esse protocolo usa uma máscara invertida, e se ela não corresponder, se suas sub-redes não coincidirem ou se a autenticação não for compatível, a vizinhança entre os roteadores não será estabelecida. Portanto, ao solucionar problemas de operação do OSPF, você deve descobrir por que essa vizinhança não se forma, ou seja, verificar a correspondência dos parâmetros mencionados acima.
Como administrador de rede, você não participa do processo de criação do LSDB. A atualização das bases de dados ocorre automaticamente após a criação da vizinhança dos roteadores, assim como a construção das tabelas de roteamento. Tudo isso é feito pelo próprio dispositivo, configurado para operar com o protocolo OSPF.
Vamos considerar um exemplo. Temos 2 roteadores, a quem atribuí para simplificação os identificadores RID 1.1.1.1 e 2.2.2.2. Assim que os conectamos, o link imediatamente passa para o estado up, porque antes eu configurei esses roteadores para funcionar com OSPF. Assim que o canal de comunicação for formado, o roteador A imediatamente enviará um pacote Hello para o segundo. Este pacote conterá informações de que este roteador ainda não "viu" ninguém nesse canal, pois está enviando Hello pela primeira vez, bem como seu próprio identificador, dados sobre a rede conectada a ele e outras informações que ele pode compartilhar com o vizinho.
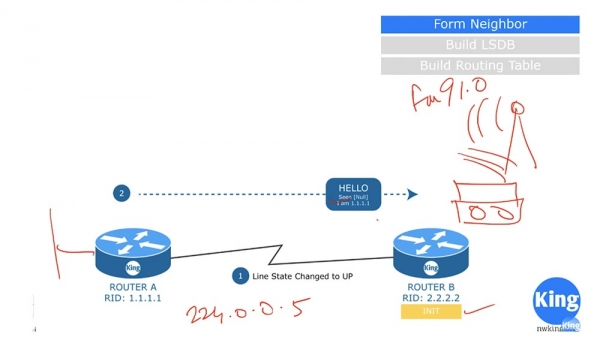
Ao receber esse pacote, o roteador B dirá: "vejo que neste canal de comunicação há um candidato potencial à vizinhança pelo protocolo OSPF" e mudará para o estado de inicialização Init state. O pacote Hello não é uma mensagem unicast ou broadcast, é um pacote multicast, enviado para o endereço IP multicast OSPF 224.0.0.5. Algumas pessoas perguntam qual é a máscara de sub-rede para multicast. A questão é que o multicast não tem máscara de sub-rede, ele é transmitido como um sinal de rádio, que pode ser ouvido por todos os dispositivos configurados para sua frequência. Por exemplo, se você deseja ouvir uma rádio FM transmitindo na frequência 91,0, você precisa sintonizar seu receptor nessa frequência.
Da mesma forma, o roteador B está configurado para receber mensagens para o endereço multicast 224.0.0.5. Ouvindo esse canal, ele recebe o pacote Hello enviado pelo roteador A e responde com sua própria mensagem.
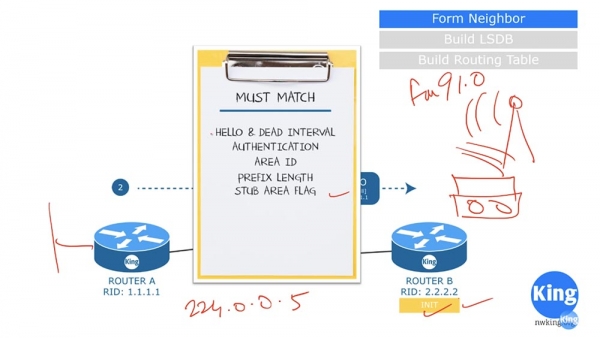
No entanto, a vizinhança só pode ser estabelecida se a resposta de B atender a um conjunto de critérios. O primeiro critério é que a frequência de envio das mensagens Hello e o intervalo de espera pela resposta a essa mensagem, o Dead Interval, devem coincidir em ambos os roteadores. Normalmente, o Dead Interval é igual a alguns valores do temporizador Hello. Assim, se o Hello Timer do roteador A for de 10 s, e o roteador B lhe enviar uma mensagem após 30 s, considerando que o Dead Interval seja de 20 s, a vizinhança não será estabelecida.
O segundo critério é que ambos os roteadores devem usar o mesmo tipo de autenticação. Portanto, as senhas de autenticação também devem ser idênticas.
O terceiro critério é a correspondência dos identificadores de zona Arial ID, e o quarto é a correspondência do comprimento do prefixo da rede. Se o roteador A reportar o prefixo /24, então o roteador B também deve ter o prefixo da rede /24. No próximo vídeo, iremos aprofundar isso; por enquanto, devo dizer que não se trata de uma máscara de sub-rede, aqui os roteadores utilizam uma máscara coringa Wildcard mask. E claro, as flags da área stub Stub area também devem coincidir, se os roteadores estiverem nessa área.
Após a verificação desses critérios, caso eles coincidam, o roteador B envia seu pacote Hello ao roteador A. Diferente da mensagem A, o roteador B informa que percebeu o roteador A e se apresenta.
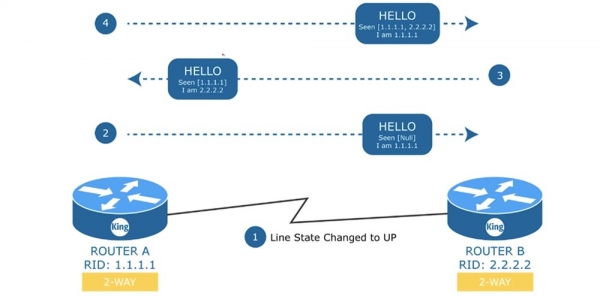
Em resposta a essa mensagem, o roteador A envia novamente um Hello ao roteador B, confirmando que também viu o roteador B, e que o canal de comunicação entre eles consiste nos dispositivos 1.1.1.1 e 2.2.2.2, enquanto ele mesmo é o dispositivo 1.1.1.1. Esta é uma fase muito importante na formação da vizinhança. Neste caso, é utilizada uma conexão bidirecional 2-WAY, mas o que acontecerá se tivermos um switch com uma rede distribuída com 4 roteadores? Em tal ambiente "partilhado", um dos roteadores deve atuar como o roteador designado Designated router D.R., e o segundo como o roteador de reserva Backup designated router B.D.R.
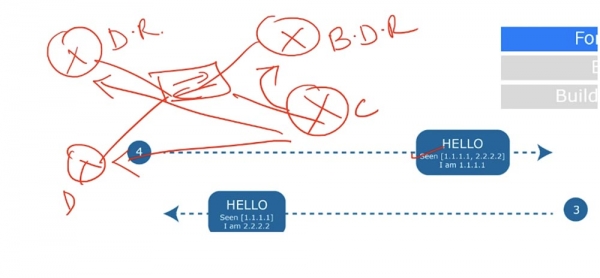
Cada um desses dispositivos formará uma conexão Full connection, ou estado de plena adjacência; mais tarde, veremos o que isso significa, no entanto, esse tipo de conexão será estabelecido apenas com D.R. e B.D.R, enquanto os dois roteadores inferiores D e B ainda se comunicarão usando a configuração de conexão bidirecional "point-to-point".
Ou seja, com D.R. e B.D.R, todos os roteadores estabelecem uma relação de plena vizinhança, enquanto entre si mantêm uma conexão do tipo point-to-point. Isso é muito importante, pois em uma conexão bidirecional de dispositivos adjacentes, todos os parâmetros do pacote Hello devem coincidir. No nosso caso, tudo coincide, portanto, os dispositivos formam a vizinhança sem problemas.
Assim que a comunicação bidirecional for estabelecida, o roteador A envia ao roteador B um pacote chamado Database Description, ou "descrição da base de dados", e passa para o estado ExStart — início da troca, ou esperando a carga. O Database Descriptor é uma informação similar ao sumário de um livro – uma lista de tudo o que existe na base de dados de roteamento. Em resposta, o roteador B envia sua descrição de base de dados de volta ao roteador A e muda para o estado de troca de informações sobre canais Exchange. Se no estado Exchange o roteador detectar que falta alguma informação na sua base de dados, ele mudará para o estado de carregamento LOADING e começará a trocar mensagens LSR, LSU e LSA com o vizinho.
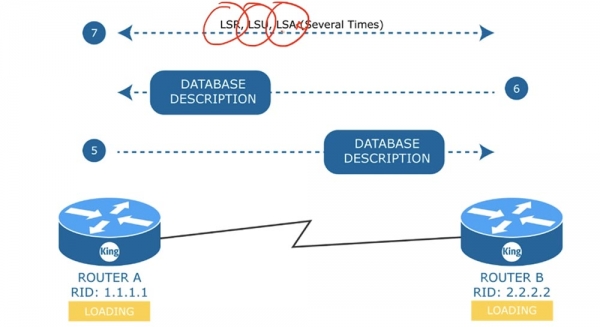
Assim, o roteador A enviará um LSR ao vizinho, que responderá com um pacote LSU, ao que o roteador A responderá ao roteador B com uma mensagem LSA. Essa troca ocorrerá tantas vezes quantas forem necessárias para que os dispositivos queiram compartilhar mensagens LSA. O estado LOADING significa que a atualização completa da base de dados LSA ainda não ocorreu. Após carregar todos os dados, ambos os dispositivos mudarão para o estado de adjacência total FULL.
Vale lembrar que, em uma conexão bidirecional, os dispositivos estão simplesmente no estado de vizinhança, e o estado de adjacência total só é possível entre os roteadores D.R. e B.D.R. Isso significa que cada roteador informa o D.R. sobre alterações na rede, e todos os roteadores ficam sabendo dessas mudanças pelo D.R.
A escolha do D.R. e B.D.R é uma questão importante. Vamos considerar como ocorre a escolha do D.R. em um ambiente geral. Suponha que, em nosso esquema, haja três roteadores e um switch. Primeiro, os dispositivos OSPF comparam as prioridades nas mensagens Hello, em seguida, comparam os IDs dos Roteadores.
O dispositivo com a maior prioridade torna-se o D.R. Se as prioridades de dois dispositivos coincidirem, então entre esses dois é escolhido o dispositivo com o maior Router ID, que se torna o D.R.
O roteador designado como B.D.R é o dispositivo com a segunda prioridade mais alta ou com o segundo Router ID mais alto. Se o D.R. falhar, ele será imediatamente substituído pelo B.D.R. Este começará a atuar como D.R., enquanto o sistema selecionará outro B.D.R.
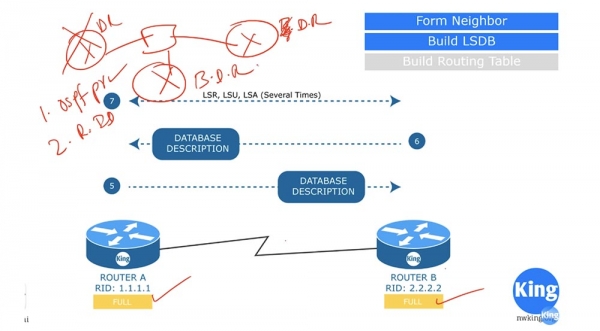
Espero que você tenha entendido a escolha do D.R. e B.D.R. Se não, voltarei a abordar esse assunto em um dos próximos vídeos e explicarei esse processo.
Assim, examinamos o que são Hello, a descrição do banco de dados Database Descriptor e as mensagens LSR, LSU e LSA. Antes de prosseguirmos para o próximo tópico, vamos falar um pouco sobre o custo do OSPF.
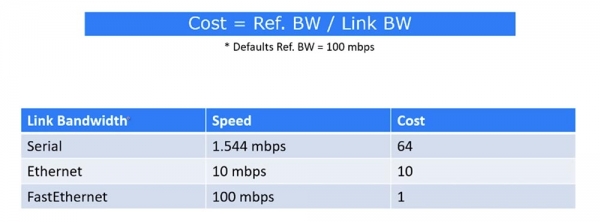
Na Cisco, o custo do caminho é calculado pela fórmula da razão entre a largura de banda de referência (Reference bandwidth), que é padrão de 100 Mbps, e o custo do canal. Por exemplo, ao conectar dispositivos através de uma porta serial, a velocidade é de 1.544 Mbps e o custo será 64. Usando uma conexão Ethernet com velocidade de 10 Mbps, o custo é 10, enquanto o custo de uma conexão FastEthernet a 100 Mbps é igual a 1.
Ao usar o Gigabit Ethernet, temos uma velocidade de 1000 Mbps; no entanto, neste caso, a velocidade é sempre considerada igual a 1. Portanto, se você tiver Gigabit Ethernet em sua rede, deverá alterar o valor padrão da Ref. BW para 1000. Nesse caso, o custo será 1 e toda a tabela será recalculada com um aumento dos valores de custo em 10 vezes. Depois de formarmos a vizinhança e construirmos o banco de dados LSDB, passamos para a construção da tabela de roteamento.
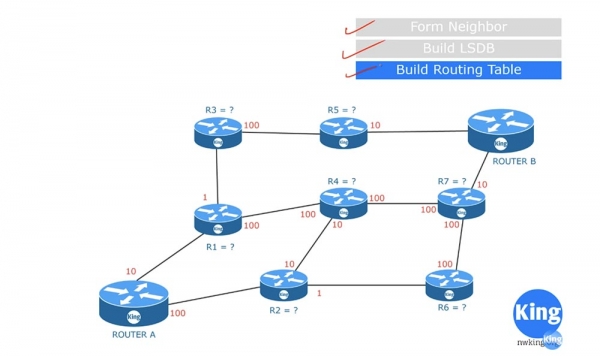
Após a obtenção do LSDB, cada um dos roteadores começa a formar sua lista de rotas usando o algoritmo SPF. Em nosso diagrama, o roteador A criará uma tabela para si mesmo. Por exemplo, ele calcula o custo da rota A-R1 e determina que é igual a 10. Para facilitar a compreensão do diagrama, suponha que o roteador A determina a rota ideal para o roteador B. O custo da conexão A-R1 é 10, a conexão A-R2 é 100 e o custo da rota A-R3 é 11, ou seja, a soma da rota A-R1(10) e R1-R3(1).
Se o roteador A quiser chegar ao roteador R4, ele pode fazê-lo por meio da rota A-R1-R4 ou pela rota A-R2-R4, sendo que, em ambos os casos, o custo das rotas será o mesmo: 10+100 = 100+10 = 110. A rota A-R6 custará 100+1 = 101, o que já é melhor. Em seguida, é considerado o caminho para o roteador R5 pela rota A-R1-R3-R5, cujo custo será 10+1+100 = 111.
O caminho para o roteador R7 pode ser feito por duas rotas: A-R1-R4-R7 ou A-R2-R6-R7. O custo da primeira será 210 e o da segunda será 201, portanto, deve-se escolher 201. Assim, para alcançar o roteador B, o roteador A pode usar 4 rotas.
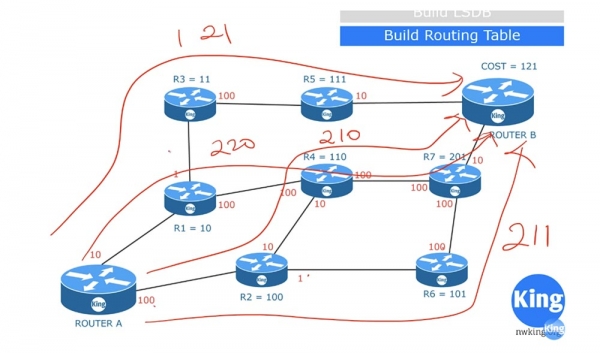
O custo do caminho A-R1-R3-R5-B será de 121. O caminho A-R1-R4-R7-B custará 220. O caminho A-R2-R4-R7-B vale 210, enquanto A-R2-R6-R7-B tem um custo de 211. Com base nisso, o roteador A escolherá o caminho com o menor custo, que é 121, e o incluirá na tabela de roteamento. Este é um esquema muito simplificado de como funciona o algoritmo SPF. Na realidade, a tabela não contém apenas os identificadores dos roteadores que compõem o caminho ideal, mas também os identificadores das portas que os conectam e toda a outra informação necessária.
Vamos considerar outro tópico relacionado às áreas de roteamento. Normalmente, ao configurar dispositivos OSPF, todos eles estão em uma única área comum.
O que acontecerá se um dispositivo conectado ao roteador R3 de repente falhar? O roteador R3 imediatamente começará a enviar para os roteadores R5 e R1 uma mensagem informando que o canal com esse dispositivo não está mais funcionando, e todos os roteadores começarão a trocar atualizações sobre esse evento.
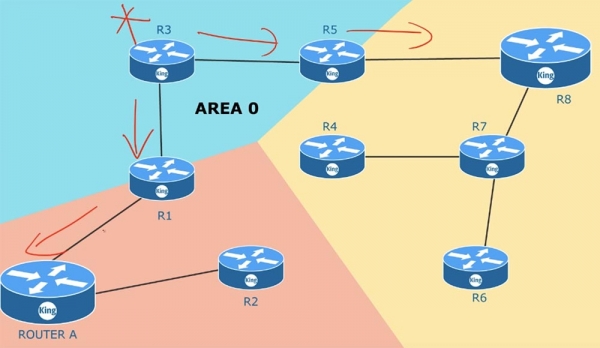
Se você tem 100 roteadores, todos eles atualizarão as informações sobre o estado dos canais, pois estão em uma única área comum. O mesmo acontecerá se um dos roteadores vizinhos falhar – todos os dispositivos na área trocarão atualizações LSA. Após essa troca de mensagens, a topologia da rede mudará. Assim que isso acontecer, o SPF recalculará as tabelas de roteamento de acordo com as novas condições. Este é um processo muito abrangente, e se você tiver mil dispositivos em uma única área, precisará monitorar o tamanho da memória dos roteadores para que seja suficiente para armazenar todos os LSA e a enorme base de dados do estado dos canais LSDB. Assim que ocorrerem mudanças em alguma parte da área, o algoritmo SPF imediatamente recalculará as rotas. Por padrão, o LSA é atualizado a cada 30 minutos. Esse processo não ocorre simultaneamente em todos os dispositivos, mas, de qualquer forma, as atualizações são realizadas por cada roteador com a periodicidade de 30 minutos. Quanto mais dispositivos de rede houver, maior será a necessidade de memória e tempo para atualizar o LSDB.
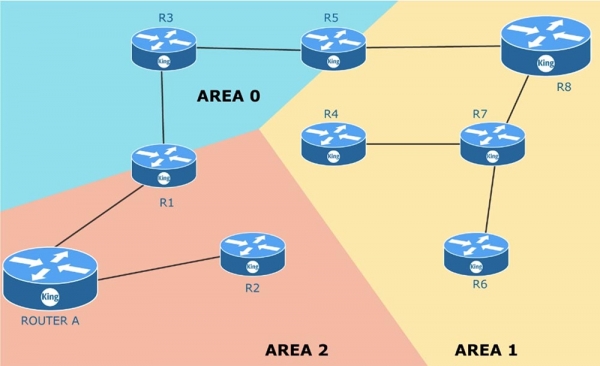
Você pode resolver esse problema dividindo uma zona comum em várias zonas separadas, ou seja, utilizando múltiplas zonas. Para isso, você deve ter um plano ou um esquema de toda a rede que está gerenciando. A zona zero, AREA 0, é sua zona principal. É o ponto de conexão com a rede externa, como a saída para a Internet. Ao criar novas zonas, você deve seguir a regra de que cada zona deve ter um roteador de borda ABR (Area Border Router). O roteador de borda tem uma interface em uma zona e a segunda interface em outra zona. Por exemplo, o roteador R5 tem interfaces na zona 1 e na zona 0. Como mencionei, cada uma das zonas deve estar conectada à zona zero, ou seja, deve ter um roteador de borda, um dos interfaces do qual está conectado à AREA 0.
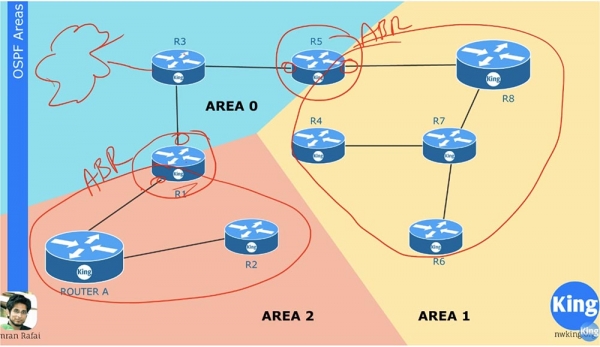
Suponha que a conexão R6-R7 falhou. Nesse caso, a atualização LSA se espalhará apenas pela zona AREA 1 e afetará apenas essa zona. Os dispositivos na zona 2 e na zona 0 nem saberão disso. O roteador de borda R5 realiza a sumarização das informações sobre o que acontece na sua zona e envia para a zona principal AREA 0 as informações resumidas sobre o estado da rede. Os dispositivos em uma zona não precisam saber sobre todas as mudanças de LSA dentro de outras zonas, porque o roteador ABR encaminhará as informações resumidas sobre as rotas de uma zona para outra.
Se você ainda não entendeu completamente o conceito de zonas, poderá aprender mais nas próximas aulas, quando abordarmos a configuração da roteação OSPF e analisarmos alguns exemplos.
Obrigado por estar conosco. Você gosta dos nossos artigos? Quer ver mais materiais interessantes? Apoie-nos fazendo um pedido ou recomendando a amigos, 30% de desconto para usuários do Habra em um análogo único de servidores de entrada, que foi desenvolvido para você: (disponíveis opções com RAID1 e RAID10, até 24 núcleos e até 40GB DDR4).
Dell R730xd pela metade do preço? Somente conosco na Holanda! Dell R420 — 2x E5-2430 2.2Ghz 6C 128GB DDR3 2x960GB SSD 1Gbps 100TB — a partir de $99! Leia sobre
Fonte: habr.com
