

Para dominar completamente o Kubernetes, é necessário conhecer várias maneiras de escalar os recursos do cluster: por , esta é uma das principais tarefas do Kubernetes. Preparámos uma visão geral de alto nível dos mecanismos de escalabilidade horizontal e vertical, bem como das recomendações para usá-los de forma eficaz.
O artigo foi traduzido por uma equipe que implementou a escalabilidade automática em .
Por que é importante considerar a escalabilidade
— uma ferramenta para gestão de recursos e orquestração. Certamente, é interessante brincar com recursos legais de implementação, monitoramento e gestão de pods (um pod é um grupo de contêineres iniciados em resposta a uma solicitação).
No entanto, também é necessário considerar algumas questões:
- Como escalar módulos e aplicações?
- Como manter os contêineres funcionando e eficientes?
- Como responder a mudanças contínuas no código e nas cargas de trabalho dos usuários?
Configurar clusters Kubernetes para equilibrar recursos e desempenho pode ser uma tarefa complexa, exigindo conhecimentos especializados sobre o funcionamento interno do Kubernetes. A carga de trabalho do seu aplicativo ou serviços pode variar ao longo do dia ou até mesmo em uma única hora, por isso o balanceamento deve ser visto como um processo contínuo.
Níveis de escalabilidade automática do Kubernetes
Uma escalabilidade eficaz requer coordenação entre dois níveis:
- Nível dos pods, que inclui a escalabilidade horizontal (Horizontal Pod Autoscaler, HPA) e vertical (Vertical Pod Autoscaler, VPA). Esse nível diz respeito à escalabilidade dos recursos existentes para os seus contêineres.
- Nível do cluster, que é gerenciado pelo sistema de escalabilidade de cluster (Cluster Autoscaler, CA), que aumenta ou diminui o número de nós dentro do cluster.
Módulo de escalabilidade horizontal (HPA)
Como o nome sugere, o HPA escala o número de réplicas de pods. Como gatilhos para alterar o número de réplicas, a maioria dos DevOps utiliza a carga da CPU e a memória. No entanto, é possível escalar o sistema com base em , a combinação delas ou até mesmo .
Diagrama de funcionamento de alto nível do HPA:
- O HPA verifica continuamente os valores das métricas especificadas durante a configuração, com um intervalo padrão de 30 segundos.
- O HPA tenta aumentar o número de pods se um limite específico for alcançado.
- O HPA atualiza o número de réplicas dentro do controlador de implantação/replicação.
- O controlador de implantação/replicação, então, implementa todos os pods adicionais necessários.
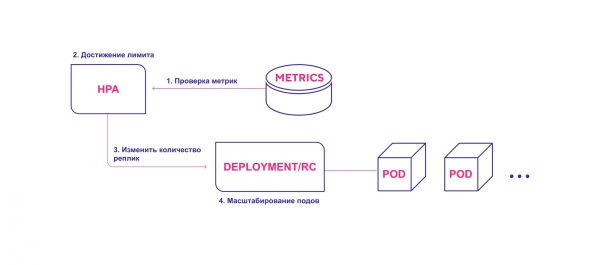
O HPA inicia o processo de implantação de pods ao atingir o limite das métricas.
Ao usar o HPA, considere o seguinte:
- O intervalo de verificação padrão do HPA é de 30 segundos. Isso é definido pelo parâmetro. horizontal-pod-autoscaler-sync-period no gerenciador de controlador.
- O erro relativo padrão é de 10%.
- Após o último aumento do número de pods, o HPA espera pela estabilização das métricas por três minutos. Esse intervalo é definido pelo parâmetro. horizontal-pod-autoscaler-upscale-delay.
- Após a última redução do número de pods, o HPA aguarda pela estabilização por cinco minutos. Esse intervalo é definido pelo parâmetro. horizontal-pod-autoscaler-downscale-delay.
- O HPA funciona melhor com objetos de implantação, em vez de controladores de replicação. A autoescalabilidade horizontal é incompatível com atualizações contínuas (rolling updates), que manipulam diretamente os controladores de replicação. Ao implantar, o número de réplicas depende diretamente dos objetos de implantação.
Escalabilidade vertical de pods
A escalabilidade vertical (VPA) aloca mais (ou menos) tempo de CPU ou memória para pods existentes. É adequada para pods com estado (stateful) ou sem estado (stateless), mas é principalmente destinada a serviços stateful. No entanto, você pode aplicar o VPA também a módulos sem estado, se precisar ajustar automaticamente a quantidade de recursos inicialmente alocados.
O VPA também responde a eventos OOM (out of memory, falta de memória). Para alterar o tempo de CPU e a quantidade de memória, é necessário reiniciar os pods. Ao reiniciar, o VPA respeita o orçamento de distribuição (), para garantir o número mínimo necessário de pods.
Você pode definir o volume mínimo e máximo de recursos para cada módulo. Assim, é possível limitar o máximo de memória alocada a 8 GB. Isso é útil se os nós atuais não puderem alocar mais de 8 GB de memória por contêiner. Especificações detalhadas e o mecanismo de funcionamento estão descritos em .
Além disso, o VPA possui uma função interessante de recomendações (Recomendador VPA). Ele monitora o uso de recursos e eventos de OOM de todos os módulos para sugerir novos valores de memória e tempo de CPU com base em um algoritmo inteligente considerando métricas históricas. Também há uma interface de API que aceita um descritor de pod e retorna os valores de recursos sugeridos.
Vale ressaltar que o Recomendador VPA não monitora o "limite" de recursos. Isso pode resultar em um módulo monopolizando recursos dentro dos nós. É preferível definir um valor limite no nível do namespace para evitar um consumo excessivo de memória ou tempo de CPU.
Esquema de funcionamento de alto nível do VPA:
- O VPA verifica continuamente os valores das métricas especificadas durante a instalação, com um intervalo padrão de 10 segundos.
- Se o limite definido for atingido, o VPA tentará alterar a quantidade alocada de recursos.
- O VPA atualiza a quantidade de recursos dentro do controlador de implantação/reprodução.
- Ao reiniciar os módulos, todos os novos recursos são aplicados às instâncias criadas.
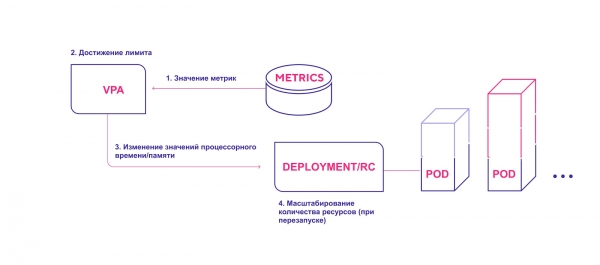
O VPA adiciona a quantidade necessária de recursos
Considere os seguintes pontos ao usar o VPA:
- A escalabilidade requer o reinício obrigatório do pod. Isso é necessário para evitar um funcionamento instável após as alterações. Para garantir a confiabilidade, os módulos são reiniciados e distribuídos pelos nós com base nos novos recursos alocados.
- O VPA e o HPA ainda são incompatíveis entre si e não podem operar nos mesmos pods. Se você estiver usando ambos os mecanismos de escalabilidade em um mesmo cluster, certifique-se de que as configurações não permitam que sejam ativados nos mesmos objetos.
- O VPA configura as solicitações dos contêineres para recursos com base apenas no uso passado e atual. Ele não estabelece limites de uso de recursos. Podem ocorrer problemas de desempenho inadequados em aplicativos que começam a consumir cada vez mais recursos, levando o Kubernetes a desligar este pod.
- O VPA ainda está em fase inicial de desenvolvimento. Esteja preparado para que o sistema possa passar por algumas mudanças em breve. Você pode ler sobre e . Assim, há planos para implementar a cooperação entre VPA e HPA, bem como a implantação de módulos junto com políticas de escalonamento vertical para eles (por exemplo, uma etiqueta especial 'requires VPA').
Escalonamento automático do cluster Kubernetes
O escalonamento automático do cluster (Cluster Autoscaler, CA) altera o número de nós com base na quantidade de pods pendentes. O sistema verifica periodicamente a presença de pods pendentes e aumenta o tamanho do cluster, se mais recursos forem necessários e se o cluster não ultrapassar os limites estabelecidos. O CA interage com o provedor de nuvem, solicitando nós adicionais ou liberando nós ociosos. A primeira versão pública do CA foi lançada no Kubernetes 1.8.
Diagrama de alto nível do funcionamento do CA:
- O CA verifica a presença de pods em estado de espera a cada 10 segundos por padrão.
- Se um ou mais pods estiverem em estado de espera devido à falta de recursos disponíveis no cluster para alocação, ele tenta provisionar um ou mais nós adicionais.
- Quando o provedor de nuvem provisiona o nó necessário, este se une ao cluster e está pronto para atender aos pods.
- O scheduler do Kubernetes aloca pods pendentes no novo nó. Se, após isso, alguns pods ainda permanecerem em espera, o processo se repete e novos nós são adicionados ao cluster.
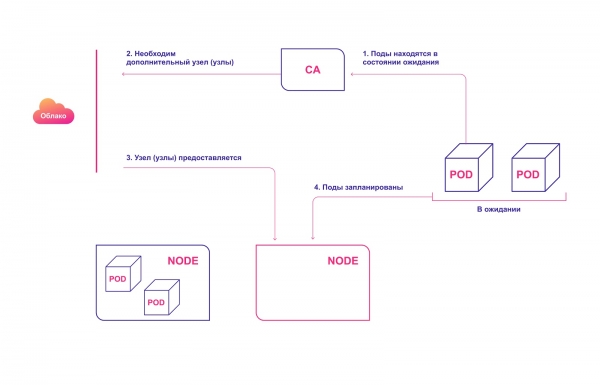
Alocação automática de nós do cluster na nuvem
Considere o seguinte ao usar o CA:
- O CA garante que todos os pods no cluster tenham espaço para execução, independentemente da carga do processador. Além disso, ele tenta garantir que não haja nós desnecessários no cluster.
- O CA registra a necessidade de dimensionamento em cerca de 30 segundos.
- Depois que o nó se torna desnecessário, o CA espera por 10 minutos por padrão antes de escalonar o sistema.
- No sistema de escalonamento automático, existe o conceito de expansores (expanders). São diferentes estratégias para escolher o grupo de nós onde novos serão adicionados.
- Use a opção com responsabilidade cluster-autoscaler.kubernetes.io/safe-to-evict (true). Se você criar muitos pods ou se muitos deles estiverem espalhados por todos os nós, você perderá significativamente a capacidade de reduzir a escala do cluster.
- Use , para evitar a remoção de pods, o que pode fazer com que parte do seu aplicativo falhe completamente.
Como os sistemas de escalonamento automático interagem entre si
Para uma harmonia ideal, deve-se aplicar escalonamento automático tanto no nível dos pods (HPA/VPA) quanto no nível do cluster. Eles interagem relativamente bem entre si:
- O HPA ou VPA atualizam as réplicas dos pods ou os recursos atribuídos aos pods existentes.
- Se faltarem nós para o escalonamento programado, o CA perceberá a existência de pods em estado de espera.
- O CA aloca novos nós.
- Os módulos são distribuídos entre os novos nós.
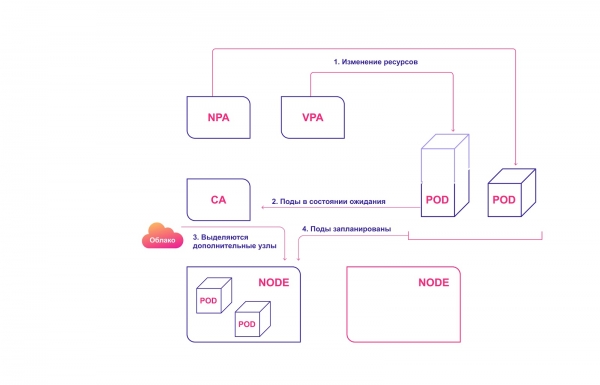
Sistema conjunto de escalonamento do Kubernetes
Erros típicos no escalonamento automático do Kubernetes
Existem vários problemas típicos que os devops enfrentam ao tentar aplicar escalonamento automático.
O HPA e o VPA dependem de métricas e alguns dados históricos. Se não houver recursos suficientes alocados, os módulos serão reduzidos e não conseguirão gerar métricas. Nesse caso, o escalonamento automático nunca ocorrerá.
A própria operação de escalonamento é sensível ao tempo. Queremos que os módulos e o cluster escalonem rapidamente — antes que os usuários percebam qualquer problema e falhas. Portanto, deve-se considerar o tempo médio de escalonamento de pods e do cluster.
O cenário ideal é de 4 minutos:
- 30 segundos. Atualização das métricas-alvo: 30−60 segundos.
- 30 segundos. O HPA verifica os valores das métricas: 30 segundos.
- Menos de 2 segundos. Módulos pod criados e passando para o estado de espera: 1 segundo.
- Menos de 2 segundos. O CA vê os módulos em espera e faz chamadas para preparar os nós: 1 segundo.
- 3 minutos. O provedor de nuvem aloca nós. K8s aguarda até que estejam prontos: até 10 minutos (dependendo de vários fatores).
O pior (mais realista) cenário é de 12 minutos:
- 30 segundos. Atualização das métricas alvo.
- 30 segundos. HPA verifica os valores das métricas.
- Menos de 2 segundos. Os módulos pod são criados e passam para o estado de espera.
- Menos de 2 segundos. CA vê os módulos pendentes e envia solicitações para a preparação dos nós.
- 10 minutos. O provedor de nuvem aloca nós. K8s aguarda até que estejam prontos. O tempo de espera depende de vários fatores, como latência do fornecedor, latência do SO e funcionamento de ferramentas auxiliares.
Não confunda os mecanismos de escalonamento dos provedores de nuvem com o nosso CA. Este último opera dentro do cluster Kubernetes, enquanto o mecanismo do provedor de nuvem funciona com base na distribuição de nós. Ele não sabe o que acontece com seus pods ou aplicativos. Estes sistemas operam paralelamente.
Como gerenciar o escalonamento no Kubernetes
- Kubernetes é uma ferramenta de gerenciamento de recursos e orquestração. As operações de gerenciamento de pods e recursos do cluster são um marco essencial na compreensão do Kubernetes.
- Absorva a lógica de escalabilidade dos pods considerando HPA e VPA.
- CA deve ser usado apenas se você compreender bem as necessidades de seus pods e contêineres.
- Para otimizar a configuração do cluster, é necessário entender como diferentes sistemas de escalonamento trabalham juntos.
- Ao avaliar o tempo de escalonamento, tenha em mente os piores e melhores cenários.
Fonte: habr.com
