

O que você sentiria se, em um belo dia de verão, o data center com seu equipamento fosse assim?
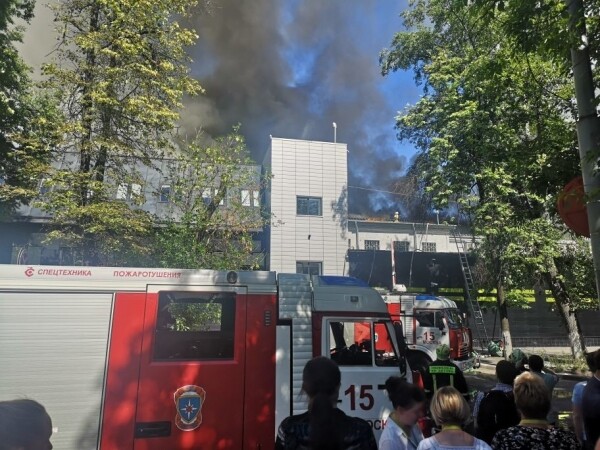
Olá a todos! Meu nome é Dmitry Samsonov, sou administrador de sistemas chefe na "". Na foto, um dos quatro data centers onde está o equipamento que atende nosso projeto. Atrás dessas paredes estão cerca de 4 mil unidades de hardware: servidores, sistemas de armazenamento de dados, equipamentos de rede, etc. — quase ⅓ de todo o nosso equipamento.
A maioria dos servidores é Linux. Existem também algumas dezenas de servidores Windows (MS SQL) — nosso legado, do qual estamos nos afastando gradualmente ao longo dos anos.
Então, no dia 5 de junho de 2019, às 14:35, os engenheiros de um de nossos data centers relataram um alarme de incêndio.
Negação
14:45. Incidentes menores de fumaça em data centers ocorrem com mais frequência do que parece. Os indicadores dentro das salas estavam normais, portanto, nossa primeira reação foi relativamente calma: instauramos uma proibição de alterações no ambiente de produção, ou seja, qualquer modificação de configurações, lançamento de novas versões, etc., exceto para trabalhos relacionados à reparação de algo.
Raiva
Você já tentou perguntar aos bombeiros onde exatamente no telhado ocorreu o incêndio, ou tentou ir ao telhado em chamas para avaliar a situação? Qual é o nível de confiança nas informações obtidas através de cinco pessoas?
14:50. Recebemos a informação de que o fogo está se aproximando do sistema de refrigeração. Mas irá chegar? O administrador de sistemas de plantão está redirecionando o tráfego externo das frentes desse data center.
Atualmente, as frentes de todos os nossos serviços estão duplicadas em três data centers, usando balanceamento no nível de DNS, o que permite remover endereços de um data center do DNS, protegendo assim os usuários de possíveis problemas de acesso aos serviços. No caso de problemas já terem ocorrido no data center, ele sai da rotação automaticamente. Mais detalhes podem ser lidos aqui:
Até agora, o incêndio não nos afetou de forma alguma — nem os usuários, nem o equipamento sofreram danos. Isso é um acidente? A primeira seção do documento "Plano de Ação em Caso de Acidente" define o que é um "Acidente", e a seção termina assim:
«Se houver dúvidas sobre se isso é um acidente ou não, então é um acidente!»
14:53. Nomeado o coordenador de emergência.
O coordenador é a pessoa que controla a comunicação entre todos os participantes, avalia a magnitude da emergência, utiliza o "Plano de Ação em Caso de Emergência", chama o pessoal necessário, supervisiona a conclusão dos reparos e, o mais importante, delega quaisquer tarefas. Em outras palavras, é a pessoa que gerencia todo o processo de eliminação da emergência.
Negociação
15:01. Começamos a desligar os servidores que não estão vinculados à produção.
15:03. Desligamos corretamente todos os serviços reservados.
Isso inclui não apenas os front-ends (nos quais os usuários já não acessam neste momento) e seus serviços auxiliares (lógica de negócios, caches etc.), mas também várias bases de dados com fator de replicação 2 ou mais (, , , e outros).
15:06. Recebemos informações de que um incêndio ameaça uma das salas do data center. Nesta sala não temos equipamentos, mas o fato de que o fogo pode se espalhar do telhado para as salas muda muito a situação.
(Mais tarde ficou claro que não havia ameaça física para a sala, pois estava hermeticamente isolada do telhado. A ameaça era apenas para o sistema de refrigeração dessa sala.)
15:07. Permitimos a execução de comandos nos servidores em modo acelerado sem verificações adicionais ().
15:08. A temperatura nas salas está dentro da norma.
15:12. Foi registrado um aumento de temperatura nas salas.
15:13. Mais da metade dos servidores no data center está desligada. Continuamos.
15:16. Decidimos desligar todo o equipamento.
15:21. Começamos a cortar a alimentação dos servidores stateless sem desligar adequadamente o aplicativo e o sistema operacional.
15:23. Um grupo é destacado para ser responsável pelo MS SQL (são poucos, a dependência dos serviços deles não é grande, mas o procedimento de recuperação é mais demorado e complicado do que, por exemplo, o do Cassandra).
Depressão
15:25. Recebemos informações sobre o corte de energia em quatro salas de 16 (nº 6, 7, 8, 9). Nos salões 7 e 8 está nosso equipamento. Ainda não temos informações sobre duas de nossas salas (nº 1 e 3).
Normalmente, em caso de incêndio, a alimentação elétrica é cortada imediatamente, mas nesse caso, graças ao trabalho coordenado dos bombeiros e da equipe técnica do data center, ela não foi desligada em todos os locais e não imediatamente, mas conforme necessidade.
(Mais tarde, foi descoberto que a energia nas salas 8 e 9 não foi desligada.)
15:28. Começamos a restaurar os bancos de dados MS SQL de backups em outros data centers.
Quanto tempo será necessário para isso? A largura de banda da rede será suficiente em todo o percurso?
15:37. Foi registrado o desligamento de algumas seções da rede.
A rede de gerenciamento e a rede de produção estão fisicamente isoladas uma da outra. Se a rede de produção estiver disponível, você pode acessar o servidor, parar o aplicativo e desligar o sistema operacional. Se não estiver disponível, é possível acessar via IPMI, parar o aplicativo e desligar o sistema operacional. Se nenhuma das redes estiver disponível, você não poderá fazer nada. 'Obrigado, capitão!', você pode pensar.
‘E, de fato, tem bastante agitação’, você pode pensar também.
O problema é que os servidores, mesmo sem incêndio, geram uma quantidade enorme de calor. Mais precisamente, quando há refrigeração, eles geram calor; e quando não há, criam um inferno que, na melhor das hipóteses, derrete parte do equipamento e desliga outra parte, e na pior… provoca um incêndio dentro da sala, que praticamente garantirá a destruição de tudo.
15:39. Registramos problemas com o banco de dados conf.
O banco de dados conf é o backend do serviço homônimo, que é utilizado por todos os aplicativos de produção para alterações operacionais nas configurações. Sem esse banco de dados, não conseguimos gerenciar as operações do portal, mas o próprio portal ainda pode funcionar.
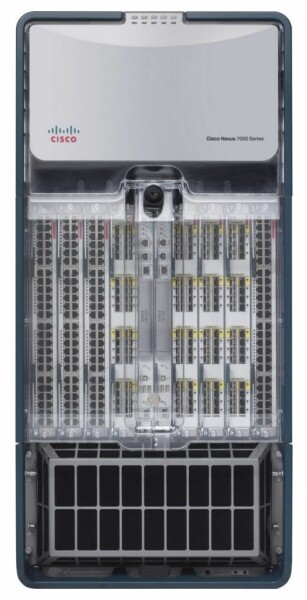
15:41. Os sensores de temperatura no equipamento de rede Core registram leituras próximas ao limite permitido. Esta é uma caixa que ocupa um rack e garante o funcionamento de todas as redes dentro do data center.
15:42. O rastreador de problemas e a wiki estão indisponíveis, mudamos para o modo de espera.
Isso não é produção, mas em caso de emergência, a acessibilidade de qualquer base de conhecimento pode ser crítica.
15:50. Um dos sistemas de monitoramento desligou.
Existem vários, e eles são responsáveis por diferentes aspectos do funcionamento dos serviços. Alguns deles estão configurados para funcionar de forma autônoma dentro de cada data center (ou seja, monitoram apenas seu próprio data center), outros consistem em componentes distribuídos que lidam de forma transparente com a perda de qualquer data center.
Neste caso, parou de funcionar , que funciona no modo master-standby. Mudamos para o standby.
Aceitação
15:51. Através do IPMI, desligamos todos os servidores sem um encerramento adequado, exceto o MS SQL.
Você está pronto para gerenciar servidores em massa através do IPMI, se necessário?
Aquele momento em que o resgate do equipamento no data center foi concluído nesta etapa. Tudo que podia ser feito, foi feito. Alguns colegas podem descansar.
16:13. Recebemos informações de que os canos de freon dos condicionadores de ar estouraram no telhado — isso atrasará a abertura do data center após a extinção do incêndio.
16:19. De acordo com os dados recebidos do pessoal técnico do data center, a temperatura nas salas deixou de subir.
17:10. Restauramos a operação da base conf. Agora podemos alterar as configurações dos aplicativos.
Por que isso é tão importante, se tudo é tolerante a falhas e funciona até sem um data center?
Em primeiro lugar, nem tudo é tolerante a falhas. Existem vários serviços secundários que ainda não suportam bem a falha de um data center, e há bases em modo master-standby. A capacidade de gerenciar as configurações permite fazer tudo o que for necessário para minimizar o impacto das consequências de uma emergência sobre os usuários, mesmo em condições difíceis.
Em segundo lugar, ficou claro que o funcionamento do data center não será totalmente restaurado nas próximas horas, portanto, foi necessário tomar medidas para que a indisponibilidade prolongada das réplicas não resultasse em problemas adicionais, como a saturação dos discos nos restantes data centers.
17:29. Hora da pizza! Temos pessoas trabalhando, não robôs.
Reabilitação
18:02. A temperatura estabilizou nas salas nº 8 (nossa), 9, 10 e 11. Em uma das que permanecem desligadas (nº 7), está nosso equipamento, e a temperatura continua subindo.
18:31. Demos sinal verde para iniciar o equipamento nas salas nº 1 e 3 — essas salas não foram afetadas pelo incêndio.
Atualmente, estamos iniciando servidores nas salas nº 1, 3 e 8, começando pelos mais críticos. Estamos verificando a operação correta de todos os serviços iniciados. Ainda existem problemas na sala nº 7.
18:44. O pessoal técnico do data center descobriu que, na sala nº 7 (onde está apenas nosso equipamento), muitos servidores não estão desligados. De acordo com nossas informações, 26 servidores permanecem ligados. Após nova verificação, encontramos 58 servidores.
20:18. O pessoal técnico do data center está ventilando o ar na sala sem condicionadores através de dutos móveis, que foram instalados pelos corredores.
23:08. Liberamos o primeiro administrador para casa. Alguém precisa descansar à noite para continuar o trabalho amanhã. A seguir, liberamos mais alguns administradores e desenvolvedores.
02:56. Iniciamos tudo que podia ser iniciado. Estamos fazendo uma grande verificação de todos os serviços com autotestes.
03:02. O ar condicionado na última sala, a 7ª, foi restaurado.
03:36. Colocamos os frontes no data center em rotação no DNS. A partir deste momento, o tráfego de usuários começa a chegar.
Liberamos a maior parte da equipe de administradores para casa. Mas mantemos algumas pessoas.
Pequenas FAQ:
Q: O que aconteceu das 18:31 às 02:56?
A: Seguindo o "Plano de Ação em Caso de Emergência", iniciamos todos os serviços, começando pelos mais importantes. Ao mesmo tempo, o coordenador no chat atribui um serviço a um administrador livre, que verifica se o sistema operacional e o aplicativo foram iniciados, se não há erros, se os indicadores estão normais. Após concluir a inicialização, ele informa no chat que está livre e recebe um novo serviço do coordenador.
O processo é adicionalmente atrasado por hardware com falha. Mesmo que a parada do sistema operacional e a desconexão dos servidores tenham ocorrido corretamente, parte dos servidores não retorna devido a discos, memória ou chassis que falharam inesperadamente. Quando há perda de energia, a taxa de falhas aumenta.
Q: Por que não podemos simplesmente iniciar tudo de uma vez e depois consertar o que aparecer no monitoramento?
A: Tudo precisa ser feito gradualmente, porque existem dependências entre os serviços. E é necessário verificar tudo imediatamente, sem esperar pelo monitoramento — porque é melhor resolver problemas logo, sem esperar que se agravem.
7:40. O último administrador (coordenador) foi dormir. O trabalho do primeiro dia foi concluído.
8:09. Os primeiros desenvolvedores, engenheiros nos data centers e administradores (incluindo o novo coordenador) começaram os trabalhos de restauração.
09:37. Começamos a levantar a sala nº 7 (a última).
Paralelamente, continuamos a restaurar o que não foi consertado em outras salas: substituição de discos/memória/servidores, consertar tudo que 'está pegando fogo' no monitoramento, reversão de papéis nos esquemas master-standby e outras pequenas coisas, que ainda assim são bastante numerosas.
17:08. Liberamos todos os trabalhos de rotina com a produção.
21:45. O trabalho do segundo dia foi concluído.
09:45. Hoje é sexta-feira. No monitoramento, ainda há muitos pequenos problemas. O fim de semana se aproxima e todos querem descansar. Continuamos a consertar em massa tudo o que é possível. As tarefas administrativas que poderiam ser adiadas foram adiadas. O coordenador é novo.
15:40. De repente, reiniciou metade do stack de equipamentos de rede em OUTRO datacenter. Retiramos da rotação as frentes para minimizar riscos. Não houve efeito para os usuários. Mais tarde, foi descoberto que era um chassi defeituoso. O coordenador está lidando com o reparo de duas falhas simultaneamente.
17:17. O funcionamento da rede em outro datacenter foi restaurado, tudo verificado. O datacenter foi reintegrado à rotação.
18:29. O trabalho do terceiro dia e, no geral, a recuperação após a falha foram concluídos.
Epílogo
04.04.2013, , "Odnoklassniki" — por três dias, o portal ficou total ou parcialmente inacessível. Durante todo esse tempo, mais de 100 pessoas de várias cidades e empresas (mais uma vez, muito obrigado!), remotamente e diretamente nos datacenters, manualmente e automaticamente consertaram milhares de servidores.
Tiramos lições. Para que isso não se repita, realizamos e continuamos a realizar, até hoje, um trabalho extensivo.
Quais são as principais diferenças entre a atual falha e a 404?
- Temos agora um "Plano de Ação em Caso de Falha". Uma vez por trimestre, fazemos simulações — encenamos uma situação de falha que um grupo de administradores (cada um em sua vez) deve resolver, utilizando o "Plano de Ação em Caso de Falha". Os principais administradores de sistemas alternam a função de coordenador.
- Trimestralmente, em modo de teste, isolamos os datacenters (todos em sua vez) pela rede LAN e WAN, o que permite identificar gargalos oportunamente.
- Menos discos danificados, pois endurecemos as normas: menos horas de operação, valores limites mais rigorosos para S.M.A.R.T.
- Desistimos completamente do BerkeleyDB — um banco de dados antigo e instável, que exigia muito tempo para recuperação após reinício do servidor.
- Reduzimos a quantidade de servidores com MS SQL e diminuímos a dependência dos restantes.
- Temos nossa própria , para a qual estamos migrando ativamente todos os serviços nos últimos dois anos. A nuvem simplifica significativamente todo o ciclo de trabalho com o aplicativo e, em caso de falha, oferece ferramentas únicas como:
- parada correta de todos os aplicativos com um clique;
- migração simples de aplicativos de servidores com falhas;
- início automático classificado (por prioridade dos serviços) de todo o data center.
O acidente descrito neste artigo foi o maior desde o 404. Claro, nem tudo foi tranquilo. Por exemplo, durante a indisponibilidade do data center afetado, um disco falhou em um dos servidores de outro data center, o que deixou disponível apenas uma das três réplicas no cluster Cassandra, resultando na impossibilidade de 4,2% dos usuários de aplicativos móveis se logarem. No entanto, os usuários já conectados continuaram a trabalhar. No total, mais de 30 problemas foram identificados como resultado do acidente – desde bugs triviais até falhas de arquitetura dos serviços.
Mas a principal diferença entre o atual acidente e o 404 é que enquanto tratávamos das consequências do incêndio, os usuários continuaram a se comunicar e realizar chamadas de vídeo em , jogavam, ouviam música, trocavam presentes, assistiam a vídeos, séries e canais de TV em , além de transmitirem ao vivo em .
Como ocorrem os seus acidentes?
Fonte: habr.com
