

Olá, Habr!
À luz dos eventos atuais devido ao coronavírus, vários serviços online começaram a receber uma carga aumentada. Por exemplo, , pois não havia capacidade suficiente. E nem sempre é possível acelerar o servidor apenas adicionando hardware mais potente, no entanto, é necessário processar as solicitações dos clientes (ou eles irão para os concorrentes).
Neste artigo, eu irei contar brevemente sobre as práticas populares que permitirão criar um serviço rápido e resiliente. Entretanto, entre os esquemas de desenvolvimento possíveis, selecionei apenas aqueles que agora são fáceis de utilizar.Para cada item, você já possui bibliotecas prontas ou tem a possibilidade de resolver a tarefa utilizando uma plataforma em nuvem.
Escalonamento horizontal
O item mais simples e conhecido. Condicionalmente, as duas esquemas de balanceamento de carga mais comuns são o escalonamento horizontal e vertical. você permite que os serviços operem em paralelo, distribuindo assim a carga entre eles. você encomenda servidores mais potentes ou otimiza o código.
Para exemplificar, vou usar um armazenamento de arquivos em nuvem abstrato, ou seja, algo como OwnCloud, OneDrive, e assim por diante.
A imagem padrão desse esquema é abaixo, no entanto, ela apenas demonstra a complexidade do sistema. Precisamos encontrar uma forma de sincronizar os serviços. O que acontece se o usuário salvar um arquivo de um tablet e, em seguida, quiser visualizá-lo a partir de um telefone?
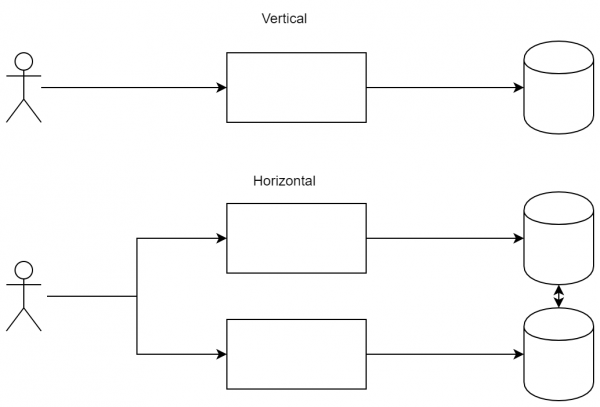
A diferença entre as abordagens: no escalonamento vertical, estamos prontos para aumentar a capacidade dos nós, enquanto no horizontal — adicionamos novos nós para distribuir a carga.
CQRS
é um padrão bastante importante, pois permite que diferentes clientes não apenas se conectem a diferentes serviços, mas também recebam correntes de eventos idênticas. Seus benefícios não são tão evidentes para um aplicativo simples, mas são extremamente importantes (e simples) para um serviço sobrecarregado. Sua essência é: fluxos de dados de entrada e saída não devem se cruzar. Ou seja, você não pode enviar uma solicitação e esperar uma resposta, em vez disso, você envia uma solicitação para o serviço A, mas recebe a resposta no serviço B.
O primeiro bônus dessa abordagem é a capacidade de desconectar (em um sentido amplo) durante a execução de uma requisição longa. Para exemplificar, vamos considerar uma sequência mais ou menos padrão:
- O cliente enviou uma requisição ao servidor.
- O servidor iniciou o processamento longo.
- O servidor respondeu ao cliente com o resultado.
Vamos imaginar que, no item 2, aconteceu uma quebra de conexão (ou a rede reconectou, ou o usuário navegou para outra página, interrompendo a conexão). Nessa situação, será difícil para o servidor enviar a resposta ao usuário com as informações sobre o que foi processado. Ao aplicar CQRS, a sequência será um pouco diferente:
- O cliente se inscreveu para receber atualizações.
- O cliente enviou uma requisição ao servidor.
- O servidor respondeu 'requisição recebida'.
- O servidor respondeu com o resultado através do canal do 'item 1'.
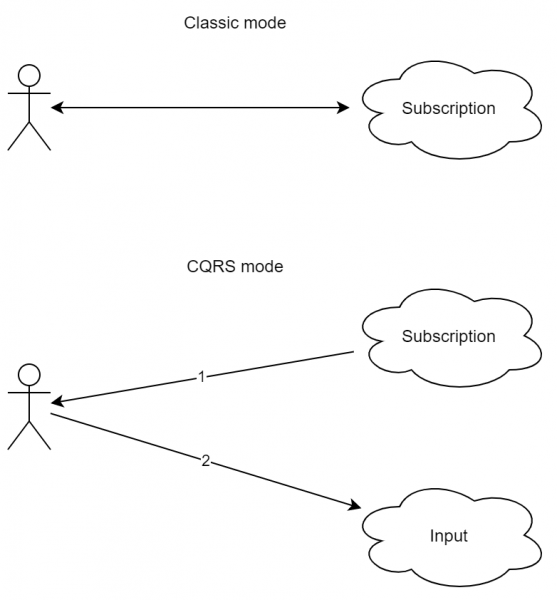
Como pode ser visto, o esquema é um pouco mais complexo. Além disso, a abordagem intuitiva de request-response aqui está ausente. Contudo, como é evidente, a quebra de conexão durante o processamento da requisição não levará a um erro. Além disso, se o usuário estiver realmente conectado ao serviço de vários dispositivos (por exemplo, de um celular e de um tablet), é possível fazer com que a resposta chegue a ambos os dispositivos.
É interessante notar que o código para o processamento das mensagens recebidas torna-se semelhante (não 100%) tanto para os eventos que foram afetados pelo próprio cliente quanto para os demais eventos, inclusive de outros clientes.
No entanto, na prática, obtemos bônus adicionais devido ao fato de que o fluxo unidirecional pode ser processado de maneira funcional (usando RX e similares). E isso já é uma grande vantagem, pois, essencialmente, o aplicativo pode se tornar completamente reativo, além de aplicar uma abordagem funcional. Para aplicativos mais robustos, isso pode significar uma economia significativa de recursos em desenvolvimento e manutenção.
Se combinarmos essa abordagem com escalabilidade horizontal, teremos como bônus a capacidade de enviar requisições a um servidor e receber respostas de outro. Assim, o cliente pode escolher o serviço que lhe for mais conveniente, enquanto a sistema internamente ainda poderáprocessar os eventos corretamente.
Event Sourcing.
Como você sabe, uma das principais características de um sistema distribuído é a ausência de tempo comum e de uma seção crítica compartilhada. Para um único processo, você pode fazer a sincronização (com os mesmos mutexes), dentro da qual você tem certeza de que ninguém mais está executando aquele código. No entanto, para um sistema distribuído, isso é arriscado, pois isso exige sobrecarga, além de aniquilar toda a beleza da escalabilidade — todos os componentes ainda estarão esperando um só.
Daqui obtemos um fato importante — um sistema distribuído rápido não pode ser sincronizado, pois isso diminuiria o desempenho. Por outro lado, muitas vezes precisamos de uma certa consistência entre os componentes. E para isso, podemos usar a abordagem de , onde é garantido que na ausência de alterações nos dados, após um certo período de tempo desde a última atualização (“em última instância”), todas as solicitações retornarão o último valor atualizado.
É importante entender que para bancos de dados clássicos, é frequentemente aplicada a , onde cada nó possui as mesmas informações (isso geralmente é alcançado quando uma transação é considerada estabelecida apenas após a resposta de um segundo servidor). Aqui há algumas flexibilizações devido aos níveis de isolamento, no entanto, a essência geral permanece a mesma — você pode viver em um mundo totalmente consistente.
No entanto, voltemos à tarefa inicial. Se parte do sistema puder ser construída com , então podemos construir o seguinte esquema.
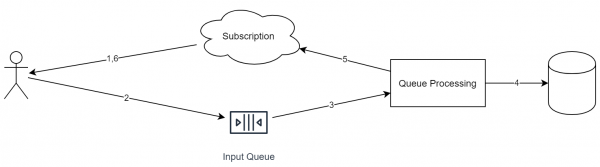
Características importantes dessa abordagem:
- Cada solicitação recebida é colocada em uma fila.
- Durante o processamento da solicitação, o serviço também pode colocar tarefas em outras filas.
- Cada evento de entrada tem um identificador (que é necessário para a deduplicação).
- A fila funciona ideologicamente segundo o esquema 'apenas adicionar'. Não é possível remover ou rearranjar elementos dela.
- A fila funciona segundo o esquema FIFO (desculpe pela tautologia). Se for necessário realizar execução paralela, então em uma das etapas os objetos devem ser realocados em diferentes filas.
Lembro que estamos considerando o caso de um armazenamento online de arquivos. Neste caso, o sistema parecerá, aproximadamente, assim:
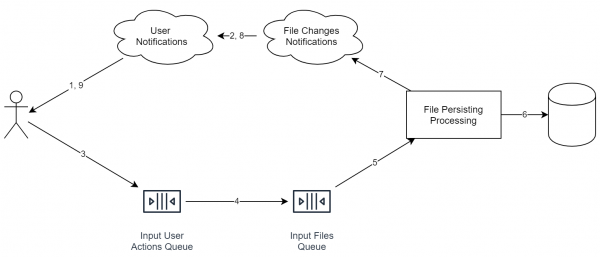
É importante notar que os serviços no diagrama não significam necessariamente um servidor separado. Mesmo o processo pode ser o mesmo. O que importa é que, ideologicamente, essas coisas estão separadas de tal forma que facilita a aplicação de escalabilidade horizontal.
E para dois usuários, o esquema ficará assim (os serviços destinados a diferentes usuários são marcados com cores diferentes):
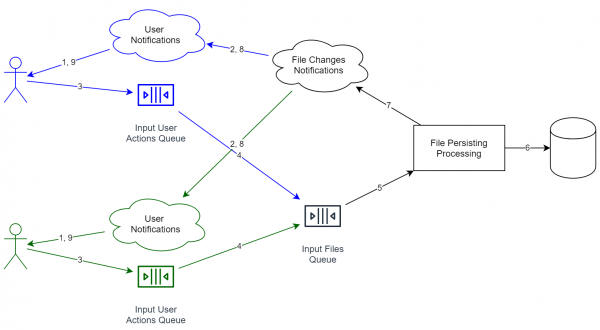
Os benefícios dessa combinação:
- Os serviços de processamento de informações estão separados. As filas também estão divididas. Se precisarmos aumentar a capacidade de throughput do sistema, basta iniciar mais serviços em um maior número de servidores.
- Quando recebemos informações do usuário, não precisamos esperar pelo salvamento completo dos dados. Pelo contrário, podemos simplesmente responder 'ok', e depois começar a trabalhar gradualmente. Ao mesmo tempo, a fila suaviza os picos, já que a adição de um novo objeto ocorre rapidamente, e o usuário não precisa esperar por todo o ciclo completo.
- Como exemplo, adicionei um serviço de deduplicação que tenta unir arquivos semelhantes. Se ele levar tempo em 1% dos casos, o cliente praticamente não notará (veja acima), o que é uma grande vantagem, pois não necessitamos de 100% de velocidade e confiabilidade.
No entanto, as desvantagens são imediatamente visíveis:
- Nossa sistema perdeu a coerência rigorosa. Isso significa que, por exemplo, ao assinar diferentes serviços, teoricamente podemos obter estados diferentes (uma vez que um dos serviços pode não ter tempo para receber a notificação da fila interna). Como outra consequência, o sistema agora não tem um tempo comum. Ou seja, não podemos, por exemplo, classificar todos os eventos apenas pelo tempo de chegada, pois os relógios entre os servidores podem não estar sincronizados (além do mais, ter o mesmo tempo em dois servidores é uma utopia).
- Nenhum evento pode agora ser simplesmente revertido (como poderia ser feito com um banco de dados). Em vez disso, é necessário adicionar um novo evento — , que mudará o último estado para o necessário. Como exemplo de um campo semelhante: sem reescrever o histórico (o que é ruim em certas situações), no git não é possível reverter um commit, mas é possível fazer um , que, na prática, simplesmente retornará o estado anterior. No entanto, tanto o commit incorreto quanto o rollback estarão salvos no histórico.
- O esquema de dados pode mudar de versão para versão, no entanto, não será possível atualizar eventos antigos para o novo padrão (já que eventos não podem ser alterados, em princípio).
Como é evidente, o Event Sourcing se adapta bem ao CQRS. Além disso, implementar um sistema com filas eficientes e práticas, mas sem separação de fluxos de dados, já é complicado por si só, pois será necessário adicionar pontos de sincronização que anularão todo o efeito positivo das filas. Ao aplicar ambas as abordagens simultaneamente, é necessário ajustar levemente o código do funcionamento do programa. No nosso caso, ao enviar um arquivo para o servidor, a resposta é apenas ‘ok’, o que significa apenas que ‘a operação de adição do arquivo foi salva’. Formalmente, isso não significa que os dados já estão disponíveis em outros dispositivos (por exemplo, o serviço de deduplicação pode estar reorganizando o índice). No entanto, após algum tempo, o cliente receberá uma notificação como ‘o arquivo X foi salvo’.
Como resultado:
- O número de status de envio de arquivos aumenta: em vez do clássico ‘arquivo enviado’, temos dois: ‘arquivo adicionado à fila no servidor’ e ‘arquivo salvo no armazenamento’. O último significa que outros dispositivos já podem começar a receber o arquivo (com a ressalva de que as filas funcionam a velocidades diferentes).
- Devido ao fato de que a informação sobre o envio agora chega por diferentes canais, precisamos encontrar soluções para obter o status de processamento do arquivo. Como consequência: ao contrário do clássico request-response, o cliente pode ser reiniciado durante o processamento do arquivo, mas o status desse processamento será correto. E esse ponto funciona, na verdade, imediatamente. Como resultado: agora somos mais tolerantes a falhas.
Sharding
Como já mencionado, em sistemas com event sourcing não há consistência rígida. Portanto, podemos usar vários armazenamentos sem qualquer sincronização entre eles. Aproximando-nos da nossa tarefa, podemos:
- Separar arquivos por tipos. Por exemplo, imagens/vídeos podem ser decodificados e selecionados em um formato mais eficiente.
- Separar contas por países. Devido a várias leis, isso pode ser necessário, mas essa arquitetura permite essa possibilidade automaticamente.
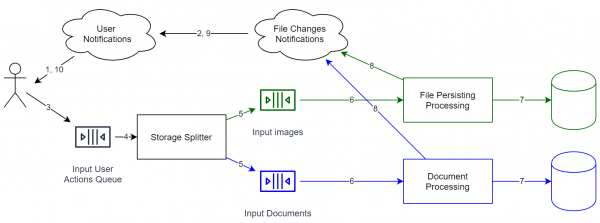
Se você deseja transferir dados de um armazenamento para outro, as ferramentas padrão não serão suficientes. Infelizmente, nesse caso, é necessário interromper a fila, realizar a migração e depois reiniciá-la. Em geral, os dados não podem ser transferidos "em tempo real", no entanto, se a fila de eventos for armazenada completamente e você tiver cópias dos estados anteriores do armazenamento, podemos reproduzir os eventos da seguinte maneira:
- No Event Source, cada evento tem seu próprio identificador (idealmente, não decrescente). Isso significa que podemos adicionar um campo no armazenamento — id do último elemento processado.
- Duplicamos a fila para que todos os eventos possam ser processados para vários armazenamentos independentes (o primeiro é aquele onde os dados já estão, e o segundo é novo, mas ainda vazio). A segunda fila, naturalmente, ainda não está sendo processada.
- Iniciamos a segunda fila (ou seja, começamos a reproduzir eventos).
- Quando a nova fila estiver relativamente vazia (ou seja, a diferença média de tempo entre a adição de um elemento e sua remoção for aceitável), podemos começar a transferir os leitores para o novo armazenamento.
Como pode ser visto, em nosso sistema nunca houve e não há estrita consistência. Existe apenas eventual consistência, ou seja, a garantia de que os eventos são processados na mesma ordem (no entanto, possivelmente com diferentes atrasos). E, aproveitando isso, podemos transferir dados comparativamente facilmente sem interromper o sistema para o outro lado do planeta.
Assim, continuando com nosso exemplo de armazenamento online para arquivos, essa arquitetura já nos oferece uma série de benefícios:
- Podemos mover objetos mais perto dos usuários de forma dinâmica. Isso pode melhorar a qualidade do serviço.
- Podemos armazenar parte dos dados dentro das empresas. Por exemplo, usuários corporativos geralmente exigem que seus dados sejam mantidos em data centers controlados (para evitar vazamentos de dados). Com o sharding, podemos facilmente suportar isso. A tarefa se torna ainda mais fácil se o cliente tiver uma nuvem compatível (por exemplo, ).
- E o mais importante — podemos não fazer isso. Afinal, inicialmente ficaríamos satisfeitos com um único armazenamento para todas as contas (para começar a trabalhar mais rapidamente). E a característica fundamental desse sistema — embora seja escalável, na fase inicial é bastante simples. Basta não escrever código que funcione com um milhão de filas independentes, etc. Se necessário, isso pode ser feito no futuro.
Hospedagem de Conteúdo Estático
Esse ponto pode parecer bastante óbvio, mas ainda assim é necessário para um aplicativo sobrecarregado mais ou menos padrão. Sua essência é simples: todo o conteúdo estático é distribuído não a partir do mesmo servidor onde o aplicativo está localizado, mas de servidores especiais dedicados a essa tarefa. Como resultado, essas operações são realizadas mais rapidamente (um nginx, por exemplo, entrega arquivos de maneira mais ágil e menos custosa do que um servidor Java). Além disso, a arquitetura CDN () permite posicionar nossos arquivos mais perto dos usuários finais, o que melhora a experiência de uso do serviço.
O exemplo mais simples e padrão de conteúdo estático é um conjunto de scripts e imagens para um site. Com eles, tudo é simples — eles são conhecidos de antemão, em seguida, o arquivo é carregado nos servidores CDN, de onde é distribuído para os usuários finais.
No entanto, na prática, para conteúdo estático, pode-se aplicar uma abordagem algo semelhante à arquitetura lambda. Vamos voltar à nossa tarefa (armazenamento online de arquivos), na qual precisamos distribuir arquivos para os usuários. A solução mais simples seria criar um serviço que, para cada solicitação do usuário, realiza todas as verificações necessárias (autenticação etc.) e depois baixa o arquivo diretamente do nosso armazenamento. A principal desvantagem dessa abordagem é que o conteúdo estático (e um arquivo com uma revisão específica, na verdade, é um conteúdo estático) é distribuído pelo mesmo servidor que contém a lógica de negócios. Em vez disso, podemos criar o seguinte esquema:
- O servidor gera uma URL para download. Ela pode ser do tipo file_id + key, onde key é uma assinatura digital curta que concede acesso ao recurso por até um dia.
- A distribuição do arquivo é feita por um nginx simples com as seguintes opções:
- Cache de conteúdo. Como este serviço pode estar em um servidor separado, deixamos uma margem para o futuro, com a possibilidade de armazenar todos os últimos arquivos baixados em disco.
- Verificação da chave no momento da conexão
- Opcional: processamento de conteúdo em fluxo. Por exemplo, se comprimimos todos os arquivos no serviço, podemos descompactá-los diretamente neste módulo. Como consequência: operações de IO são realizadas onde fazem mais sentido. Um arquivador em Java pode consumir muita memória adicional, no entanto, reescrever o serviço com lógica de negócios em Rust/C++ pode também ser ineficaz. No nosso caso, utilizamos diferentes processos (ou até mesmo serviços), portanto, é possível separar de maneira eficiente a lógica de negócios e as operações de IO.
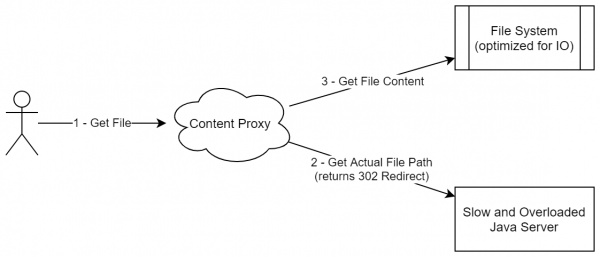
Esse esquema não se parece muito com a entrega de conteúdo estático (uma vez que não estamos transferindo todo o pacote de estática para algum lugar), mas na realidade, essa abordagem realmente se dedica à entrega de dados imutáveis. Além disso, esse esquema pode ser generalizado para outros casos, onde o conteúdo não é apenas estático, mas pode ser representado como um conjunto de blocos imutáveis e não removíveis (embora possam ser adicionados).
Como mais um exemplo (para reforçar): se você já trabalhou com Jenkins/TeamCity, sabe que ambas as soluções são escritas em Java. Ambas representam um processo Java que cuida tanto da orquestração de builds quanto da gestão de conteúdo. Em particular, ambas têm tarefas do tipo 'enviar arquivo/pasta do servidor'. Por exemplo: entrega de artefatos, transmissão de código-fonte (quando o agente não baixa o código diretamente do repositório, mas o servidor faz isso), acesso aos logs. Todas essas tarefas têm diferentes cargas sobre o IO. Ou seja, o servidor responsável pela lógica de negócios complexa também deve ser capaz de empurrar grandes fluxos de dados de forma eficiente. E o mais interessante é que tal operação pode ser delegada ao mesmo nginx pela mesma lógica (exceto que na solicitação deve-se adicionar a chave de dados).
No entanto, se voltarmos ao nosso sistema, temos um esquema semelhante:
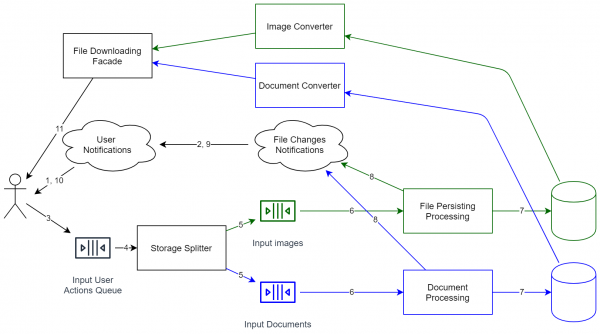
Como observado, o sistema se tornou radicalmente mais complexo. Não é mais apenas um mini-processo que armazena arquivos localmente. Agora, é necessária uma manutenção que não é tão simples, controle de versões de API, etc. Portanto, depois que todos os diagramas são desenhados, é melhor avaliar detalhadamente se o custo da escalabilidade vale a pena. Contudo, se você deseja ter a capacidade de expandir o sistema (incluindo para lidar com um número ainda maior de usuários), terá que considerar soluções desse tipo. O resultado é que a arquitetura do sistema está preparada para um aumento de carga (praticamente todos os componentes podem ser clonados para escalabilidade horizontal). O sistema pode ser atualizado sem precisar ser parado (apenas algumas operações podem desacelerar ligeiramente).
Como eu mencionei no início, atualmente vários serviços na internet estão enfrentando uma carga maior. E alguns deles simplesmente deixaram de operar corretamente. Na verdade, os sistemas falharam exatamente no momento em que o negócio precisava gerar receita. Ou seja, em vez de realizar uma entrega programada, em vez de oferecer aos clientes para "planejar a entrega nos próximos meses", o sistema simplesmente disse "vá para a concorrência". Esta é, na verdade, o custo da baixa performance: as perdas ocorrerão precisamente quando os lucros poderiam ser mais altos.
Conclusão
Todas essas abordagens já eram conhecidas anteriormente. O VK, por exemplo, já utiliza a ideia de Static Content Hosting para a entrega de imagens. Muitas games online utilizam o esquema de Sharding para dividir os jogadores por regiões ou para separar zonas de jogo (caso o mundo seja único). O Event Sourcing é amplamente utilizado em e-mails. A maioria dos aplicativos de traders, onde os dados chegam continuamente, é na verdade construída com a abordagem CQRS, para poder filtrar os dados recebidos. E a escalabilidade horizontal já é aplicada há bastante tempo em muitos serviços.
No entanto, o mais importante é que todos esses padrões se tornaram muito fáceis de aplicar em aplicações modernas (se forem adequados, é claro). As nuvens oferecem Sharding e escalabilidade horizontal de imediato, o que é muito mais fácil do que solicitar diferentes servidores dedicados em diferentes data centers por conta própria. CQRS se tornou muito mais fácil, pelo menos devido ao desenvolvimento de bibliotecas como RX. Há 10 anos, era raro um site conseguir suportar isso. Event Sourcing também é configurado incrivelmente fácil graças aos contêineres prontos com Apache Kafka. Há 10 anos isso seria uma inovação, agora é algo comum. O mesmo vale para o Static Content Hosting: devido a tecnologias mais acessíveis (inclusive por haver documentação detalhada e uma grande base de respostas), essa abordagem tornou-se ainda mais simples.
Como resultado, a implementação de uma série de padrões arquiteturais bastante complexos tornou-se agora muito mais fácil, e isso significa que vale a pena prestar atenção antecipadamente. Se em uma aplicação de dez anos foi descartada uma das soluções acima devido ao alto custo de implementação e operação, agora, em uma nova aplicação, ou após um refatoramento, é possível criar um serviço que já será arquitetonicamente extensível (em termos de desempenho) e pronto para novas demandas dos clientes (por exemplo, para a localização de dados pessoais).
E o mais importante: por favor, não utilize essas abordagens se você tiver uma aplicação simples. Sim, elas são bonitas e interessantes, no entanto, para um site com pico de 100 visitantes, muitas vezes é possível utilizar um monólito clássico (pelo menos externamente; internamente, tudo pode ser fragmentado em módulos, etc.).
Fonte: habr.com
