

Desmistificando a apresentação de Bruce Momjian de 2020 "Desbloqueando o Gerenciador de Locks do Postgres".
(Nota: Todos os comandos SQL dos slides podem ser obtidos através deste link: )
Olá! É maravilhoso estar aqui novamente na Rússia. Peço desculpas por não ter conseguido vir no ano passado, mas este ano Ivan e eu temos grandes planos. Espero estar aqui com muito mais frequência. Adoro visitar a Rússia. Estarei passando por Tyumen e Tver. Estou muito empolgado por poder conhecer essas cidades.
Meu nome é Bruce Momjian. Eu trabalho na EnterpriseDB e estou com Postgres há mais de 23 anos. Moro na Filadélfia, EUA. Viajo cerca de 90 dias por ano e participo de aproximadamente 40 conferências. Meu , que contém os slides que vou apresentar a vocês agora. Portanto, após a conferência, vocês podem baixá-los do meu site pessoal. Há também cerca de 30 apresentações disponíveis. Além disso, existem vídeos e uma grande quantidade de postagens no blog, mais de 500 no total. É um recurso bastante completo. E se você estiver interessado neste material, convido você a aproveitá-lo.
Fui professor, docente, antes de começar a trabalhar com Postgres. E estou muito feliz por agora poder compartilhar com vocês o que estou prestes a apresentar. Esta é uma das minhas apresentações mais interessantes. E esta apresentação contém 110 slides. Começaremos com coisas simples, mas ao final, a apresentação se tornará progressivamente mais complexa.
Esta é uma conversa bastante incômoda. A questão da bloqueio não é o tópico mais popular. Queremos que ela desapareça. É como ir ao dentista.
- O bloqueio é um problema para muitas pessoas que trabalham com bancos de dados e têm vários processos em execução ao mesmo tempo. Eles precisam de bloqueios. Ou seja, hoje eu vou fornecer a vocês conhecimentos básicos sobre bloqueios.
- Identificadores de transações. Esta é uma parte bastante chata da apresentação, mas é essencial entendê-la.
- Em seguida, vamos discutir os tipos de bloqueio. Esta é uma parte bastante mecânica.
- E em seguida, vamos dar alguns exemplos de bloqueios. E isso vai ser bastante desafiador de entender.
Vamos falar sobre bloqueios.
A terminologia que usamos é bastante complexa. Quantos de vocês sabem de onde vem este trecho? Duas pessoas. É de um jogo chamado "Aventura Colossal na Caverna". Era um jogo de computador baseado em texto dos anos 80, pelo que me lembro. Você tinha que entrar na caverna, em um labirinto, e o texto mudava, mas o conteúdo era mais ou menos o mesmo a cada vez. É assim que eu me lembro desse jogo.
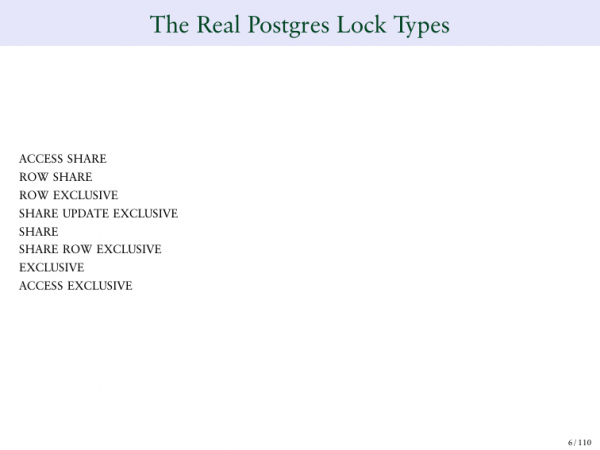
E aqui vemos os nomes dos bloqueios que vieram até nós da Oracle. Nós os usamos.
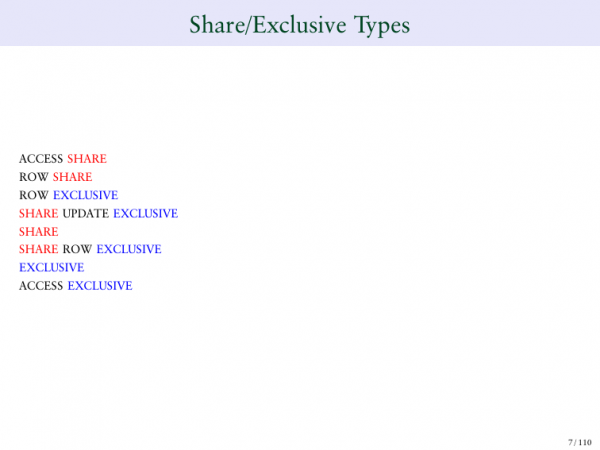
Aqui vemos termos que me confundem. Por exemplo, SHARE UPDATE EXCLUSIVE. Em seguida, SHARE RAW EXCLUSIVE. Honestamente, esses nomes não são muito claros. Tentaremos analisá-los com mais profundidade. Alguns contêm a palavra "share", que significa – separar. Alguns contêm a palavra "exclusive" – exclusivo. Em alguns, essas duas palavras estão presentes. Eu gostaria de começar com como esses bloqueios funcionam.
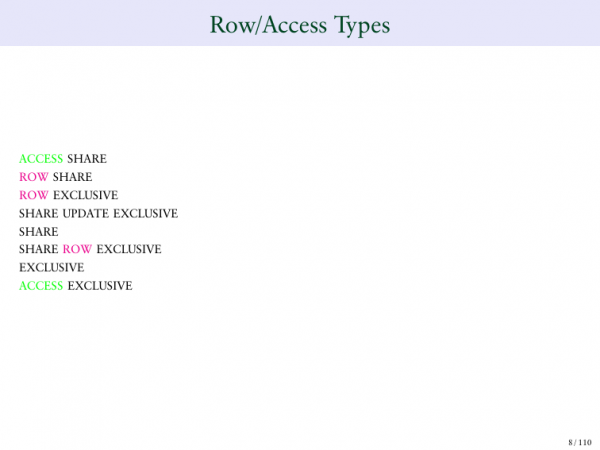
E também é muito importante a palavra "acesso" — access. E a palavra "row" — linha. Ou seja, distribuição de acesso, distribuição de linhas.
Outro problema que precisamos entender no Postgres, infelizmente não poderei abordar em minha apresentação, é o MVCC. Tenho uma apresentação separada sobre esse tema em meu site. E se você achar que esta apresentação é complexa, o MVCC é provavelmente a mais complicada que tenho. E se você estiver interessado, pode assisti-la no site. Você pode ver o vídeo.
Outro ponto que precisamos entender é sobre identificadores de transação. Muitas transações não podem funcionar sem identificadores únicos. E aqui temos uma explicação do que é uma transação. No Postgres, existem dois sistemas de numeração de transações. Eu sei, não é uma solução muito bonita.
Além disso, tenha em mente que os slides serão bastante complexos de entender, portanto, preste atenção ao que está destacado em vermelho, é nisso que você deve focar.
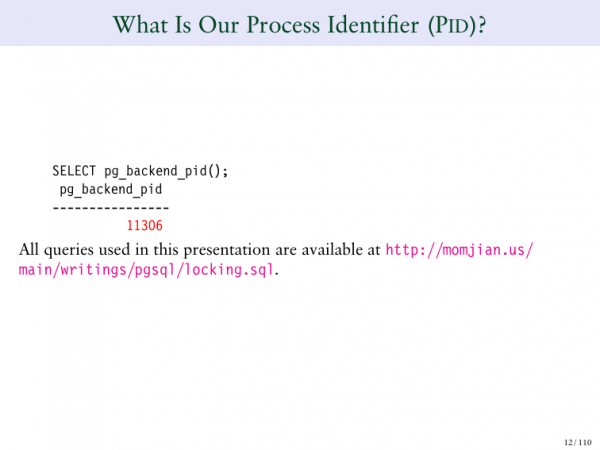
Vamos ver. O número da transação está destacado em vermelho. Aqui está mostrada a função SELECT pg_back. Ela retorna a minha transação e o ID dessa transação.
Mais um ponto, se você gostou desta apresentação e deseja executá-la em seu banco de dados, pode seguir este link destacado em rosa e baixar o SQL para esta apresentação. E você pode simplesmente executá-la no seu PSQL e toda a apresentação aparecerá na tela imediatamente. Ela não conterá cores, mas pelo menos poderemos vê-la.
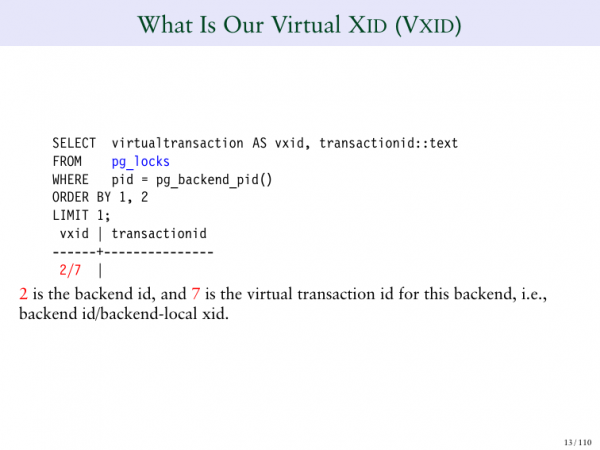
Neste caso, vemos o ID da transação. Este é o número que atribuímos a ela. E há outro tipo de ID de transação no Postgres, que é chamado de ID de transação virtual.
E precisamos entender isso. É muito importante, caso contrário não conseguiremos compreender o bloqueio no Postgres.
O ID de transação virtual é um ID de transação que não contém valores permanentes. Por exemplo, se eu executar um comando SELECT, provavelmente não vou mudar o banco de dados, não vou bloquear nada. Portanto, quando executamos um simples SELECT, não atribuímos um ID permanente a essa transação. Damos apenas um ID virtual.
E isso aumenta o desempenho do Postgres, melhora as capacidades de limpeza, por isso o ID da transação virtual consiste em dois números. O primeiro número antes da barra é o ID do backend. E à direita vemos apenas um contador.
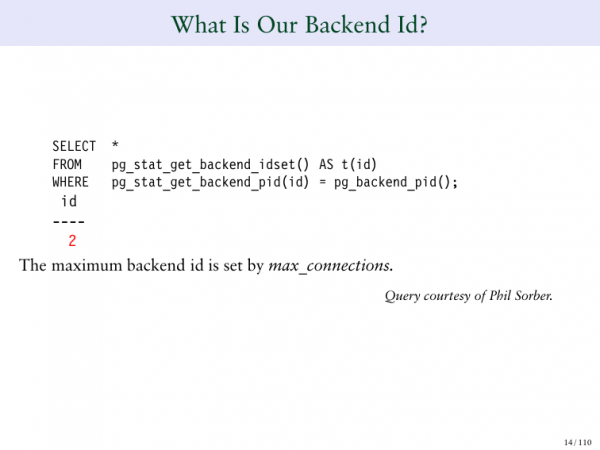
Portanto, se eu executar uma consulta, ela diz que o ID do backend é 2.
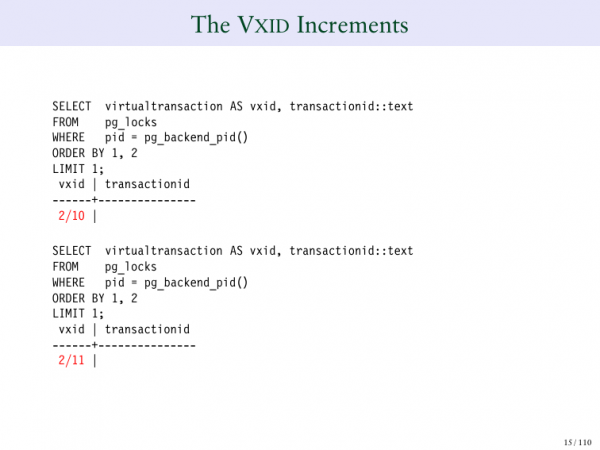
E se eu executar uma série dessas transações, veremos que o contador aumenta a cada vez que eu executo uma consulta. Por exemplo, quando eu executo a consulta 2/10, 2/11, 2/12, etc.
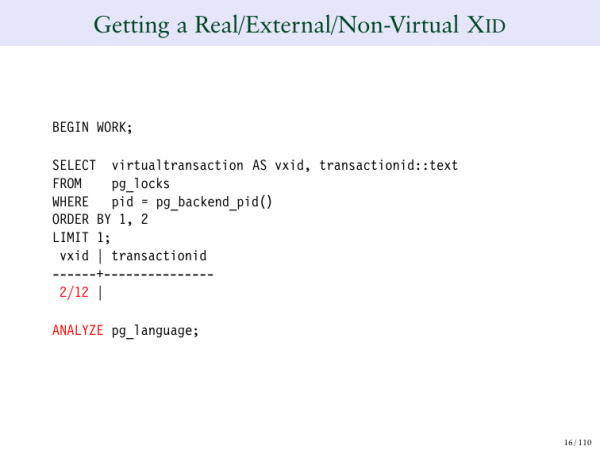
Tenha em mente que aqui existem duas colunas. À esquerda, vemos o ID virtual da transação – 2/12. E à direita, temos o ID permanente da transação. E este campo está vazio. E essa transação não modifica o banco de dados. Portanto, não atribuo a ela um ID permanente de transação.
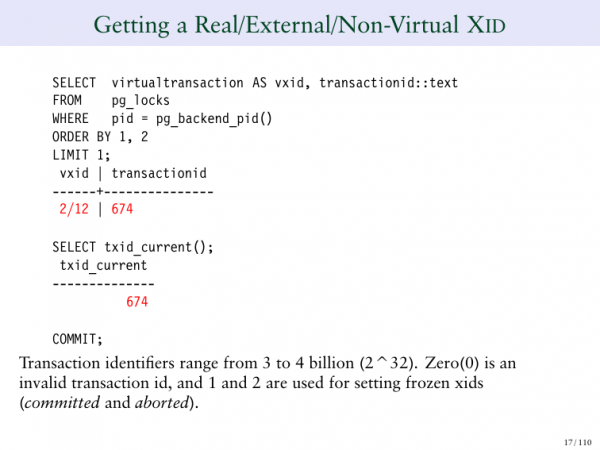
Assim que eu executo o comando analisar (ANALYZE), a mesma consulta me dá um ID permanente de transação. Veja como isso mudou. Antes eu não tinha esse ID, agora ele apareceu.
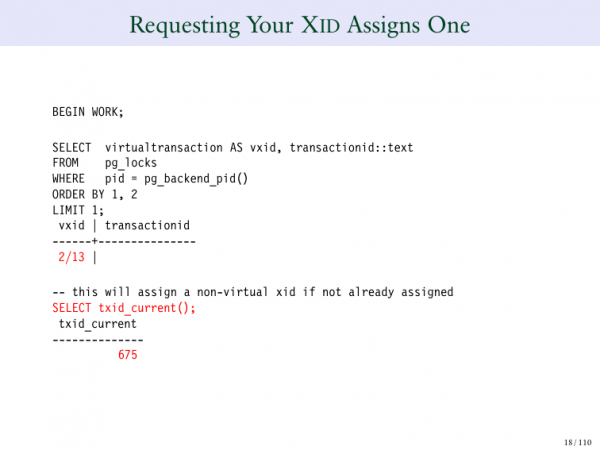
Então, aqui está mais uma consulta, mais uma transação. O número virtual da transação é 2/13. E se eu solicitar o ID permanente da transação, quando eu executar a consulta, eu o obterei.
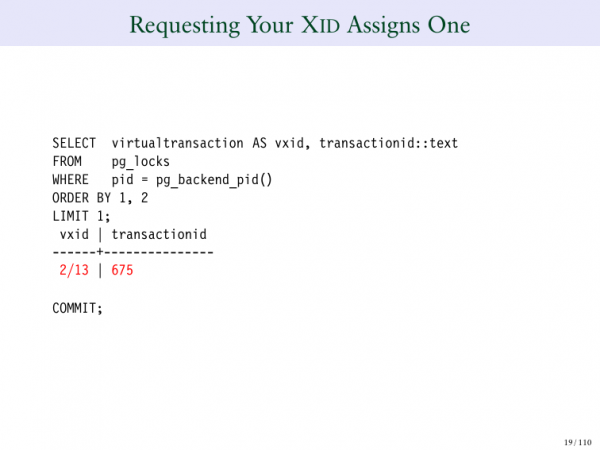
Então, mais uma vez. Temos o ID virtual da transação e o ID permanente da transação. Apenas entenda este ponto para compreender o comportamento do Postgres.
Estamos indo para a terceira seção. Aqui, vamos passar rapidamente por diferentes tipos de bloqueios no Postgres. Isso não é muito interessante. A última seção será muito mais interessante. Mas devemos considerar as coisas básicas, porque senão não entenderemos o que virá a seguir.
Vamos passar por esta seção, onde analisaremos cada tipo de bloqueio. E eu vou te mostrar exemplos de como eles são definidos, como funcionam, e vou mostrar algumas consultas que você pode usar para ver como os bloqueios operam no Postgres.
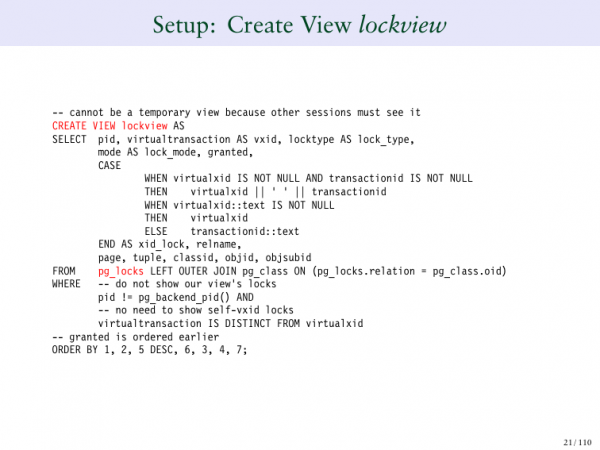
Para criar uma consulta e ver o que está acontecendo no Postgres, precisamos executar uma consulta na visualização do sistema. Neste caso, temos o pg_lock destacado em vermelho. Pg_lock é uma tabela do sistema que nos informa quais bloqueios estão atualmente em uso no Postgres.
No entanto, é muito difícil para mim mostrar o pg_lock por si só, porque é bastante complicado. Por isso, criei uma visualização que mostra o pg_locks. E ela também realiza um trabalho para mim, o que me permite entender melhor. Ou seja, ela exclui meus bloqueios, minha própria sessão, etc. É apenas SQL padrão e me permite mostrar melhor o que está acontecendo.
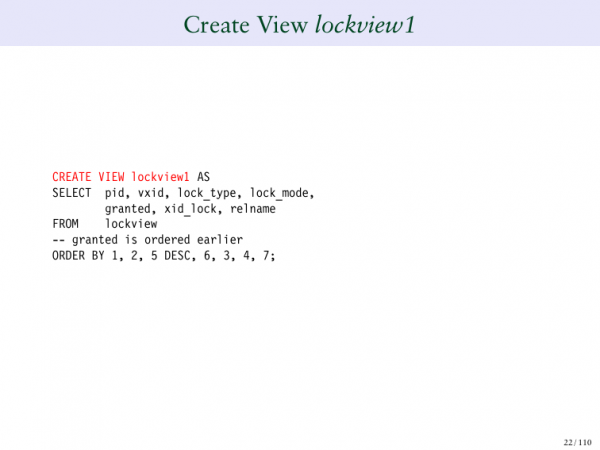
Outro problema é que essa visualização é muito ampla, então eu preciso criar uma segunda – lockview2.
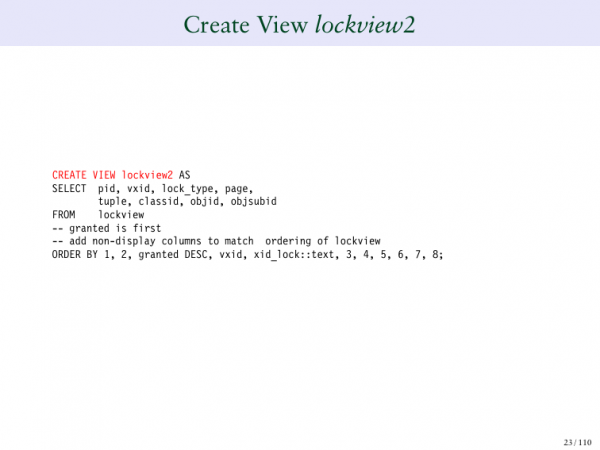 E ela me mostra mais colunas da tabela. E outra, que me mostra as outras colunas. É bastante complicado, então eu procurei apresentá-lo da forma mais simples possível.
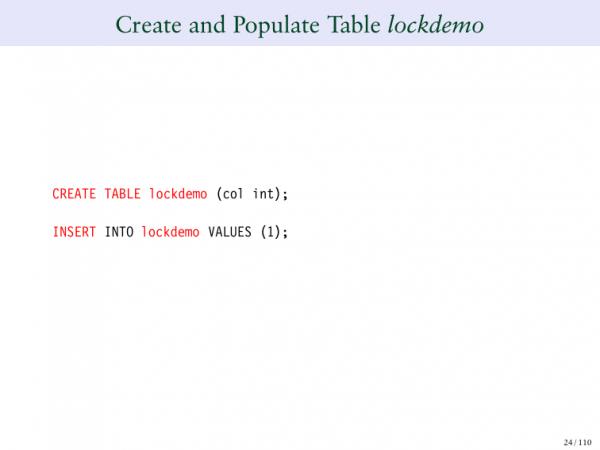
Então, criamos uma tabela chamada Lockdemo. E criamos uma linha nela. Esta é a nossa tabela de exemplo. E nós vamos criar seções apenas para te mostrar exemplos de bloqueios.
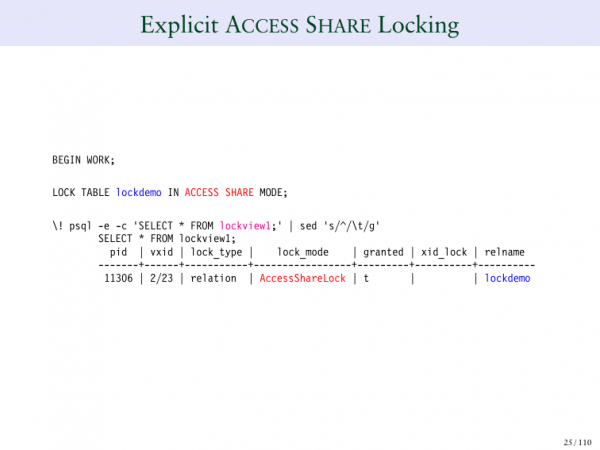
Então, uma linha, uma coluna. O primeiro tipo de bloqueio é chamado de ACCESS SHARE. Este é o bloqueio menos restritivo. Isso significa que ele praticamente não entra em conflito com os outros bloqueios.
E se quisermos definir explicitamente o bloqueio, executamos o comando "lock table". E ele bloqueará explicitamente, ou seja, em modo ACCESS SHARE, executamos lock table. E se eu rodar o PSQL em segundo plano, dessa forma, eu estou iniciando uma segunda sessão da minha primeira sessão. Ou seja, o que eu farei aqui? Eu mudo para outra sessão e digo a ela "mostre-me o lockview para esta consulta". E aqui eu tenho AccessShareLock nesta tabela. É exatamente isso que eu pedi. E ele diz que o bloqueio foi concedido. Muito simples.
Em seguida, se olharmos para a segunda coluna, não há nada lá. Elas estão vazias.
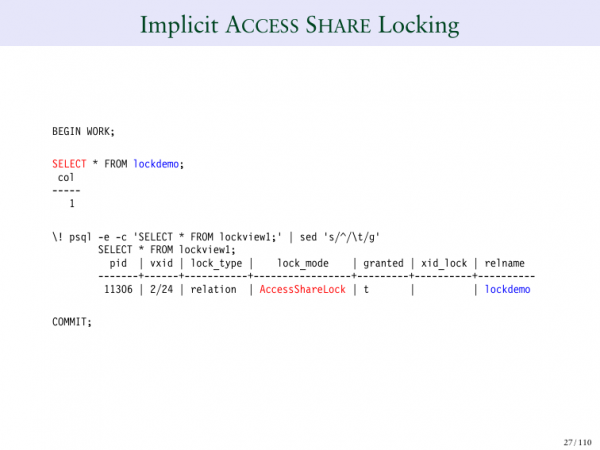
E se eu executar o comando "SELECT", é uma forma implícita (explícita) de solicitar AccessShareLock. Portanto, eu libero minha tabela e executo a consulta, e a consulta retorna várias linhas. E em uma das linhas, vemos AccessShareLock. Portanto, SELECT chama AccessShareLock na tabela. E ele praticamente não entra em conflito com nada, porque é um bloqueio de baixo nível.
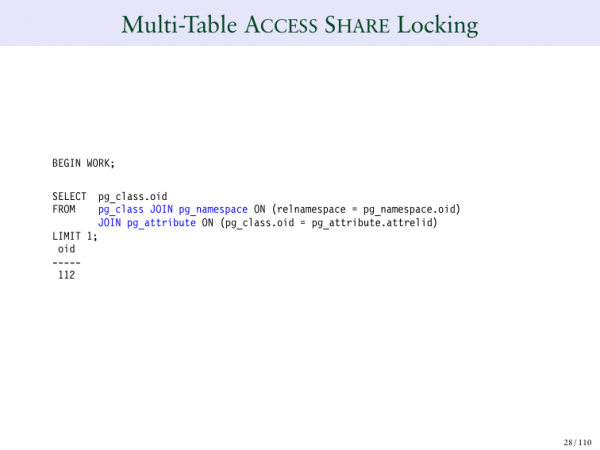
E se eu executar SELECT e tiver três tabelas diferentes? Anteriormente eu executava apenas uma tabela, agora estou gerando três: pg_class, pg_namespace e pg_attribute.
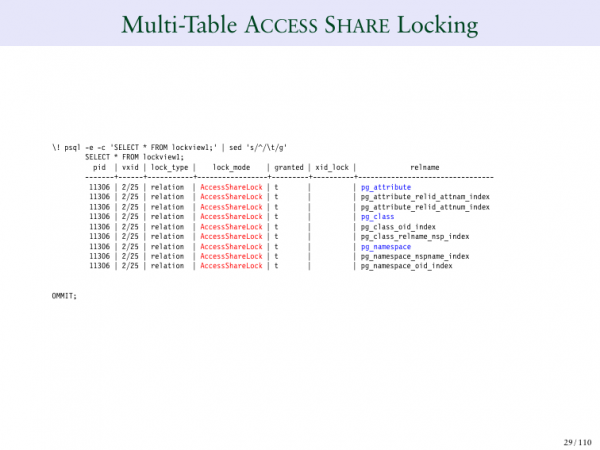
E agora, quando olho para a consulta, vejo 9 AccessShareLocks nas três tabelas. Por quê? Em azul estão destacadas as três tabelas: pg_attribute, pg_class, pg_namespace. Mas você também pode ver que todos os índices definidos nessas tabelas também têm AccessShareLock.
E esse é um bloqueio que praticamente não conflita com os outros. E tudo o que ele faz é simplesmente não nos permitir liberar a tabela enquanto estamos a selecionando. Isso faz sentido. Ou seja, se estamos selecionando uma tabela, ela naquele momento desaparece, isso é incorreto, portanto AccessShare é um bloqueio de baixo nível que nos diz "não exclua esta tabela enquanto estou trabalhando".. Essencialmente, é tudo o que ele faz.
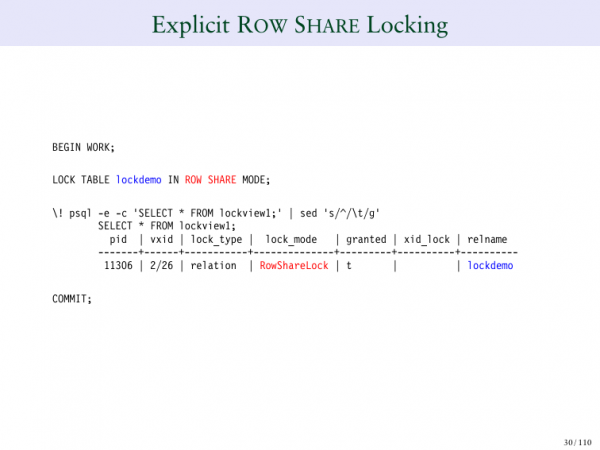
ROW SHARE é um bloqueio um pouco diferente.
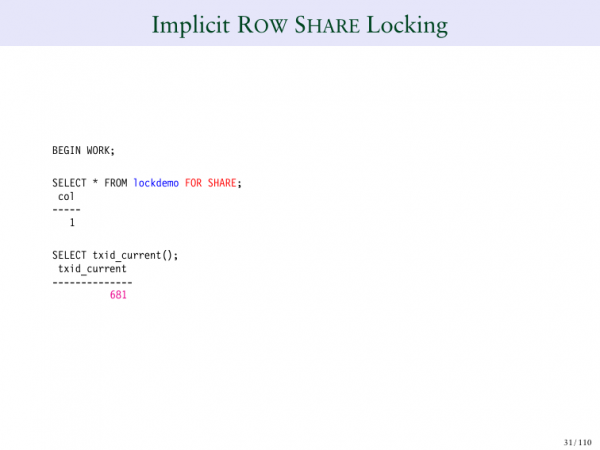
Vamos pegar um exemplo. SELECT ROW SHARE é uma forma de bloquear cada linha individualmente.. Assim, ninguém pode excluí-las ou alterá-las enquanto as estamos visualizando.
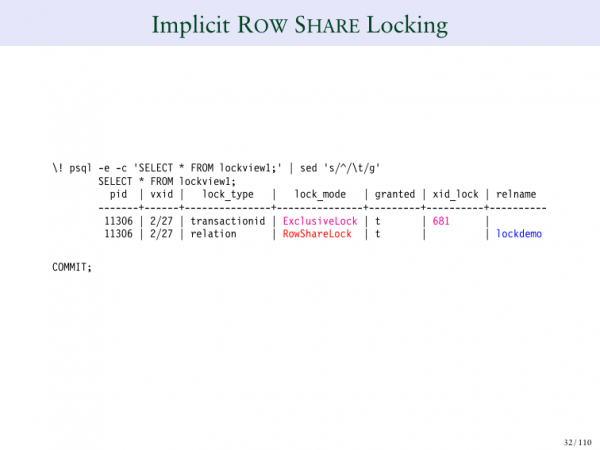 Então, o que faz o SHARE LOCK? Vemos que o ID da transação é 681 para o SELECT. E isso é interessante. O que aconteceu aqui? Pela primeira vez, vemos um número no campo "Lock". Pegamos o ID da transação, e ele diz que bloqueia-a em modo exclusivo. Tudo o que ele faz é afirmar que há uma linha que está tecnicamente bloqueada em algum lugar da tabela. Mas não diz onde exatamente. Mais adiante, veremos isso com mais detalhes.
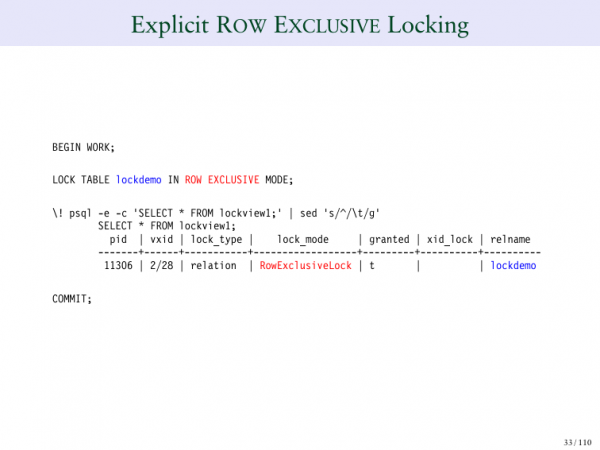
Aqui, estamos dizendo que o bloqueio é usado por nós.
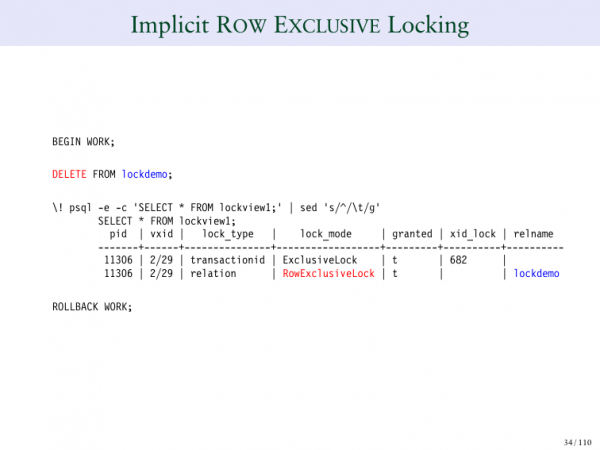
Portanto, o bloqueio exclusivo diz explicitamente que é exclusivo. E também, se você excluir uma linha nessa tabela, isso realmente acontecerá, como você pode ver.
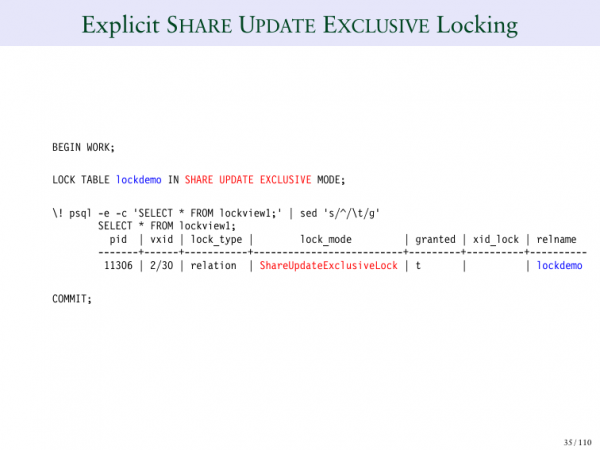
SHARE EXCLUSIVE – esse é um bloqueio mais longo.
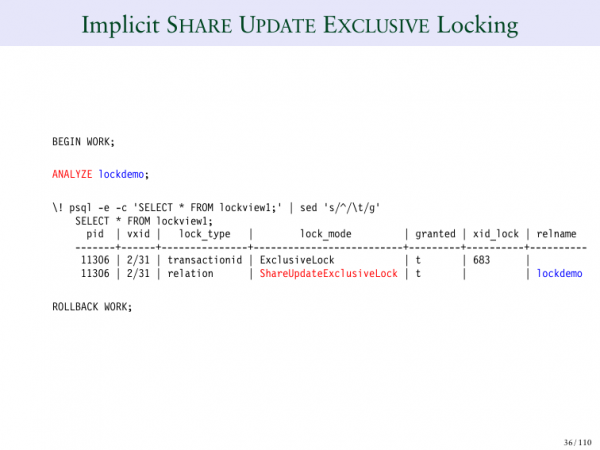
Este (ANALYZE) é um comando do analisador que será utilizado.
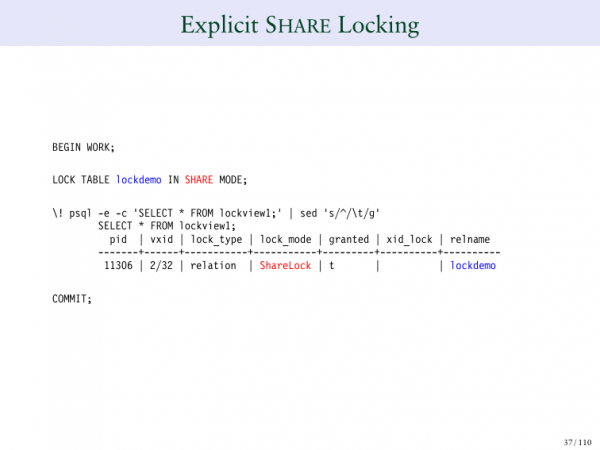
SHARE LOCK – você pode explicitamente bloquear em modo share.
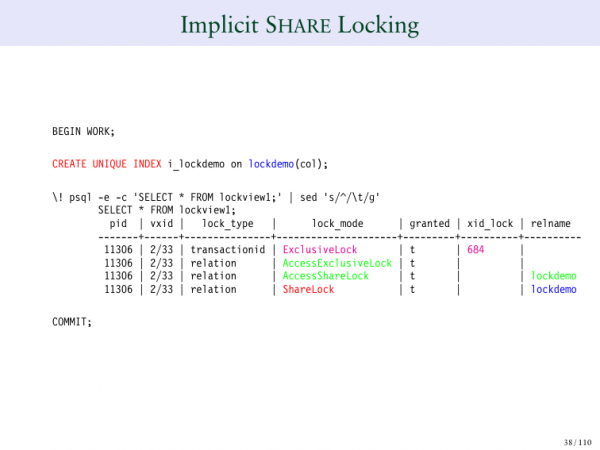
Você também pode criar um índice único. E lá você pode ver o SHARE LOCK, que faz parte dele. E ele bloqueia a tabela e aplica um bloqueio SHARE LOCK sobre ela.
Por padrão, o SHARE LOCK na tabela significa que outras pessoas podem ler a tabela, mas ninguém pode modificá-la. E é isso que acontece quando você cria um índice único.
Se eu criar um índice único concurrently, então terei um tipo diferente de bloqueio, porque, como você lembra, o uso de índices concurrently reduz a necessidade de bloqueio. E se eu usar um bloqueio normal, um índice normal, então assim impedirei a gravação no índice da tabela durante sua criação. Se eu usar um índice concurrently, preciso usar um tipo diferente de bloqueio.
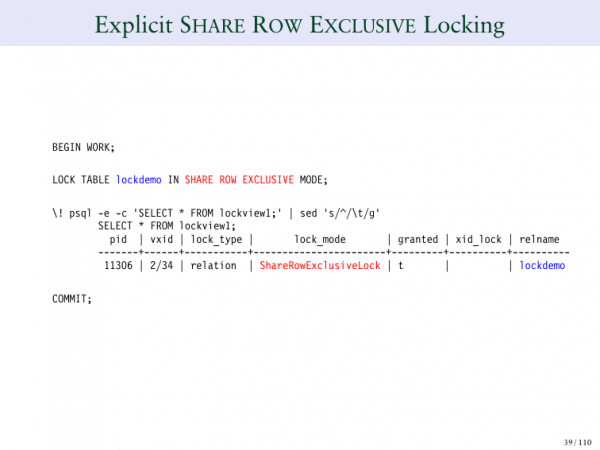
SHARE ROW EXCLUSIVE – novamente, pode ser definido explicitamente.
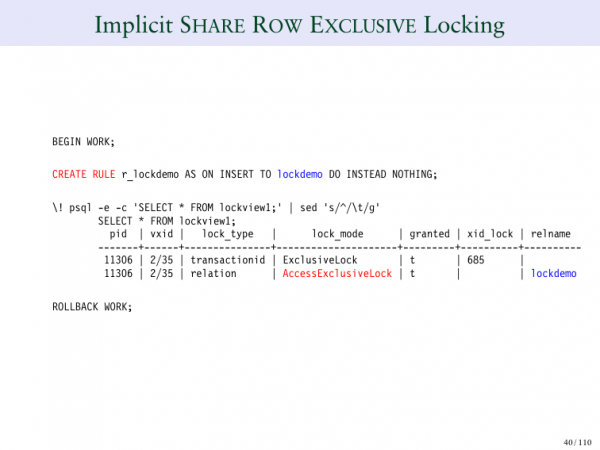
Ou podemos criar uma regra, ou seja, pegar algum caso específico em que ele será utilizado.
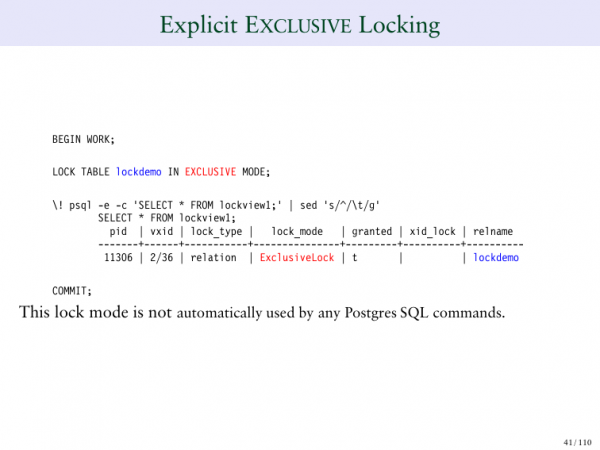
O bloqueio EXCLUSIVE significa que ninguém mais poderá alterar a tabela.
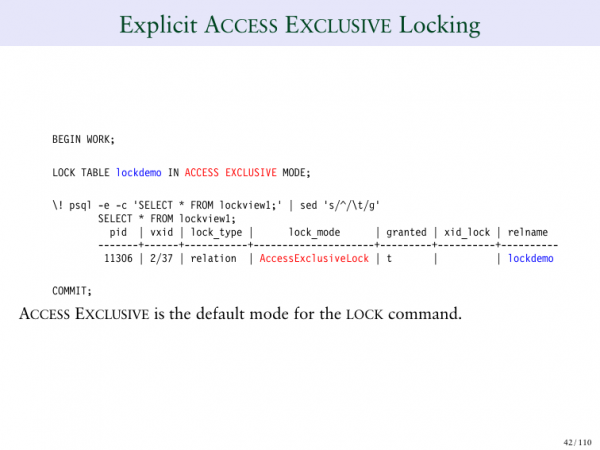
Aqui vemos diferentes tipos de bloqueios.
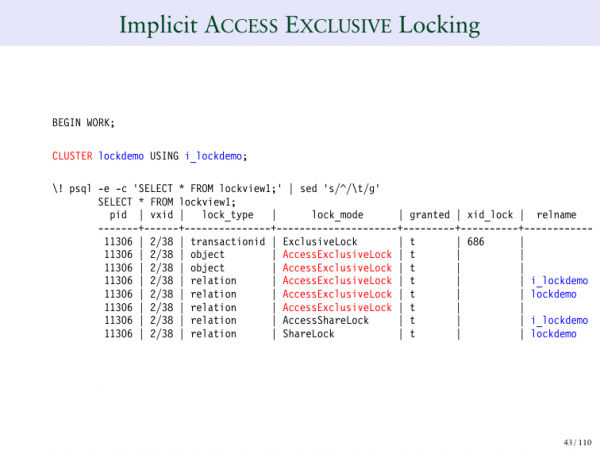
ACCESS EXCLUSIVE, por exemplo, é um comando de bloqueio. Por exemplo, se você fizer CLUSTER table, isso significará que ninguém poderá gravar lá. E ele bloqueia não apenas a própria tabela, mas também os índices.
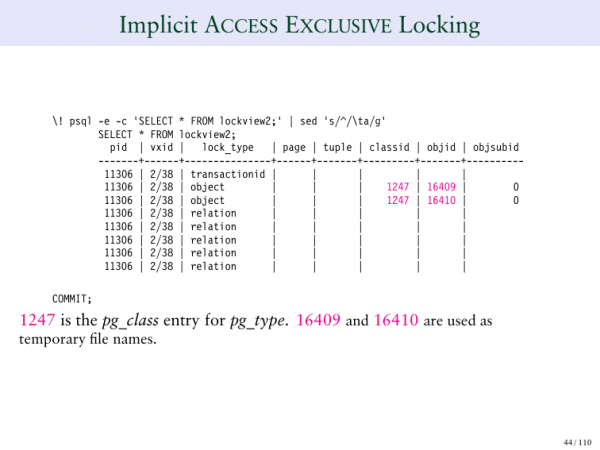
Esta é a segunda página do bloqueio ACCESS EXCLUSIVE, onde vemos especificamente o que ele bloqueia na tabela. Ele bloqueia linhas individuais da tabela, o que é bastante interessante.
Esta é toda a informação básica que eu queria fornecer. Falamos sobre bloqueios, sobre IDs de transação, discutimos IDs virtuais de transação, e IDs permanentes de transação.
Agora vamos passar para exemplos de bloqueios. Esta é a parte mais interessante. Vamos ver casos muito interessantes. E meu objetivo nesta apresentação é dar a vocês uma melhor compreensão do que o Postgres realmente faz quando tenta bloquear certas coisas. Acredito que ele é muito eficiente em bloquear partes específicas.
Vamos considerar alguns exemplos específicos.
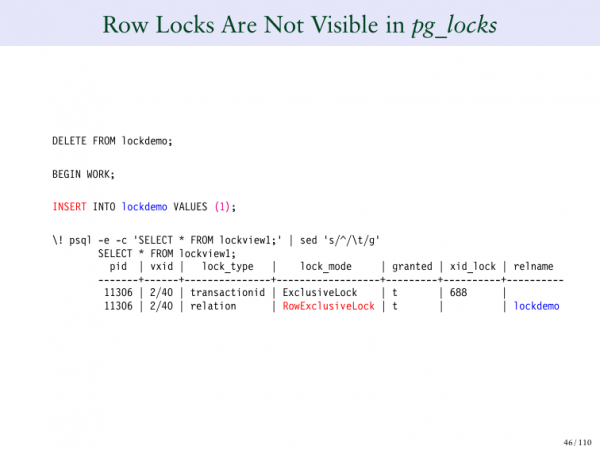
Começaremos com tabelas e com uma linha na tabela. Quando eu insiro algo, ele mostra ExclusiveLock, o ID da transação e o ExclusiveLock na tabela.
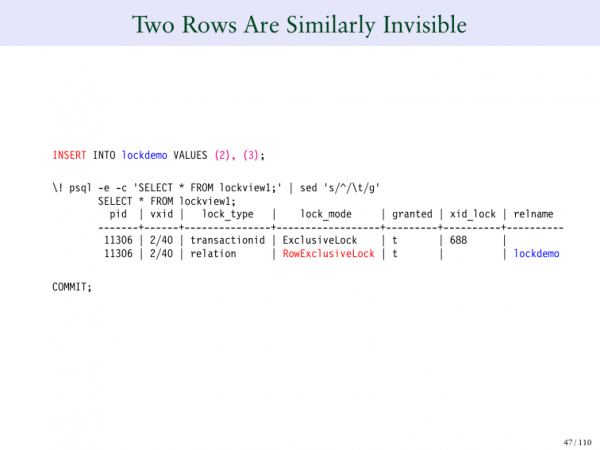
E o que acontece se eu inserir mais duas linhas? Agora temos três linhas na nossa tabela. Eu inseri uma linha e obtive isso como saída. E se eu inserir mais duas linhas, o que há de estranho aqui? A estranheza está em que eu adicionei três linhas a esta tabela, mas ainda tenho duas linhas na tabela de bloqueios. E isso é, essencialmente, o comportamento fundamental do Postgres.
Muitos pensam que se bloquearem 100 linhas em um banco de dados, precisarão criar 100 entradas de bloqueio. Se eu bloquear 1.000 linhas de uma só vez, então precisarei de 1.000 dessas solicitações. E se eu precisar bloquear um milhão ou um bilhão. Mas se for assim que fizermos, não funcionará muito bem. Se você usou um sistema que cria entradas de bloqueio para cada linha individual, verá que isso é complicado. Porque você precisa definir a tabela de bloqueio imediatamente, que pode se sobrecarregar, mas o Postgres não faz dessa forma.
E neste slide é muito importante que aqui está claramente demonstrado que existe outro sistema que opera dentro do MVCC, que bloqueia linhas individuais. Portanto, quando você bloqueia bilhões de linhas, o Postgres não cria bilhões de comandos de bloqueio individuais. E isso tem um efeito muito positivo no desempenho.
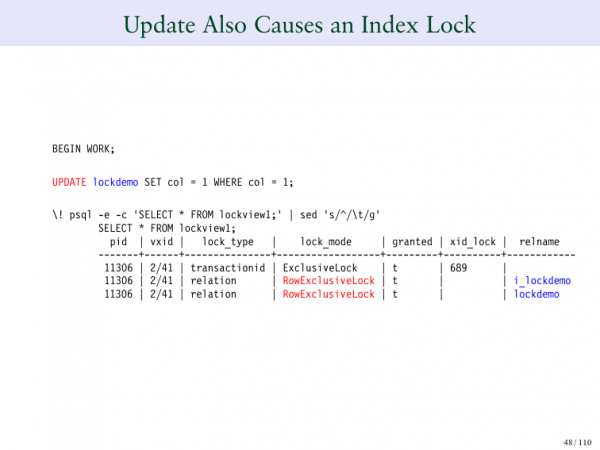
E quanto à atualização? Estou atualizando uma linha agora, e você pode notar que ele imediatamente executou duas operações diferentes. Ele bloqueou a tabela ao mesmo tempo, mas também bloqueou o índice. E ele precisava bloquear o índice porque há restrições únicas nessa tabela. Queremos garantir que ninguém a modifique, então a bloqueamos.
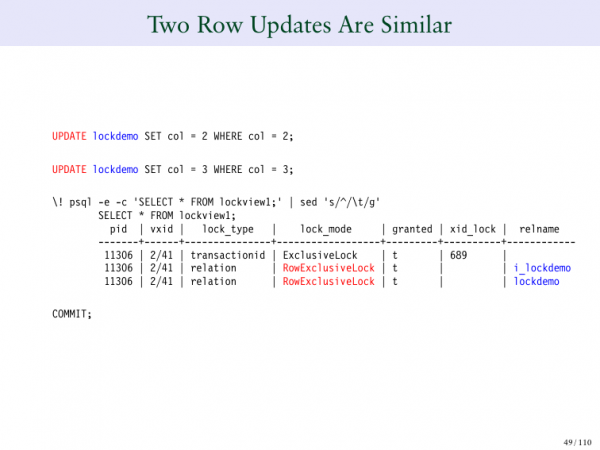
E se eu quiser atualizar duas linhas? E vemos que ele se comporta da mesma forma. Estamos realizando o dobro de atualizações, mas exatamente a mesma quantidade de linhas bloqueadas.
Se você está curioso sobre como o Postgres faz isso, você precisa ouvir minhas palestras sobre MVCC para entender como o Postgres marca internamente essas linhas que ele modifica. E o Postgres tem uma maneira de fazer isso, mas não o faz no nível de bloqueio de tabelas; ele faz em um nível mais baixo e mais eficiente.
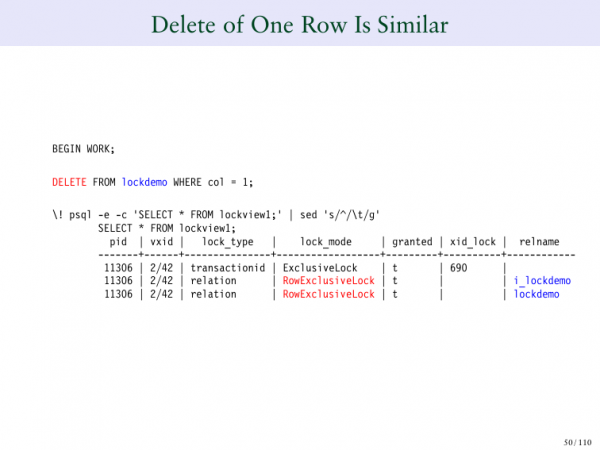
E se eu quiser remover algo? Se eu remover, por exemplo, uma linha e ainda tiver meus dois pontos de entrada de bloqueio, mesmo que eu queira removê-los todos, eles ainda estarão presentes.
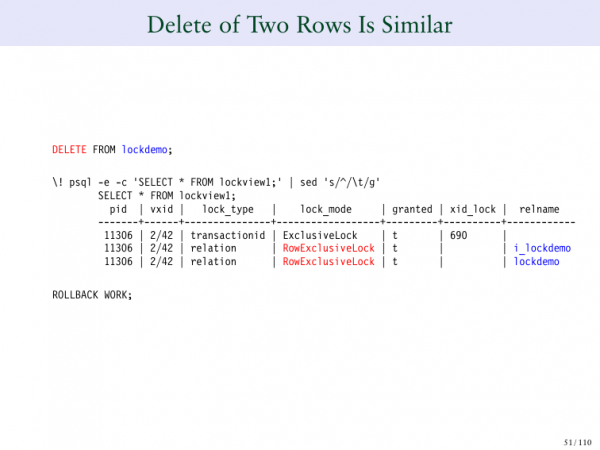
E, por exemplo, se eu quiser inserir 1.000 linhas e depois ou remover ou adicionar 1.000 linhas, então as linhas individuais que estou adicionando ou modificando não são registradas aqui. Elas são registradas em um nível mais baixo dentro da própria linha. E durante a palestra sobre MVCC eu falei sobre isso em detalhes. Mas é muito importante, ao analisar bloqueios, garantir que você tenha um bloqueio no nível da tabela e que aqui você não veja como as gravações de linhas individuais estão sendo feitas.
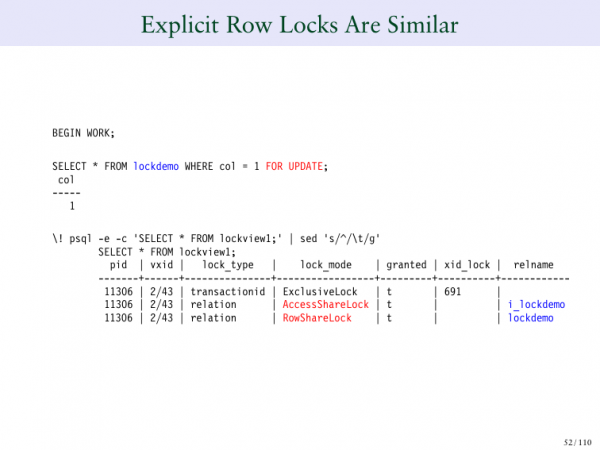
E quanto ao bloqueio explícito?
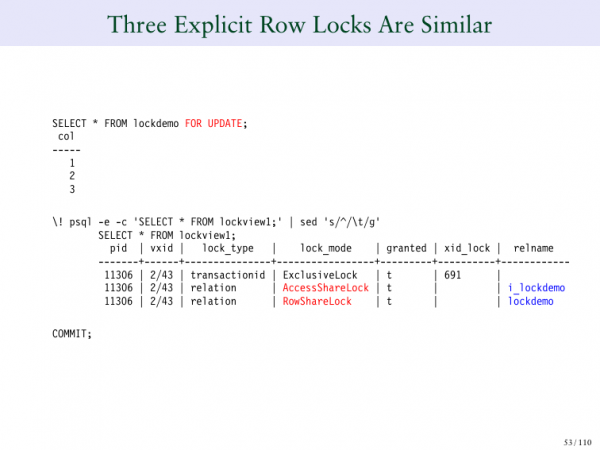
Se eu clicar em "atualizar", tenho duas linhas bloqueadas. E se eu selecioná-las todas e clicar em "atualizar tudo", ainda assim restarão duas gravações de bloqueio.
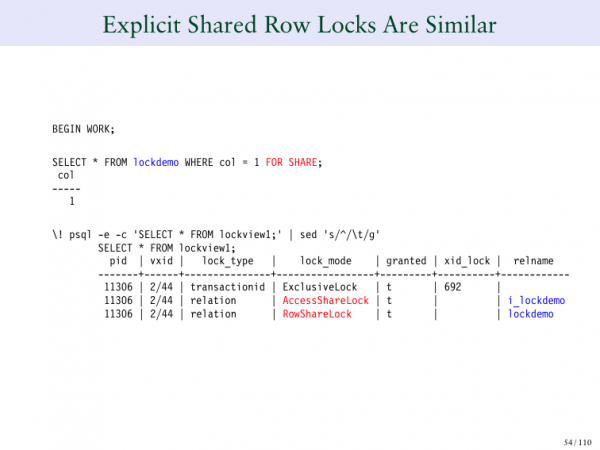
Não criamos registros separados para cada linha individual. Porque então a performance despenca, pode haver muitos deles. E podemos nos encontrar em uma situação complicada.
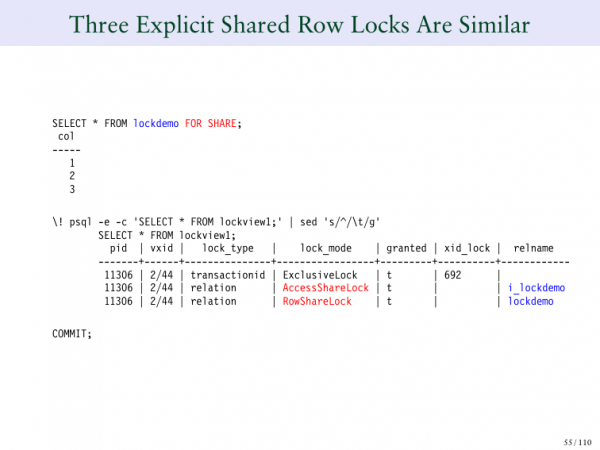
E o mesmo ocorre se fizermos shared; podemos fazer isso para as 30 vezes.
Estamos restaurando nossa tabela, removendo tudo e depois inserindo novamente uma linha.
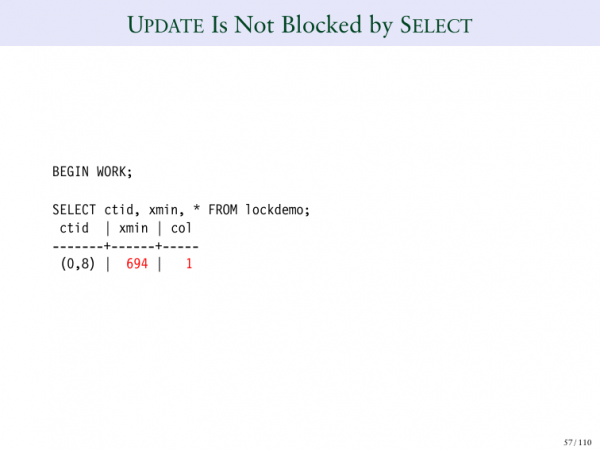
Outro tipo de comportamento que você vê no Postgres é um comportamento muito bem conhecido e desejado - você pode realizar updates ou selects. E você pode fazer isso simultaneamente. E os selects não bloqueiam os updates e vice-versa. Estamos dizendo ao leitor para não bloquear quem escreve, e quem escreve não bloquear o leitor.
Vou lhe mostrar um exemplo disso. Vou fazer uma seleção agora. Depois faremos um INSERT. E você poderá ver - 694. Você verá o ID da transação que fez essa inserção. E é assim que funciona.
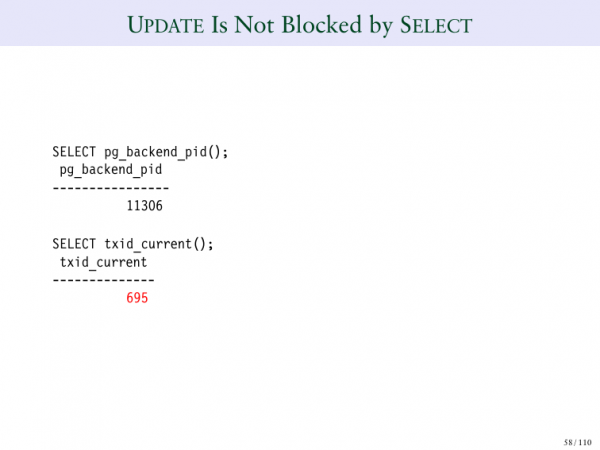
E se agora eu olhar para o meu ID de backend, ele mudou para - 695.
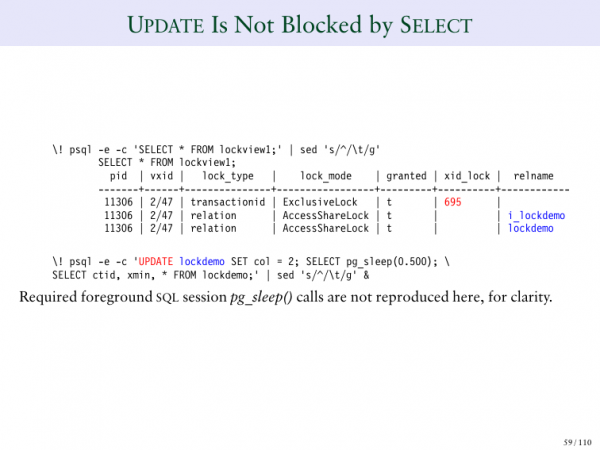
E posso ver que 695 aparece na minha tabela.
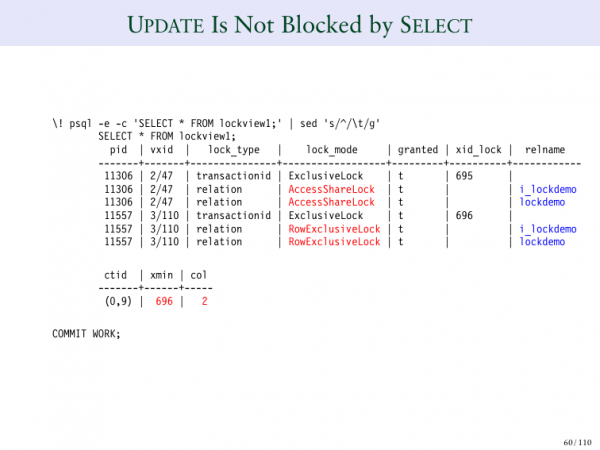
E se eu realizar uma atualização aqui assim, então eu obtenho outro caso. Nesse caso, 695 é um bloqueio exclusivo, e o update tem um comportamento semelhante, mas não há conflito entre eles, o que é bastante incomum.
E você pode notar que na parte de cima está o ShareLock, e na parte de baixo está o ExclusiveLock. E ambas as transações foram concluídas.
E você precisa ouvir minha apresentação sobre MVCC para entender como isso acontece. Mas essa é uma ilustração do que você pode fazer ao mesmo tempo, ou seja, fazer SELECT e UPDATE simultaneamente.
Vamos reiniciar e fazer mais uma operação.
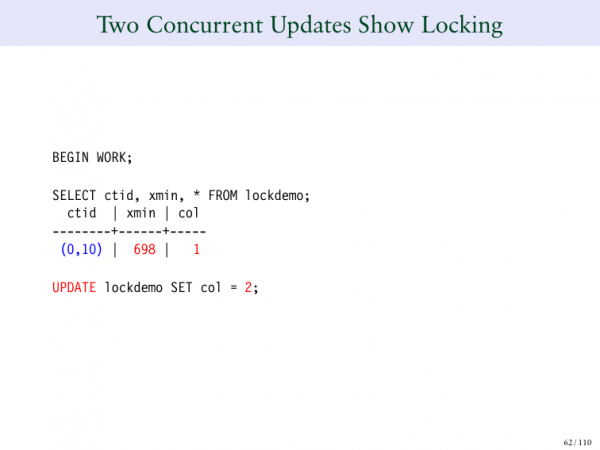
Se você tentar executar simultaneamente dois updates na mesma linha, ocorrerá um bloqueio. E lembre-se, eu disse que o leitor não bloqueia o escritor, e o escritor bloqueia o leitor, mas um escritor bloqueia outro escritor. Ou seja, não podemos permitir que duas pessoas atualizem a mesma linha ao mesmo tempo. É necessário esperar que um deles termine.
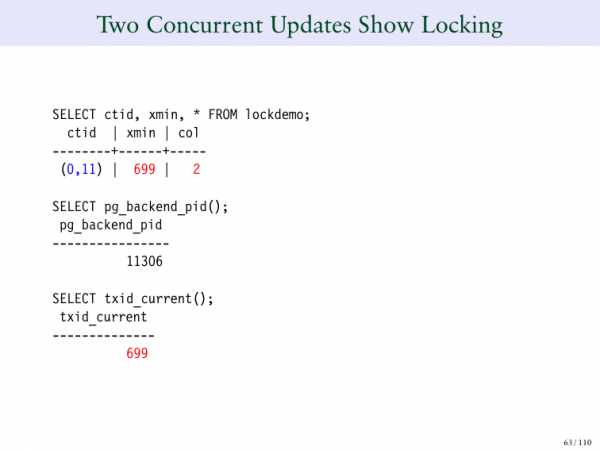
E para ilustrar isso, vou olhar para a tabela Lockdemo. E vamos ver uma linha. Na transação 698.
Nós a atualizamos para 2. 699 é a primeira atualização. E ela foi bem-sucedida ou está em uma transação pendente, aguardando que confirmemos ou cancelamos.
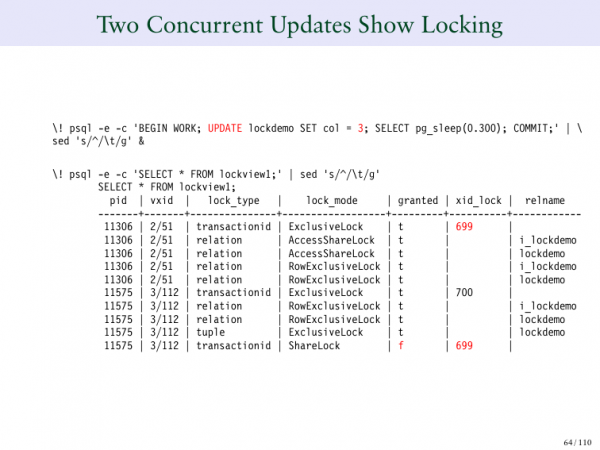
Mas olhem para o outro – 2/51 – esta é nossa primeira transação, nossa primeira sessão. 3/112 – esta é a segunda solicitação que apareceu por cima e que mudou esse valor para 3. E se você notar, o primeiro bloqueou a si mesmo, que é 699. Mas 3/112 não forneceu bloqueio. Na coluna Lock_mode, está escrito que ele está aguardando. Ele está aguardando 699. E se você olhar onde está 699, está acima. E o que a primeira sessão fez? Criou um bloqueio exclusivo em seu próprio ID de transação. É assim que o Postgres faz. Ele bloqueia seu próprio ID de transação. E se você quiser esperar até que alguém confirme ou cancele, você precisa esperar até que haja uma transação em espera. E por isso podemos ver uma linha estranha.
Vamos dar mais uma olhada. À esquerda, vemos nosso ID de processamento. Na segunda coluna, vemos nosso ID de transação virtual, e na terceira vemos o lock_type. O que isso significa? Essencialmente, ele diz que bloqueia o ID de transação. Mas observe que em todas as linhas abaixo está escrito relation. E por isso você tem dois tipos de bloqueio na tabela. Há o bloqueio relation. E também há o bloqueio transactionid, onde você bloqueia a si mesmo, é exatamente isso que acontece na primeira linha ou na parte inferior, onde transationid, onde estamos aguardando que 699 finalize sua operação.
Estou observando o que está acontecendo aqui. E aqui ocorrem duas coisas ao mesmo tempo. Você está olhando para o bloqueio pelo ID de transação na primeira linha, que se bloqueia. E ele se bloqueia para fazer as pessoas aguardarem.
Se você olhar a 6ª linha, verá que o mesmo registro da primeira. E por isso a transação 699 está bloqueada. 700 também se bloqueia. E depois na linha inferior você verá que estamos esperando que 699 finalize sua operação.
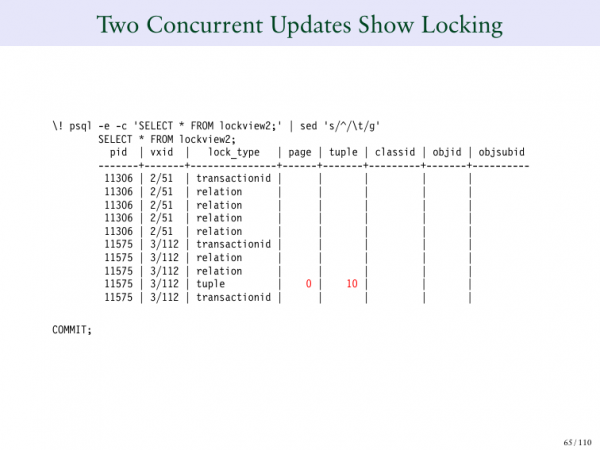
E no lock_type, tuple você vê os números.
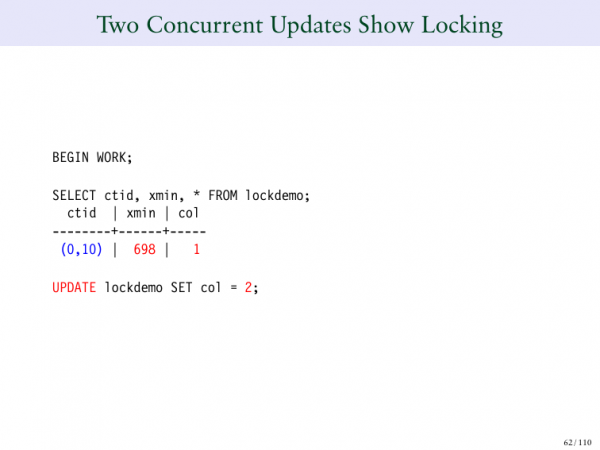
Você pode ver que é 0/10. E este é o número da página, e também o offset dessa linha específica.
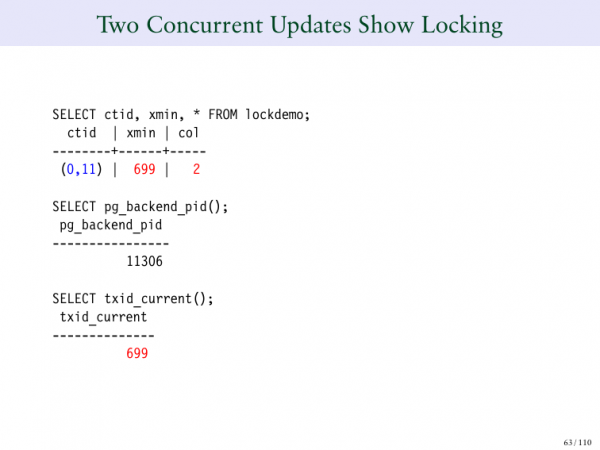
E você vê que se torna 0/11 quando atualizamos.
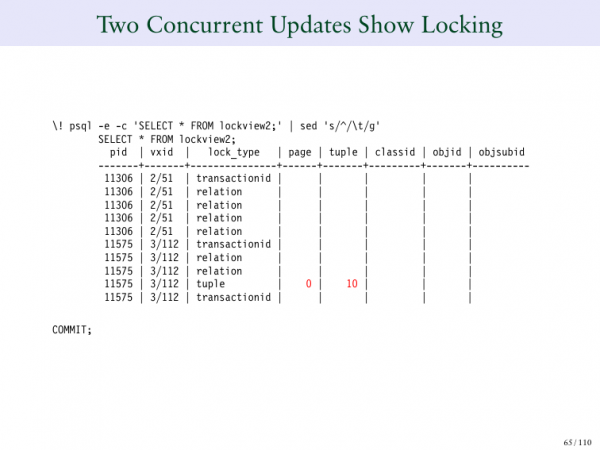
Mas na verdade – é 0/10, porque ocorre a espera dessa operação. Temos a oportunidade de ver que esta é a linha que estou aguardando para confirmar.
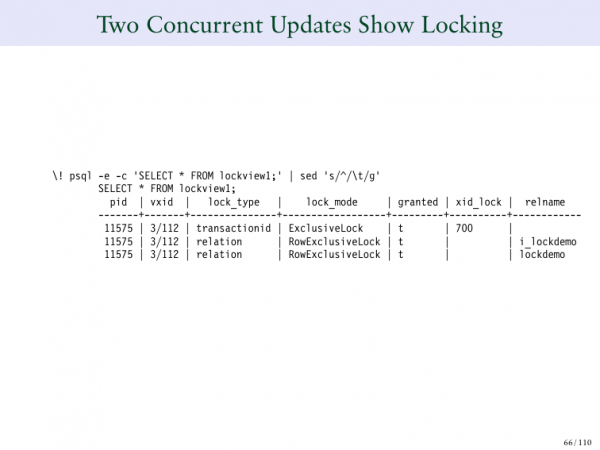
Assim que o confirmamos e pressionamos 'commit', e quando a atualização terminou, isso é o que recebemos novamente. A transação 700 é o único bloqueio, não está esperando mais ninguém, pois foi comitada. Ela apenas aguarda a conclusão da transação. Assim que a 699 termina, não esperamos mais nada. E agora a transação 700 diz que está tudo bem, que todos os bloqueios necessários estão em todas as tabelas permitidas.
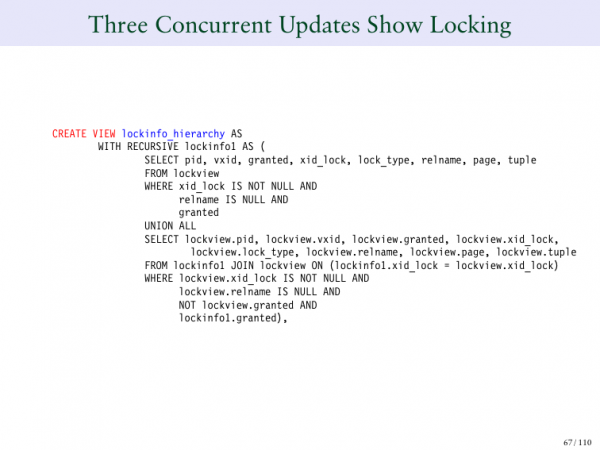
E para complicar ainda mais, criamos outra view, que desta vez nos fornecerá uma hierarquia. Não espero que você entenda essa consulta. Mas isso nos dará uma visão mais clara do que está acontecendo.
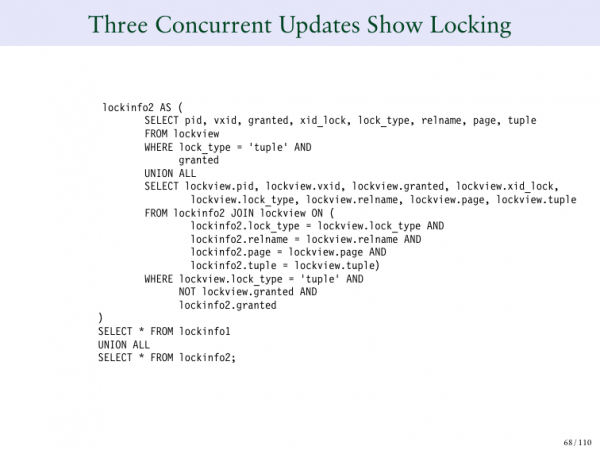
Esta é uma view recursiva, que também tem outra seção. E depois, isso retorna tudo junto. Vamos usar isso.
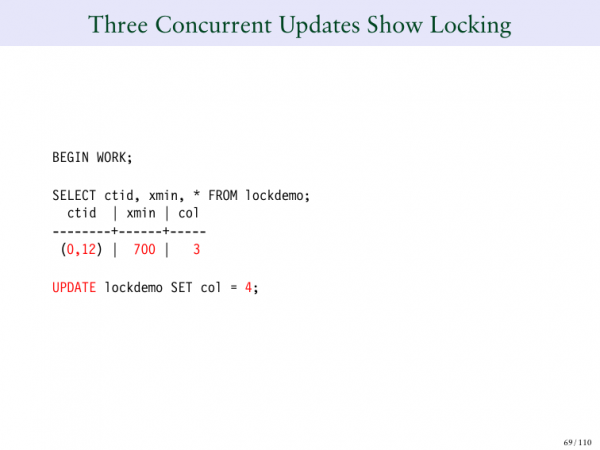
E se fizermos três atualizações simultâneas e dissermos que a fila agora é igual a três. E mudarmos 3 para 4.
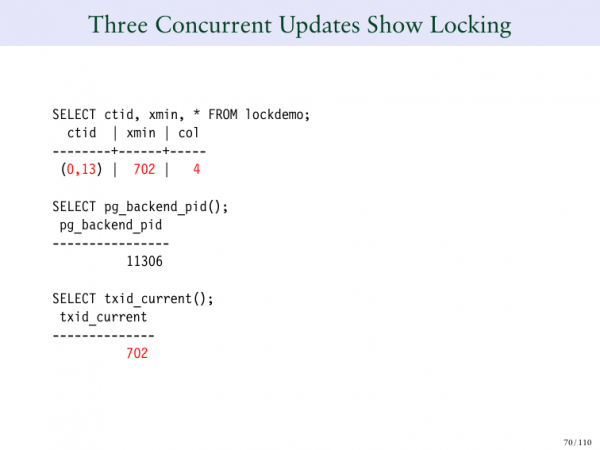
E aqui vemos 4. E o ID da transação 702.
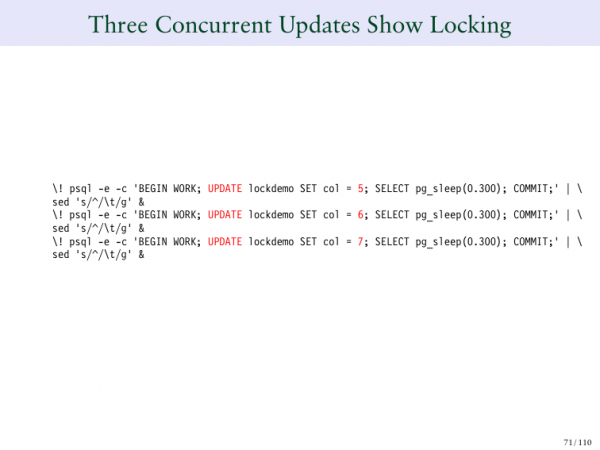
E então eu mudo 4 para 5. E 5 para 6, e 6 para 7. E eu coloco em fila as pessoas que estarão esperando que essa única transação termine.
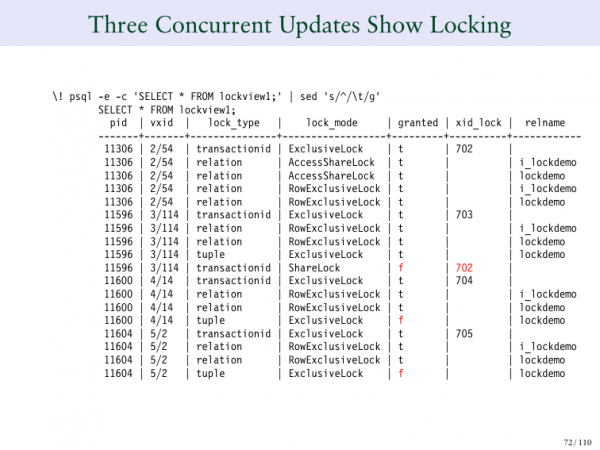
E tudo se torna claro. Qual é a primeira fila? É 702. Este é o ID da transação que inicialmente definiu esse valor. E o que está escrito na coluna Granted? Eu tenho marcações f. Essas são minhas atualizações, que (5, 6, 7) não podem ser aprovadas, porque estamos esperando que a transação ID 702 termine. Temos um bloqueio do ID da transação. E resulta em 5 bloqueios de transação ID.
E se você olhar para 704, para 705, ainda não foi escrito nada, porque eles ainda não sabem o que está acontecendo. Eles apenas escrevem que não têm ideia do que está acontecendo. E eles simplesmente entrarão em modo de espera, porque estão esperando que alguém termine e os acorde quando houver a oportunidade de mudar a fila.
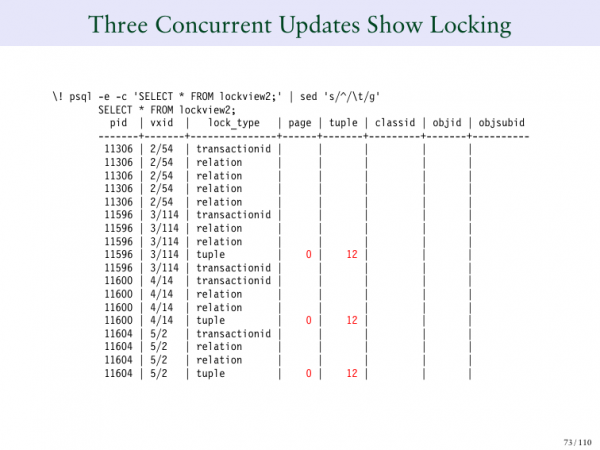
É assim que parece. Fica claro que todos estão esperando pela 12ª linha.
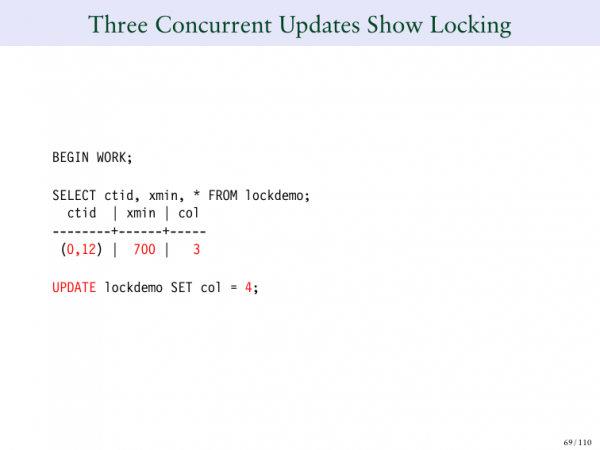
É isso que vimos aqui. Aqui está 0/12.
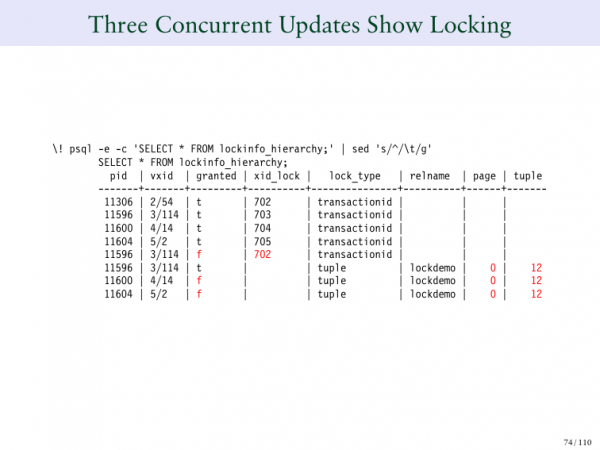
Então, assim que a primeira transação é aprovada, você pode ver aqui como a hierarquia funciona. E agora tudo se torna claro. Eles todos ficam livres. E na verdade, ainda estão esperando.
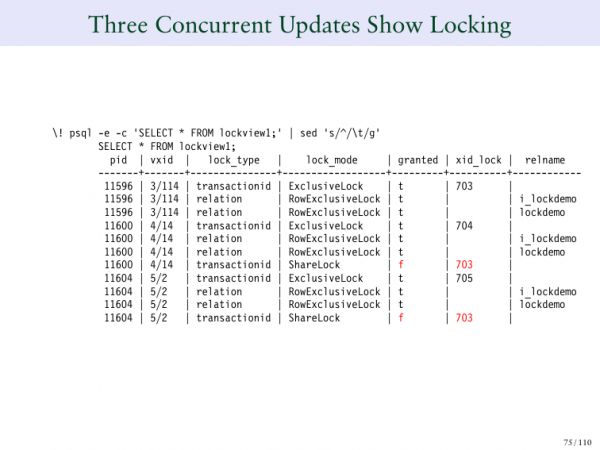
Aqui está o que acontece. O 702 faz o commit. E agora o 703 recebe esse bloqueio da linha, e então o 704 começa a esperar que o 703 faça o commit. E o 705 também está esperando por isso. E quando tudo isso termina, eles se limpam. E eu gostaria de apontar que todos se alineam em uma fila. E isso é muito parecido com uma situação de engarrafamento, onde todos estão esperando o primeiro carro. O primeiro carro parou, e todos se alinham em uma longa linha. Então ele se move, depois o próximo carro pode passar à frente e receber seu bloqueio e assim por diante.
E se você achar que isso é complicado o suficiente, agora vamos falar sobre deadlocks. Eu não sei quem de vocês já se deparou com isso. É um problema bastante comum em sistemas de banco de dados. Mas deadlocks são aqueles casos em que uma sessão espera que outra sessão execute algo. E, nesse momento, a outra sessão espera que a primeira sessão execute alguma coisa.
E, por exemplo, se Ivan diz: "Me dá algo", e eu digo: "Não, eu te dou isso apenas se você me der outra coisa". E ele diz: "Não, eu não vou te dar isso se você não me der". E nós acabamos em uma situação de deadlock. Eu tenho certeza de que Ivan não faria isso, mas você entende o sentido, que temos duas pessoas querendo algo e não estão dispostas a dar isso até que a outra pessoa lhes dê o que querem. E não há solução aqui.
E, essencialmente, seu banco de dados precisa identificar isso. E então é necessário eliminar ou encerrar uma das sessões, porque caso contrário, elas permanecerão lá para sempre. E vemos isso em bancos de dados, vemos isso em sistemas operacionais. E em todos os lugares onde temos processos paralelos, isso pode acontecer.
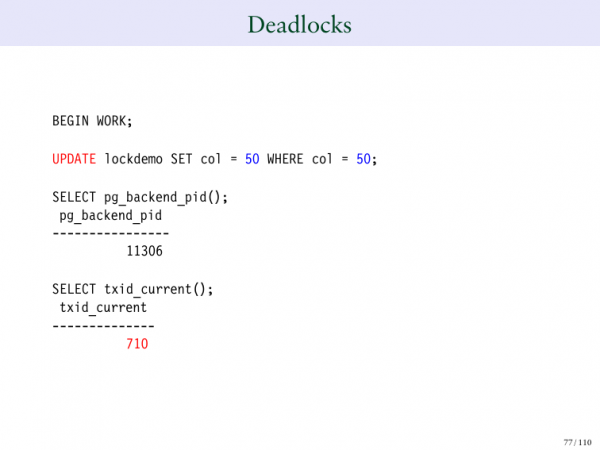
E agora vamos definir dois deadlocks. Vamos colocar 50 e 80. Na primeira linha, farei uma atualização de 50 para 50. Vou receber o número da transação 710.
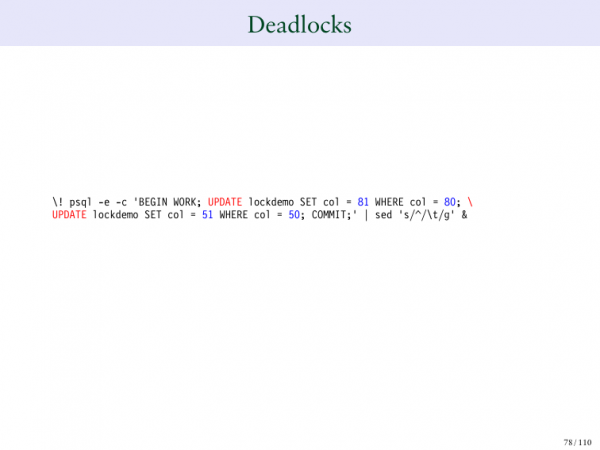
E então eu mudarei 80 para 81, e 50 para 51.
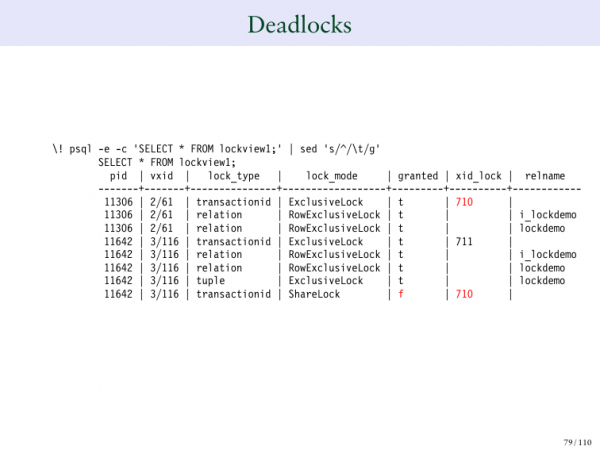
E é assim que isso vai parecer. Por isso, o 710 tem um bloqueio de linha, e o 711 aguarda a confirmação. Vimos isso quando atualizamos. O 710 é o proprietário da nossa linha. E o 711 espera que o 710 conclua a transação.
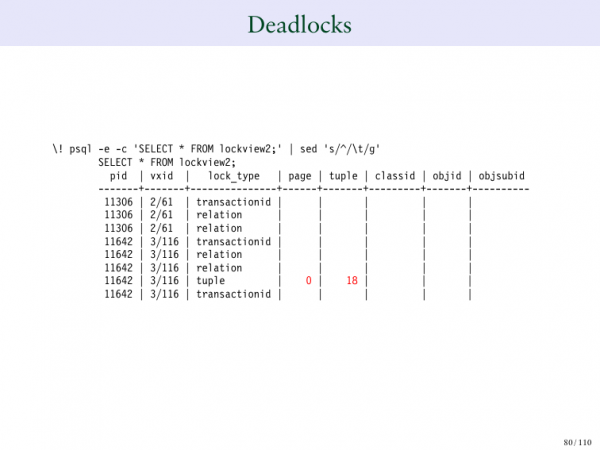
E está até escrito em qual linha estamos tendo deadlocks. E é aqui que isso começa a ficar estranho.
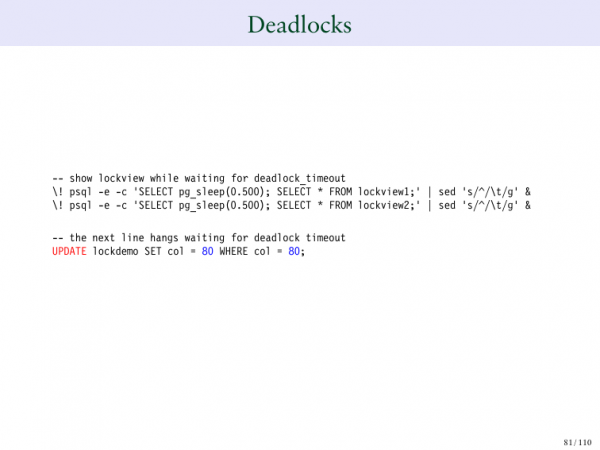
Agora estamos atualizando 80 para 80.
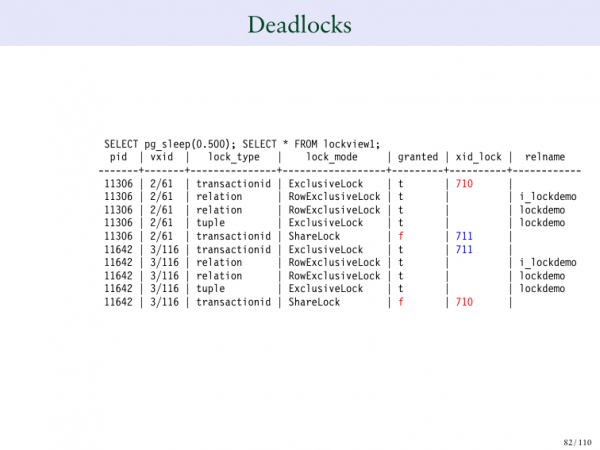
E é aqui que os deadlocks começam. 710 está aguardando uma resposta de 711, enquanto 711 está aguardando 710. E isso não vai terminar bem. Não há saída para isso. Eles ficarão aguardando a resposta um do outro.
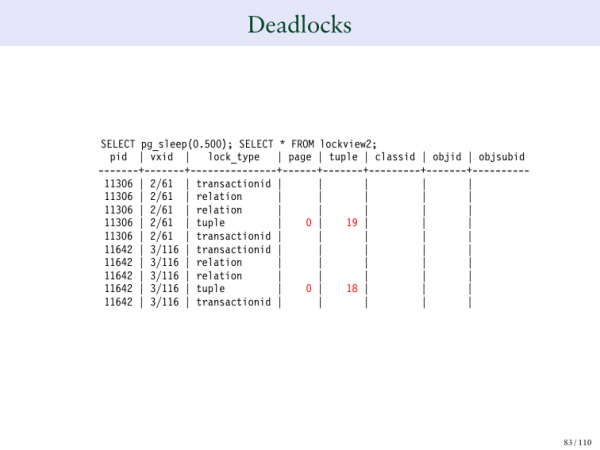
E isso simplesmente começará a causar atrasos. E nós não queremos isso.
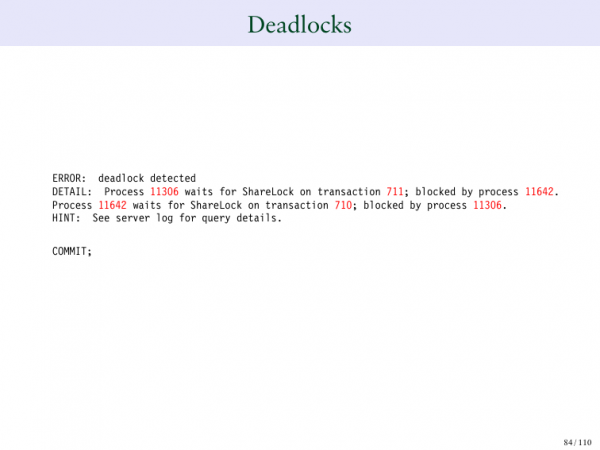
E no Postgres existem formas de detectar quando isso acontece. E quando isso ocorre, você recebe um erro como este. E fica claro que um determinado processo está aguardando um SHARE LOCK de outro processo, ou seja, que está bloqueado pelo processo 711. E esse processo estava aguardando que um SHARE LOCK fosse concedido a um determinado ID de transação e estava bloqueado por um determinado processo. Portanto, esta é uma situação de deadlock.
E há deadlocks de três vias? Isso é possível? Sim.
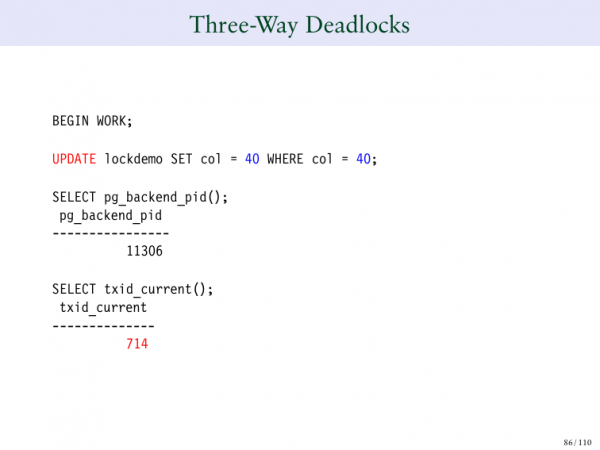
Inserimos esses números na tabela. Alteramos 40 para 40, fazemos o bloqueio.
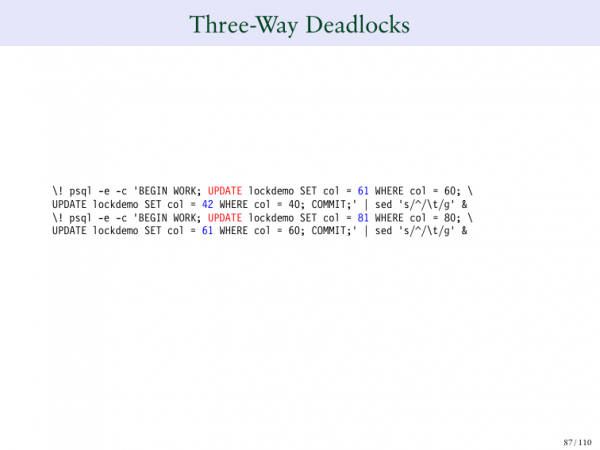
Alteramos 60 para 61, 80 para 81.
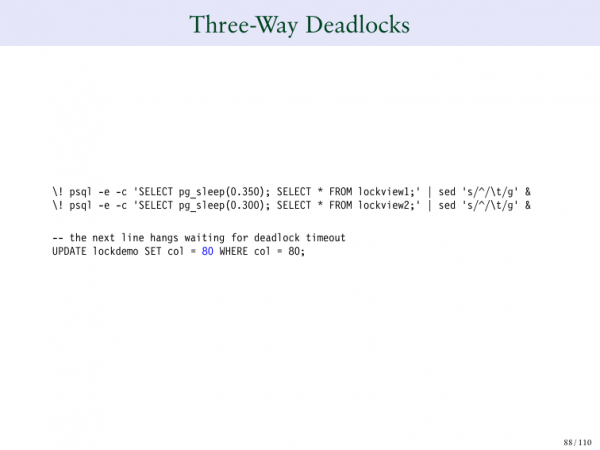
E então mudamos 80, e então – boom!
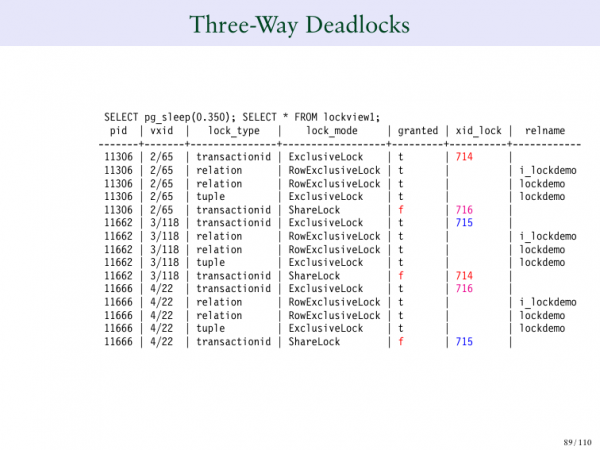
E 714 agora aguarda 715. O 716 aguarda o 715. E não há nada que se possa fazer com isso.
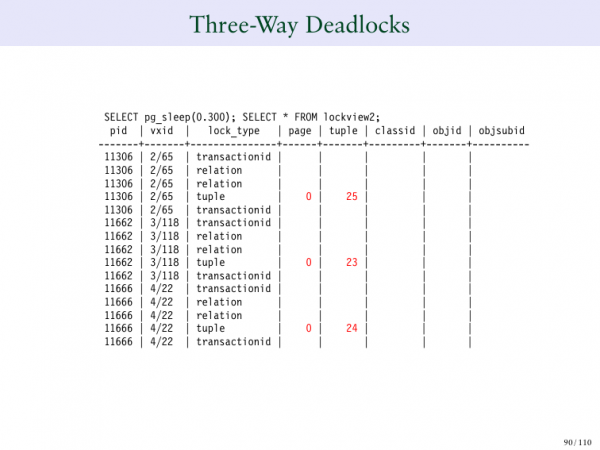
Aqui não são apenas duas pessoas, são três. Eu quero algo de você, este quer algo do terceiro, e o terceiro quer algo de mim. E entramos em uma espera mútua, porque todos estamos esperando que a outra pessoa termine o que deve fazer.
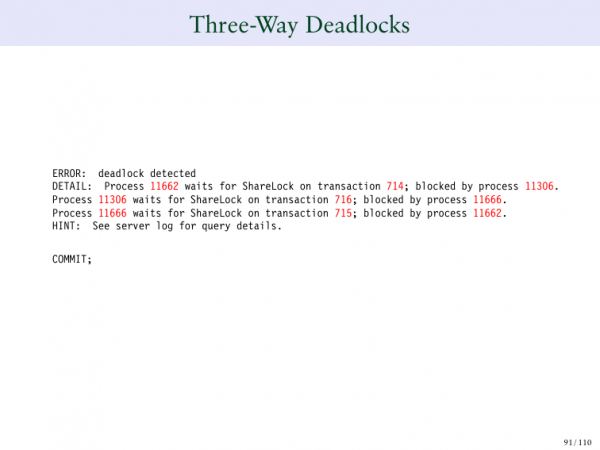
E o Postgres sabe em qual linha isso acontece. E por isso, ele fornecerá a você a seguinte mensagem, que mostra que você tem um problema onde três entradas estão bloqueando umas às outras. E aqui não há restrições. Isso pode ocorrer em uma situação onde 20 registros estão se bloqueando mutuamente.
O próximo problema é o serializable.
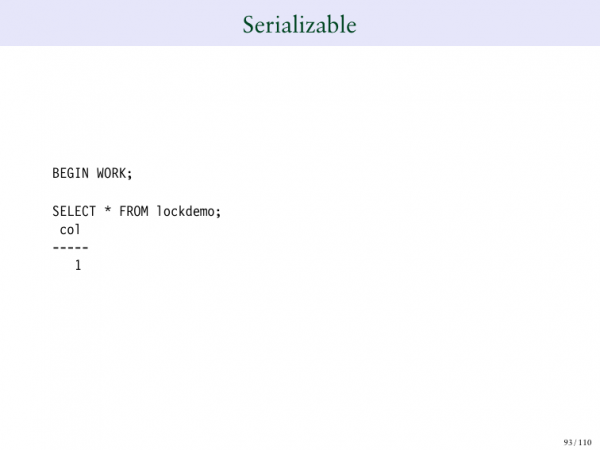
Se houver um bloqueio serializable especial.
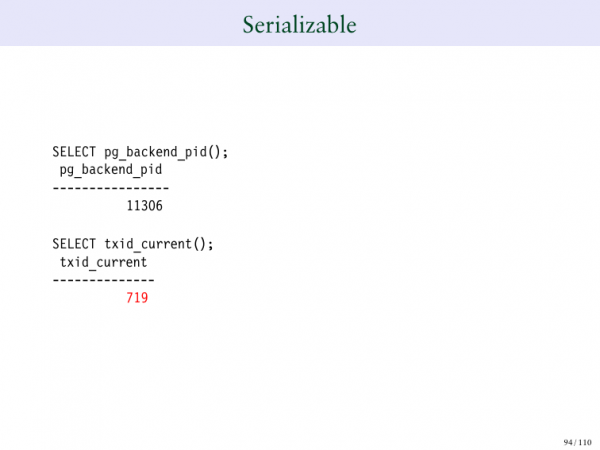
E voltamos ao 719. Ele tem uma saída perfeitamente normal.
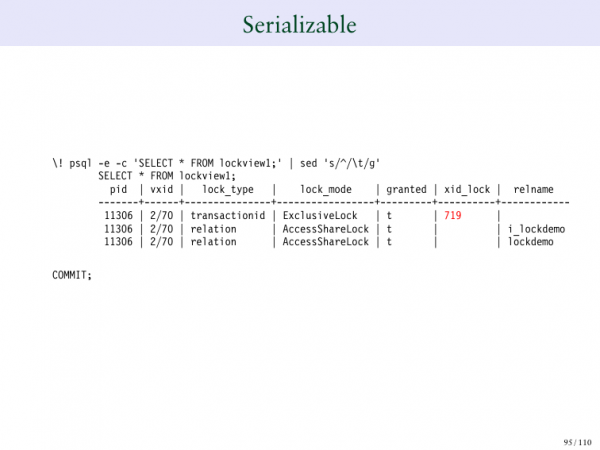
E você pode clicar para fazer a transação a partir de serializable.
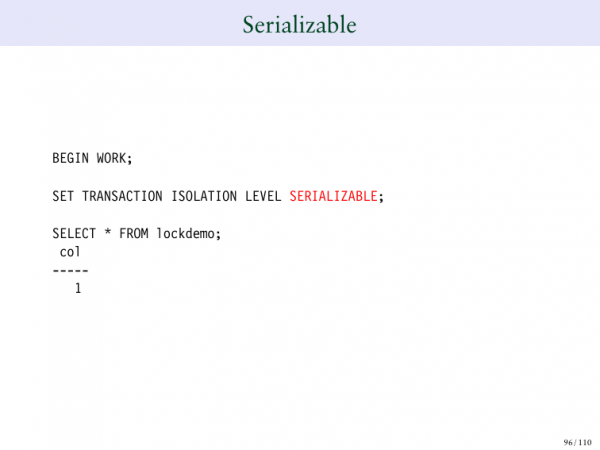
E você percebe que agora tem outro tipo de bloqueio SA – isso significa serializable.
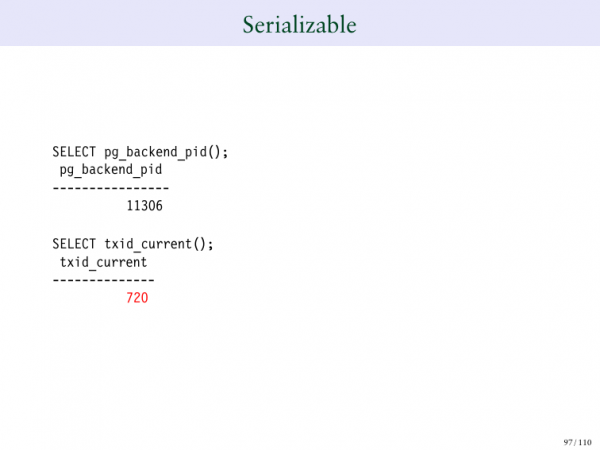
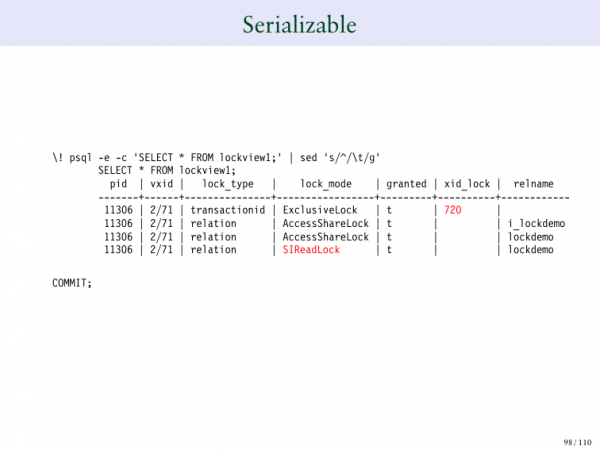
E por isso temos um novo tipo de bloqueio chamado SARieadLock, que é um bloqueio serial e permite a inserção de serializações.
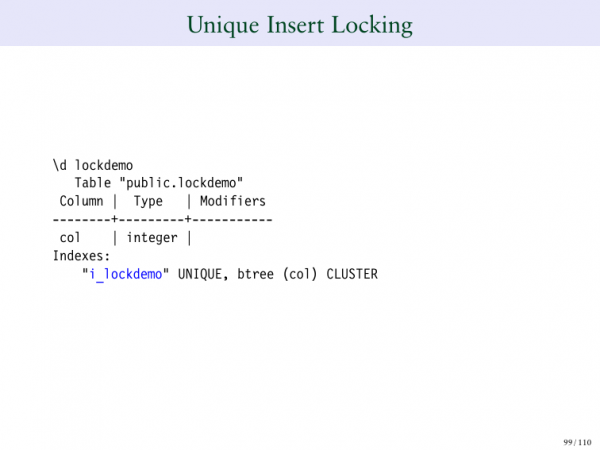
E você também pode inserir índices únicos.
Nesta tabela, temos índices únicos.
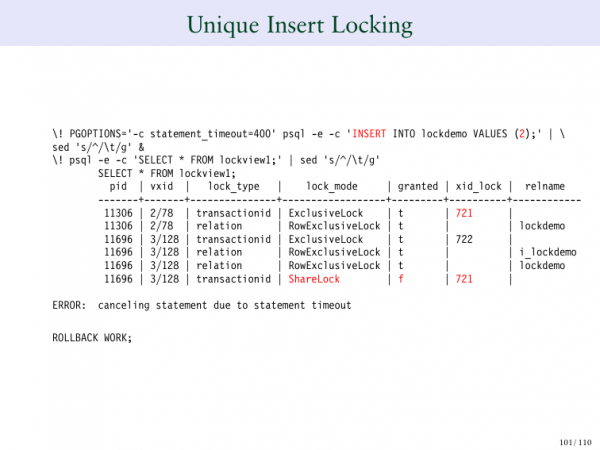
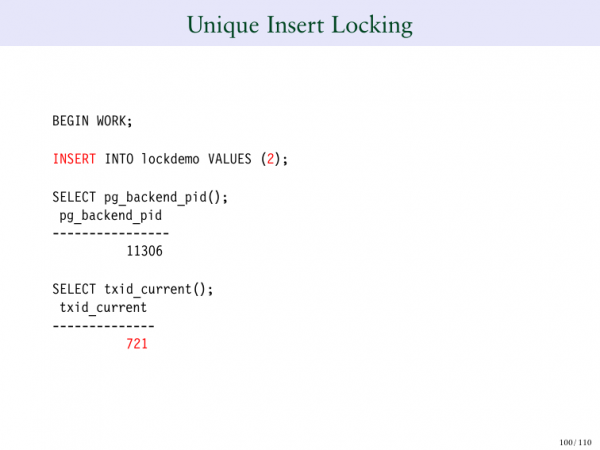
Portanto, se eu inserir o número 2 aqui, eu terei 2. Mas na parte superior, insiro outro 2. E você pode ver que o 721 tem um bloqueio exclusivo. Mas agora 722 está aguardando que 721 conclua sua operação, porque não pode inserir 2 até saber o que acontecerá com 721.
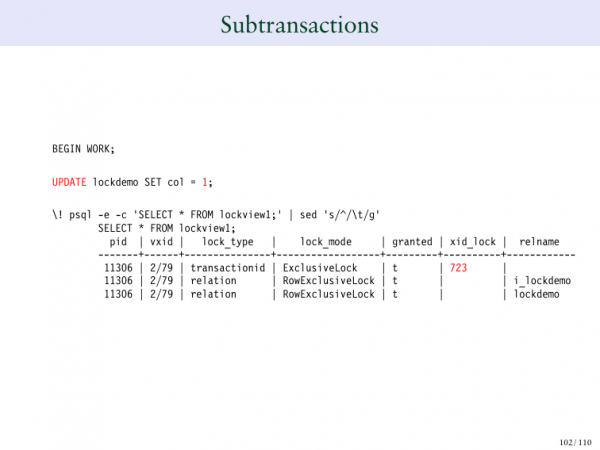
E se fizermos uma subtransação.
Aqui temos 723.
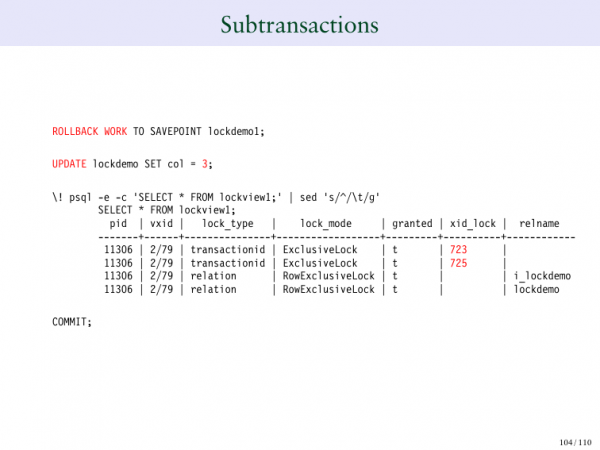
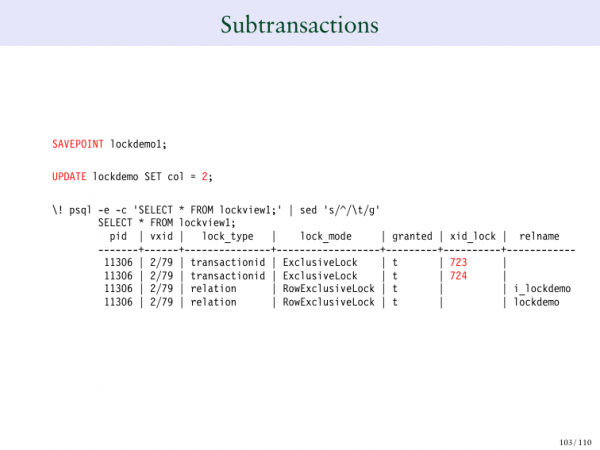
E se mantivermos o ponto e depois o atualizarmos, teremos um novo ID de transação. Esse é mais um comportamento que você precisa conhecer. Se retornarmos isso, o ID da transação desaparece. 724 desaparece. Mas agora temos 725.
E o que estou tentando fazer aqui? Estou tentando mostrar exemplos de bloqueios incomuns que você pode encontrar: sejam bloqueios serializáveis ou SAVEPOINT – são diferentes tipos de bloqueios que aparecerão na tabela de bloqueios.
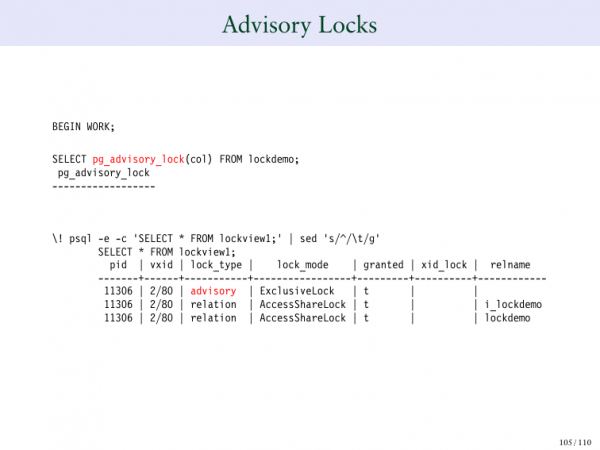
Isso é a criação de bloqueios explícitos, onde temos pg_advisory_lock.
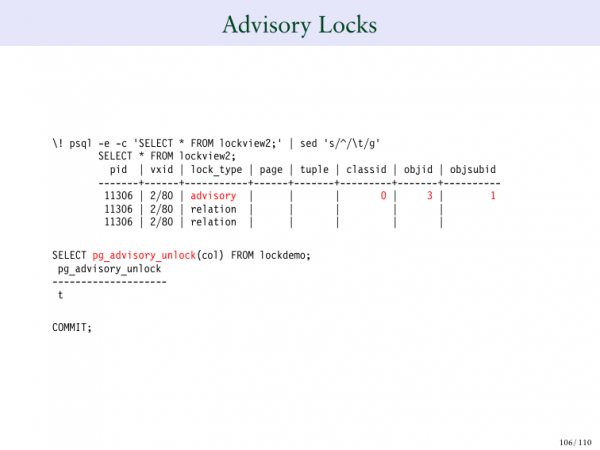
E você vê que o tipo de bloqueio é listado aqui como advisory. E está escrito em vermelho "advisory". E você pode bloquear simultaneamente com pg_advisory_unlock.
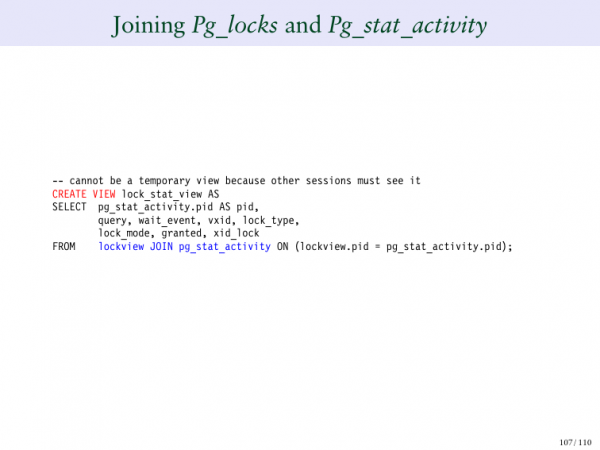
E para finalizar, gostaria de mostrar mais uma coisa impressionante. Vou criar outro tipo. Mas vou unir a tabela pg_locks com a tabela pg_stat_activity. E por que quero fazer isso? Porque isso me permitirá ver todas as sessões atuais e quais bloqueios elas estão esperando. E isso é bastante interessante quando reunimos a tabela de bloqueios e a tabela de consultas.
E aqui estamos criando pg_stat_view.
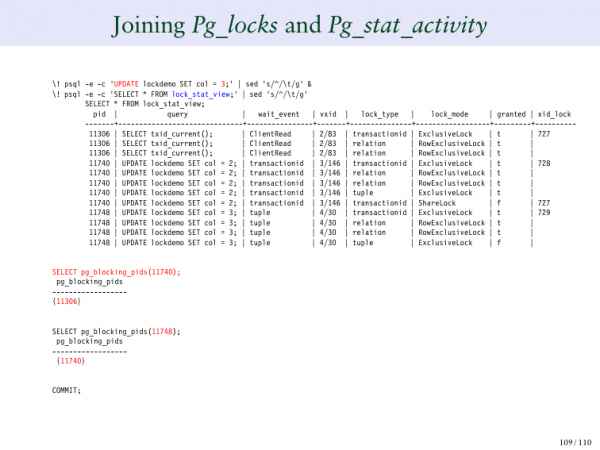
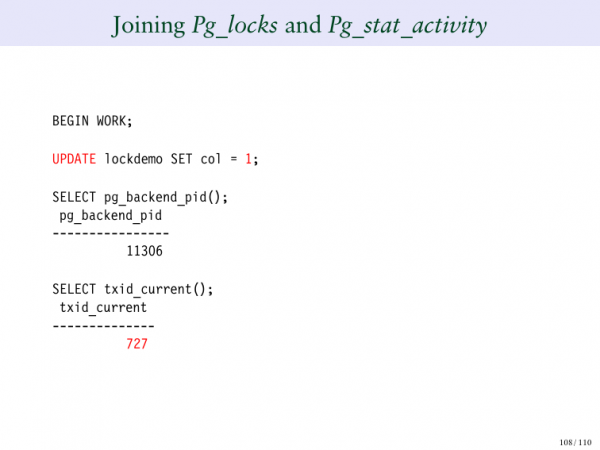
E estamos atualizando a linha em um. E aqui vemos 724. E então atualizamos nossa linha para três. E o que você vê agora? São as consultas, ou seja, você vê toda a lista de consultas que estão listadas na coluna da esquerda. E então, no lado direito, você pode ver os bloqueios e o que eles criam. E isso pode ser mais claro para você, para que você não precise voltar a cada sessão e ver se precisa se juntar ou não. Isso é feito por nós.
Outra função que é muito útil é pg_blocking_pidsVocê provavelmente nunca ouviu falar disso. O que ela faz? Ela nos permite dizer que, para esta sessão 11740, quais IDs de processos ela está esperando. E você pode ver que 11740 está esperando 724. E 724 está no topo. E 11306 é o seu ID de processo. Essencialmente, essa função percorre sua tabela de bloqueios. E eu sei que isso é um pouco complicado, mas você consegue entender. Basicamente, essa função passa por essa tabela de bloqueios e tenta encontrar onde está esse ID de processo, considerando os bloqueios que ela está esperando. E também tenta calcular qual é o ID do processo que está aguardando os bloqueios. Portanto, você pode executar essa função. pg_blocking_pids.
E isso pode ser muito útil. Nós adicionamos isso apenas na versão 9.6, então essa função tem apenas 5 anos, mas é muito e muito útil. E o mesmo se aplica à segunda consulta. Ela mostra exatamente o que precisamos ver.
É sobre isso que eu queria conversar com você. E como eu esperava, usamos todo nosso tempo, porque havia uma grande quantidade de slides. E os slides estão disponíveis para download. Eu gostaria de agradecer a você por estar aqui. Estou certo de que você vai gostar do restante da conferência, muito obrigado!
Perguntas:
Por exemplo, se estou tentando atualizar linhas, e a segunda sessão está tentando excluir toda a tabela. Pelo que eu entendo, deve haver algo como um intent lock. Existe isso no Postgres?
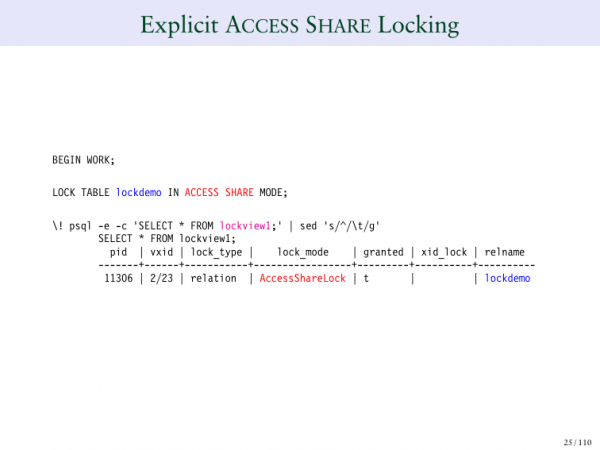
Voltando ao começo. Talvez você se lembre que quando você faz qualquer coisa, como um SELECT, emitimos um AccessShareLock. E isso impede a exclusão da tabela. Portanto, se você, por exemplo, deseja atualizar uma linha na tabela ou excluir uma linha, alguém não poderá excluir toda a tabela ao mesmo tempo, porque você mantém esse AccessShareLock sobre toda a tabela e sobre a linha. E assim que você terminar, eles podem excluí-la. Mas enquanto você está mudando algo, não poderão fazer isso.
Vamos lá novamente. Vamos passar para o exemplo da exclusão. E você vê como há um bloqueio exclusivo sobre toda a tabela na linha.
Isso parecerá como um lock exclusive, certo?
Sim, isso parece com isso. Eu entendo do que você está falando. Você diz que, se eu executar um SELECT, terei um ShareExclusive, e depois eu o translado para um estado Row Exclusive, isso se torna um problema? Mas surpreendentemente, isso não gera problema. Isso parece um aumento no nível de bloqueio, mas, essencialmente, eu tenho um lock que impede a exclusão. E agora, quando eu torno esse lock mais forte, ele ainda impede a exclusão. Portanto, não se trata de eu estar subindo. Ou seja, ele impedia isso mesmo quando estava em um nível mais baixo, então, quando aumento seu nível, ele ainda impede a exclusão da tabela.
Eu entendo do que você está falando. Não há um caso de aumento no nível de bloqueio aqui, onde você está tentando liberar um bloqueio para introduzir um mais forte. Aqui, é apenas um aumento geral dessa prevenção, portanto, isso não gera nenhum conflito. Mas é uma boa pergunta. Muito obrigado por tê-la feito!
O que precisamos fazer para evitar a situação de deadlock quando temos muitas sessões, um grande número de usuários?
O Postgres detecta automaticamente situações de deadlock. E vai remover uma das sessões automaticamente. A única maneira de evitar a situação de deadlocks é bloquear as pessoas na mesma ordem. Portanto, quando você olhar para o seu aplicativo, muitas vezes a razão para deadlocks... Vamos imaginar que eu quero bloquear duas coisas diferentes. Um aplicativo bloqueia a tabela 1, e outro aplicativo bloqueia a tabela 2, e depois a tabela 1. E a maneira mais simples de evitar deadlocks é olhar para o seu aplicativo e tentar garantir que o bloqueio ocorra na mesma ordem em todos os aplicativos. E isso geralmente elimina 80% dos problemas, porque várias pessoas diferentes escrevem esses aplicativos. E se você bloqueá-los na mesma ordem, então você não enfrenta a situação de deadlock.
Muito obrigado pela sua apresentação! Você falou sobre vacuum full e, se eu entendi corretamente, o vacuum full modifica a ordem dos registros em armazenamento separado, portanto, mantém os registros atuais inalterados. E por que o vacuum full precisa de acesso exclusivo ao bloqueio e por que ele conflita com operações de gravação?
Essa é uma boa pergunta. A razão é que o vacuum full pega a tabela. E nós, na verdade, estamos criando uma nova versão da tabela. E a tabela será nova. Então, na verdade, será uma versão completamente nova da tabela. E o problema é que, quando fazemos isso, não queremos que as pessoas leiam isso, porque precisamos que elas vejam a nova tabela. E por isso se conecta com a pergunta anterior. Se pudéssemos ler ao mesmo tempo, não conseguiríamos movê-la e direcionar as pessoas para a nova tabela. Teríamos que esperar que todos terminassem de ler esta tabela, e assim, na verdade, é uma situação de bloqueio exclusivo.
Estamos simplesmente dizendo que bloqueamos desde o início, porque sabemos que no final precisaremos de um bloqueio exclusivo para mover todos para a nova cópia. Portanto, potencialmente podemos liberar isso. E fazemos isso com a indexação simultânea. Mas é muito mais complicado de fazer. E isso está muito relacionado à sua pergunta anterior sobre bloqueio exclusivo.
É possível adicionar um tempo limite de bloqueio no Postgres? No Oracle, posso, por exemplo, escrever 'selecionar para atualizar' e esperar 50 segundos até a atualização. Isso era bom para o aplicativo. Mas no Postgres, ou eu faço isso imediatamente e não espero, ou espero até um certo tempo.
Sim, você pode escolher o tempo limite para seus bloqueios. Você também pode emitir um comando sem forma, que será..., se não conseguir obter o bloqueio imediatamente. Então, ou tempo limite de bloqueio, ou outra coisa que permita fazer isso. Isso não é feito em nível de sintaxe. É feito como uma variável no servidor. Às vezes, não é possível usá-lo.
Você pode abrir o slide 75?
Sim.
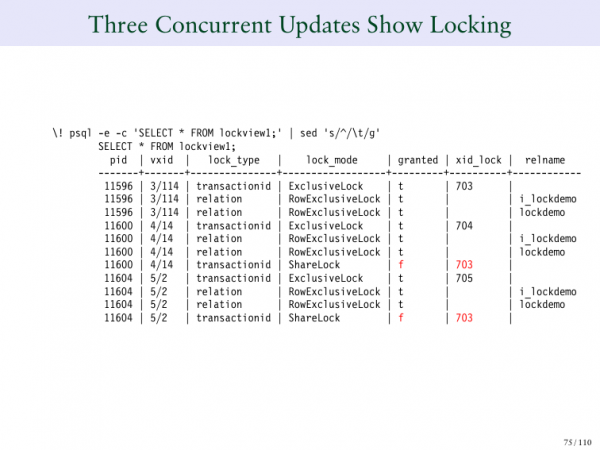
E minha pergunta é a seguinte. Por que ambos os processos de atualização estão aguardando 703?
E essa é uma ótima pergunta. Não entendo, a propósito, por que o Postgres faz isso. Mas quando 703 foi criado, ele esperava 702. E quando 704 e 705 aparecem, parece que eles não sabem o que estão esperando, porque ainda não há nada. E o Postgres faz assim: quando você não consegue obter um bloqueio, ele pensa: 'Qual é o sentido de processá-lo?', porque você já está esperando alguém. Então, apenas deixamos na espera, ele nem atualiza isso. Mas o que aconteceu aqui? Assim que 702 terminou o processo e 703 obteve seu bloqueio, o sistema voltou. E disse que agora temos duas pessoas esperando. E então vamos atualizá-las juntas. E vamos indicar que ambas estão esperando.
Não sei por que o Postgres faz isso. Mas existe um problema chamado f…. Acho que esse não é um termo em português. É quando todos estão esperando por um bloqueio, mesmo que haja 20 instâncias esperando por um bloqueio. E de repente todos despertam ao mesmo tempo. E todos começam a tentar reagir. Mas o sistema faz com que todos esperem 703. Porque todos estão aguardando, e os organizamos imediatamente em fila. E se qualquer outro novo pedido aparecer, que foi formado depois disso, por exemplo, 707, haverá novamente um vazio.
E parece que isso é feito para que possamos dizer que neste estágio 702 está esperando 703, e todos aqueles que chegarem depois disso não terão nenhum registro nesse campo. Mas assim que o primeiro aguardando sai, todos aqueles que estavam aguardando nesse momento até a atualização recebem o mesmo marcador. E por isso, parece que isso foi feito para que pudéssemos processar na ordem, para que eles fossem devidamente organizados.
Sempre encarei isso como um fenômeno bastante estranho. Porque aqui, por exemplo, não os listamos de maneira alguma. Mas, parece que toda vez que damos um novo bloqueio, olhamos para todos aqueles que estão no processo de espera. Então os organizamos em fila. E qualquer novo que chega só entra na fila quando a próxima pessoa terminou de ser processada. Uma pergunta muito boa. Muito obrigado pela pergunta!
Parece-me muito mais lógico quando 705 espera 704.
Mas o problema é o seguinte. Tecnicamente, você pode ativar um ou outro. Portanto, ativaremos um ou outro. Mas o que acontece no funcionamento do sistema? Você vê que 703 no topo bloqueou seu próprio ID de transação. É assim que o Postgres funciona. E 703 é bloqueado pelo seu próprio ID de transação, então, se alguém quiser esperar, ele ficará esperando por 703. E, essencialmente, 703 é que termina. E só após sua finalização, algum dos processos é ativado. E não sabemos exatamente qual processo vai ser. Então, gradualmente, processamos tudo. Mas não está claro qual processo será ativado primeiro, porque pode ser qualquer um desses processos. Basicamente, tínhamos um agendador que dizia que agora poderíamos ativar qualquer um desses processos. Apenas escolhemos um aleatoriamente. Por isso, ambos precisam ser marcados, porque podemos ativar qualquer um deles.
E o problema é que temos CP-infinito. Então, é bastante provável que possamos ativar o mais recente. E se, por exemplo, formos ativar o mais recente, então estaremos esperando por aquele que acabou de receber um bloqueio, portanto não determinamos quem exatamente será ativado primeiro. Criamos apenas uma situação assim, e o sistema os ativará em ordem aleatória.
Há . Veja, eles também são interessantes e úteis. O tema, é claro, é extremamente complexo. Muito obrigado, Bruce!
Fonte: habr.com
