

Prefácio
Existe uma ferramenta tão simples e muito útil no mundo — , e aconteceu que ela se firmou em nosso processo produtivo há muito tempo (apesar de não ter conseguido instalar a versão dela, com certeza não era a mais recente disponível). Usamos para seu propósito original — a construção de patches binários. Ao olhar o que há no repositório, dá uma leve tristeza: basicamente, ele foi abandonado há tempos e muitas coisas lá estão bastante desatualizadas (uma vez, meu ex-colega fez algumas correções, mas isso faz muito tempo). Em geral, decidi reviver este projeto: fiz um fork, removi o que não pretendo usar, e migrei o projeto para , inlined as microfunções “quentes”, removi grandes arrays da pilha (e arrays de comprimento variável, que me deixaram bastante irritado), passei o profiler mais uma vez — e descobri que cerca de 40% do tempo é gasto em …
E quanto ao fwrite?
Neste código, fwrite (no meu caso específico: construindo um patch entre arquivos de cerca de 300 MB, com dados totalmente em memória) é chamado milhões de vezes com um buffer pequeno. É óbvio que essa situação vai ser um gargalo, e, portanto, gostaria de impactar isso de alguma forma sem grandes complicações. Não tenho interesse em implementar diversos tipos de fontes de dados, ou I/O assíncrono, então queria encontrar uma solução mais simples. Primeiro que me veio à mente — aumentar o tamanho do buffer.
setvbuf(file, nullptr, _IOFBF, 64 * 1024)mas não obtive uma melhoria significativa no resultado (agora, fwrite consumia cerca de 37% do tempo) — então a questão não era a gravação frequente de dados no disco. Olhando “debaixo do capô” do fwrite, podemos ver que internamente ocorre um lock/unlock da estrutura FILE mais ou menos assim (pseudocódigo, toda a análise foi realizada no Visual Studio 2017):
size_t fwrite (const void *buffer, size_t size, size_t count, FILE *stream)
{
   size_t retval = 0;
   _lock_str(stream);   /* lock stream */
   __try
   {
      retval = _fwrite_nolock(buffer, size, count, stream);
   }
   __finally
   {
       _unlock_str(stream);   /* unlock stream */
   }
   return retval;
}
Se confiar no profiler, apenas 6% do tempo é gasto em _fwrite_nolock, o restante é overhead. No meu caso específico, a segurança de thread é um excesso óbvio, e vou abdicá-la, substituindo a chamada do fwrite por — nem é preciso complicar com argumentos. No total: essa simples manipulação reduziu drasticamente os custos de gravação do resultado, que na versão original representavam quase metade do tempo total gasto. A propósito, no mundo POSIX existe uma função análoga — . De modo geral, o mesmo se aplica a fread. Dessa forma, com um par de #define, é possível obter uma solução multiplataforma bastante eficiente, sem bloqueios desnecessários quando não são necessários (o que acontece com bastante frequência).
fwrite, _fwrite_nolock, setvbuf
Vamos nos abstrair do projeto original e nos concentrar na testagem de um caso específico: a gravação de um grande arquivo (512 MB) em porções extremamente pequenas — de 1 byte. Sistema de teste: AMD Ryzen 7 1700, 16 GB de RAM, HDD 7200 rpm com 64 MB de cache, Windows 10 1809, binário construído em 32 bits, otimizações ativadas, biblioteca estáticamente linkada.
Amostra para realização do experimento:
#include <chrono>
#include <cstdio>
#include <inttypes.h>
#include <memory>

#ifdef _MSC_VER
#define fwrite_unlocked _fwrite_nolock
#endif

using namespace std::chrono;

int main()
{
    std::unique_ptr<FILE, int(*)(FILE*)> file(fopen("test.bin", "wb"), fclose);
    if (!file)
        return 1;

    constexpr size_t TEST_BUFFER_SIZE = 256 * 1024;
    if (setvbuf(file.get(), nullptr, _IOFBF, TEST_BUFFER_SIZE) != 0)
        return 2;

    auto start = steady_clock::now();
    const uint8_t b = 77;
    constexpr size_t TEST_FILE_SIZE = 512 * 1024 * 1024;
    for (size_t i = 0; i < TEST_FILE_SIZE; ++i)
        fwrite_unlocked(&b, 1, sizeof(b), file.get());

    auto end = steady_clock::now();
    auto interval = duration_cast<microseconds>(end - start);
    printf("Time: %lldn", interval.count());

    return 0;
}
Os variáveis serão TEST_BUFFER_SIZE, e, para um par de casos, substituiremos fwrite_unlocked por fwrite. Comecemos com o caso fwrite sem definição explícita do tamanho do buffer (comentaremos setvbuf e o código relacionado): tempo 27048906 µs, velocidade de gravação — 18.93 MB/s. Agora, definimos o tamanho do buffer em 64 KB: tempo — 25037111 µs, velocidade — 20.44 MB/s. Agora, testaremos o funcionamento de _fwrite_nolock sem a chamada de setvbuf: 7262221 µs, velocidade — 70.5 MB/s!
Em seguida, vamos experimentar com o tamanho do buffer (setvbuf):
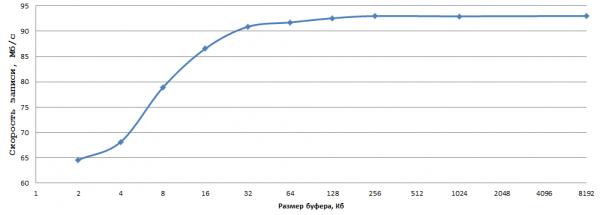
Os dados foram obtidos pela média de 5 experimentos, não me dei ao trabalho de calcular as margens de erro. Na minha opinião, 93 MB/s ao gravar 1 byte em um HDD comum é um resultado muito bom, só é preciso escolher o tamanho ótimo do buffer (no meu caso, 256 KB — é o ideal) e substituir fwrite por _fwrite_nolock/fwrite_unlocked (caso a segurança de thread não seja necessária, claro).
O mesmo se aplica ao fread em condições semelhantes. Como não tenho uma máquina 'física' com linux à mão (placas únicas não contam), decidi realizar um experimento limitado em uma máquina virtual (Hyper-V, OpenSUSE 15, GCC 8.3.1) — a regularidade, em princípio, é a mesma: fwrite puro 20 MB/s, fwrite + buffer de 256 KB forneceu 23 MB/s, fwrite_unlocked com o mesmo buffer — 35 MB/s (binário de 64 bits, construído com g++ -o2 -s -static-libgcc -static-libstdc++ fwrite_test.cpp -o fwrite_test).
Epílogo
O objetivo deste artigo é descrever uma abordagem simples e eficaz que pode ser útil em muitos casos (não havia me deparado antes com as funções _fwrite_nolock/fwrite_unlocked, que não são muito populares — e isso é uma pena). Não pretendo reivindicar a novidade do material, mas espero que o artigo seja útil para a comunidade.
Fonte: habr.com
