

A Netflix é a líder do mercado de streaming — uma empresa que criou e desenvolve ativamente este segmento. A Netflix é conhecida não apenas pelo extenso catálogo de filmes e séries disponíveis em quase qualquer lugar do planeta e em qualquer dispositivo com tela, mas também pela sua infraestrutura confiável e pela cultura de engenharia única.
Um exemplo claro da abordagem da Netflix ao desenvolvimento e suporte de sistemas complexos foi apresentado — diretor de desenvolvimento na Netflix. Formado pela Faculdade de Matemática, Mecânica e Ciência da Computação da Universidade Estatal de Nizhny Novgorod, Sergey é um dos primeiros engenheiros da Open Connect — equipe de CDN da Netflix. Ele construiu sistemas de monitoramento e análise de dados de vídeo, lançou o popular serviço de avaliação de velocidade de conexão à Internet FAST.com e, nos últimos anos, tem trabalhado na otimização de requisições de Internet para que o aplicativo da Netflix funcione o mais rápido possível para os usuários.
A apresentação recebeu os melhores comentários dos participantes da conferência, e preparamos para você a versão textual.
Na apresentação, Sergey detalhou
- o que influencia a latência das requisições de internet entre o cliente e o servidor;
- como reduzir essa latência;
- como projetar, manter e monitorar sistemas à prova de falhas;
- como alcançar resultados em prazos curtos, com o mínimo de risco para os negócios;
- como analisar resultados e aprender com os erros.
As respostas a essas perguntas são necessárias não só para quem trabalha em grandes corporações.
Os princípios e técnicas apresentados devem ser conhecidos e praticados por todos que desenvolvem e mantêm produtos na internet.
A seguir — o relato em primeira pessoa do palestrante.
A importância da velocidade da internet
A velocidade das requisições de internet está diretamente ligada aos negócios. Vamos considerar a área de compras: a empresa Amazon, em 2009, , que uma latência de 100 ms leva a uma perda de 1% nas vendas.
Cada vez mais dispositivos móveis surgem, e com eles, sites e aplicativos móveis. Se a sua página demora mais de 3 segundos para carregar, você perde cerca de metade dos usuários. Desde a Google considera a velocidade de carregamento da sua página nos resultados de busca: quanto mais rápida a página, melhor sua posição no Google.
A velocidade de conexão é igualmente importante nas instituições financeiras, onde a latência é crítica. Em 2015, a Hibernia Networks um cabo de fibra óptica entre Nova Iorque e Londres custando 400 milhões de dólares, para reduzir a latência entre as cidades em 6 ms. Imagine, 66 milhões de dólares para cada 1 ms de redução de latência!
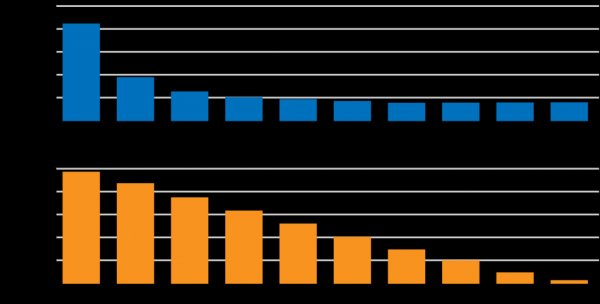
De acordo com , a velocidade da conexão acima de 5 Mbit/s deixa de impactar diretamente a velocidade de carregamento de um site típico. No entanto, existe uma relação linear entre a latência da conexão e a velocidade de carregamento da página:
No entanto, a Netflix não é um produto típico. O impacto da latência e da velocidade no usuário é uma área ativa de análise e desenvolvimento. Existem carregamentos de aplicativos e seleção de conteúdo que dependem da latência, mas o carregamento de elementos estáticos e streaming também depende da velocidade da conexão. A análise e otimização dos fatores-chave que afetam a qualidade do serviço para o usuário é uma área ativa de desenvolvimento de várias equipes na Netflix. Uma das tarefas é reduzir a latência das solicitações entre os dispositivos da Netflix e a infraestrutura em nuvem.
Neste relatório, vamos nos concentrar na redução da latência, usando a infraestrutura da Netflix como exemplo. Vamos abordar, sob um ponto de vista prático, como lidar com os processos de design, desenvolvimento e operação de sistemas complexos e distribuir nosso tempo em inovações e resultados, e não em diagnósticos de problemas operacionais e falhas.
Dentro da Netflix
Milhares de dispositivos diferentes suportam os aplicativos da Netflix. Quatro equipes diferentes estão envolvidas em seu desenvolvimento, criando versões separadas do cliente para Android, iOS, TV e navegadores da web. E nós investimos muito tempo e esforço para melhorar e personalizar a interface do usuário. Para isso, realizamos centenas de testes A/B em paralelo.
A personalização é suportada por cem microsserviços na nuvem AWS, fornecendo dados personalizados para o usuário, gerenciamento de solicitações, telemetria, Big Data e codificação. A visualização do tráfego aparece assim:
À esquerda está o ponto de entrada, e então o tráfego é distribuído entre várias centenas de microsserviços, mantidos por diferentes equipes de backend.
Mais um componente importante da nossa infraestrutura é o Open Connect CDN, que entrega conteúdos estáticos ao usuário final — vídeos, imagens, códigos para clientes, etc. O CDN está localizado em servidores personalizados (OCA — Open Connect Appliance). Dentro deles, existem arrays de discos SSD e HDD, gerenciados por um FreeBSD otimizado, com NGINX e um conjunto de serviços. Projetamos e otimizamos os componentes de hardware e software de forma que esse servidor CDN possa enviar o máximo de dados possível para os usuários.
A "parede" desses servidores no ponto de troca de tráfego de internet (Internet eXchange — IX) é assim:
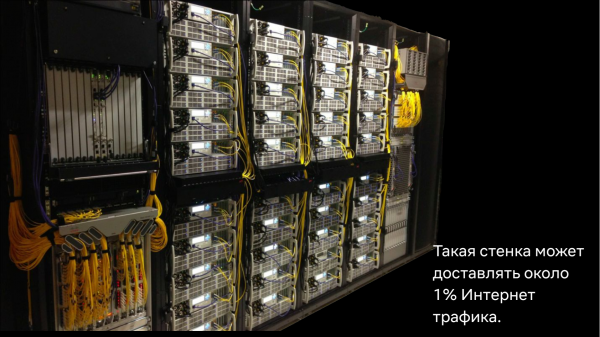
O Internet Exchange oferece a possibilidade para provedores de internet e fornecedores de conteúdo se "conectarem" entre si para uma troca de dados mais direta na internet. Em todo o mundo, existem cerca de 70-80 pontos de Internet Exchange, onde nossos servidores estão instalados, e realizamos sua instalação e manutenção de forma independente.
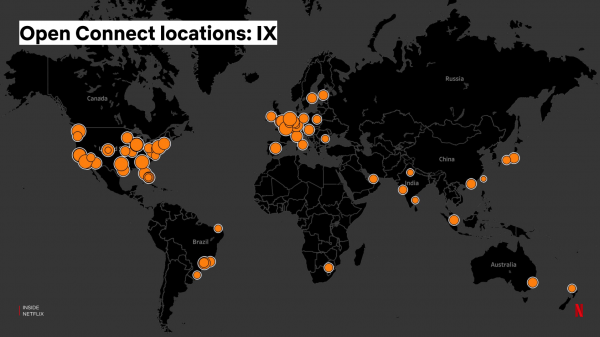
Além disso, também fornecemos servidores diretamente para provedores de internet, que os instalam em suas redes, melhorando a localização do tráfego da Netflix e a qualidade do streaming para os usuários:
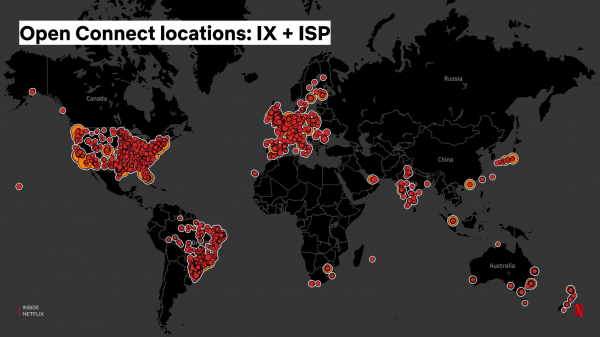
O conjunto de serviços da AWS é responsável pela gestão das solicitações de vídeo dos clientes aos servidores CDN, bem como pela configuração dos próprios servidores — atualização de conteúdos, códigos de programação, configurações, etc. Para isso, também construímos uma rede backbone, que conecta os servidores nos pontos de Internet Exchange à AWS. A rede backbone é uma rede global de cabos de fibra óptica e roteadores, que podemos projetar e configurar de acordo com nossas necessidades.
De acordo com , nossa infraestrutura CDN entrega em horários de pico cerca de ⅛ do tráfego de internet mundial e ⅓ do tráfego na América do Norte, onde a Netflix existe há mais tempo. Números impressionantes, mas para mim, uma das realizações mais surpreendentes é que todo o sistema CDN é desenvolvido e mantido por uma equipe de menos de 150 pessoas.
Inicialmente, a infraestrutura CDN foi projetada para entrega de dados de vídeo. No entanto, com o tempo, percebemos que poderíamos usá-la também para otimizar solicitações dinâmicas dos clientes na nuvem AWS.
Sobre a aceleração da internet
Hoje, a Netflix possui 3 regiões da AWS, e a latência das requisições na nuvem dependerá da distância do cliente até a região mais próxima. Temos muitos servidores CDN que são usados para a entrega de conteúdo estático. Existe uma forma de usar essa infraestrutura para acelerar as requisições dinâmicas? Infelizmente, não é possível armazenar em cache essas requisições — as APIs são personalizadas e cada resultado é único.
Vamos criar um proxy no servidor CDN e começar a direcionar o tráfego por ele. Isso será mais rápido?
Teoria
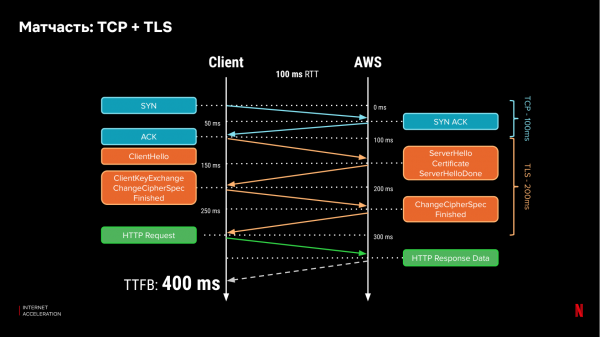
Vamos recordar como funcionam os protocolos de rede. Hoje, a maior parte do tráfego na internet utiliza HTTPS, que depende dos protocolos de nível inferior TCP e TLS. Para que o cliente se conecte ao servidor, ele realiza um handshake, e para estabelecer uma conexão segura, o cliente precisa trocar mensagens com o servidor três vezes, e ainda pelo menos uma vez para transmitir dados. Com uma latência de um round-trip (RTT) de 100 ms, precisaremos de 400 ms para receber o primeiro bit de dados:
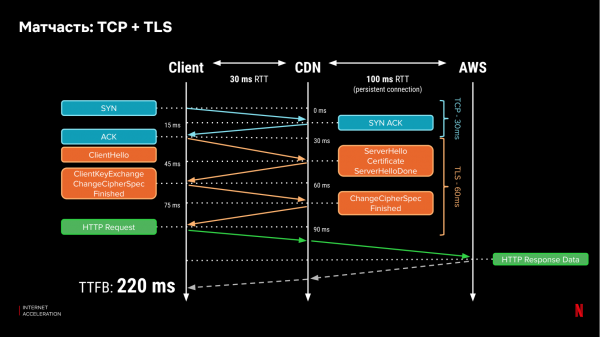
Se os certificados estiverem localizados no servidor CDN, podemos reduzir significativamente o tempo de 'handshake' entre o cliente e o servidor, se o CDN estiver mais próximo. Suponhamos que a latência até o servidor CDN seja de 30 ms. Então, para receber o primeiro bit, já levará 220 ms:
Mas as vantagens não param por aqui. Após a conexão ser estabelecida, o TCP aumenta a congestion window (a quantidade de informação que pode ser transmitida por essa conexão simultaneamente). Se um pacote de dados é perdido, as implementações clássicas do protocolo TCP (como o TCP New Reno) reduzem a 'janela' aberta pela metade. O aumento da congestion window e a velocidade de sua recuperação após uma perda novamente dependem da latência (RTT) até o servidor. Se essa conexão vai apenas até o servidor CDN, essa recuperação será mais rápida. Além disso, a perda de pacotes é um fenômeno comum, especialmente em redes sem fio.
A largura de banda da internet pode diminuir, especialmente durante os horários de pico devido ao tráfego dos usuários, o que pode causar "congestionamentos". Nesse sentido, não há como priorizar algumas solicitações em relação a outras na internet. Por exemplo, priorizar pequenas solicitações que são sensíveis à latência em relação a grandes fluxos de dados que sobrecarregam a rede. No entanto, no nosso caso, ter uma rede backbone própria permite fazer isso em parte do caminho da solicitação — entre o CDN e a nuvem, e podemos configurá-la totalmente. É possível fazer com que pacotes pequenos e sensíveis à latência sejam priorizados, enquanto grandes fluxos de dados sejam processados um pouco mais tarde. Quanto mais próximo o CDN estiver do cliente, maior será a eficiência.
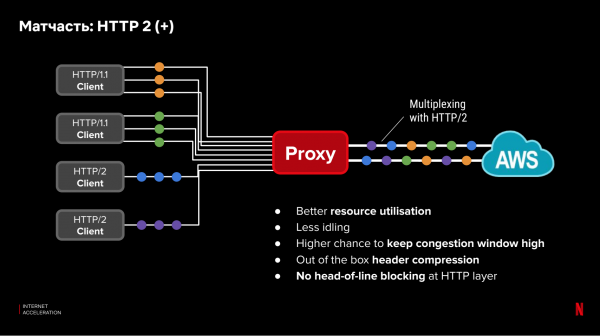
Outra influência sobre a latência vem dos protocolos de nível de aplicação (Camada 7 do OSI). Novos protocolos, como HTTP/2, permitem otimizar o desempenho de solicitações paralelas. No entanto, temos clientes da Netflix que possuem dispositivos antigos que não suportam novos protocolos. Nem todos os clientes podem ser atualizados ou configurados de maneira ideal. Entretanto, entre o proxy do CDN e a nuvem, há controle total e a possibilidade de usar novos protocolos e configurações otimizadas. A parte ineficiente com os protocolos antigos funcionará apenas entre o cliente e o servidor do CDN. Além disso, podemos realizar multiplexação de solicitações em uma conexão já estabelecida entre o CDN e a nuvem, melhorando a utilização da conexão no nível TCP:
Medindo
Apesar de a teoria prometer melhorias, não nos apressamos a colocar o sistema em produção imediatamente. Em vez disso, devemos primeiro provar que a ideia funcionará na prática. Para isso, precisamos responder a algumas perguntas:
- Velocidade: o proxy será mais rápido?
- Confiabilidade: ele falhará com mais frequência?
- Complexidade: como integrar com aplicações?
- Custo: quanto custa implementar uma infraestrutura adicional?
Vamos analisar detalhadamente nossa abordagem para avaliar o primeiro ponto. Os outros são abordados de forma semelhante.
Para analisar a velocidade das solicitações, queremos obter dados para todos os usuários, não gastar muito tempo no desenvolvimento e não quebrar a produção. Para isso, existem várias abordagens:
- RUM, ou medição passiva de solicitações. Medimos o tempo de execução das solicitações atuais dos usuários e garantimos uma cobertura total dos usuários. A desvantagem é que o sinal não é muito estável devido a vários fatores, como o tamanho variável das solicitações, o tempo de processamento no servidor e no cliente. Além disso, não é possível testar uma nova configuração sem efeitos no ambiente de produção.
- Testes de laboratório. Servidores e infraestrutura especiais que simulam clientes. Com eles, realizamos os testes necessários. Assim, obtemos controle total sobre os resultados das medições e um sinal claro. No entanto, não há cobertura total de dispositivos e localidades de usuários (especialmente com um serviço global e suporte a milhares de modelos de dispositivos).
Como podemos combinar as vantagens de ambos os métodos?
Nossa equipe encontrou uma solução. Escrevemos um pequeno trecho de código — um probe — que incorporamos ao nosso aplicativo. Os probes nos permitem realizar testes de rede totalmente controlados a partir de nossos dispositivos. Funciona da seguinte maneira:
- Logo após o carregamento do aplicativo e a conclusão da atividade inicial, iniciamos nossos probes.
- O cliente faz uma solicitação ao servidor e recebe uma "receita" de teste. A receita consiste em uma lista de URLs para as quais devem ser feitas solicitações HTTP(s). Além disso, a receita configura os parâmetros das solicitações: delays entre as solicitações, volume de dados solicitados, cabeçalhos HTTP(s), etc. Dessa forma, podemos testar vários receitas diferentes em paralelo — quando uma configuração é solicitada, é determinado aleatoriamente qual receita fornecer.
- O tempo de início do probe é escolhido de forma a não entrar em conflito com o uso ativo de recursos de rede pelo cliente. Na verdade, escolhe-se um momento em que o cliente está inativo.
- Após receber a receita, o cliente faz solicitações para cada um dos URLs, em paralelo. A solicitação para cada endereço pode ser repetida — os chamados "pulsos". No primeiro pulso, medimos quanto tempo foi necessário para estabelecer a conexão e baixar os dados. No segundo pulso, medimos o tempo de carregamento dos dados por meio da conexão já estabelecida. Antes do terceiro, podemos introduzir um delay e medir a velocidade de reestabelecimento da conexão, entre outros.
Durante o teste, medimos todos os parâmetros que o dispositivo pode obter:
- o tempo de consulta DNS;
- o tempo para estabelecer conexão TCP;
- o tempo para estabelecer conexão TLS;
- o tempo para receber o primeiro byte de dados;
- o tempo total de carregamento;
- o código de status do resultado.
- Após a conclusão de todos os pulsos, a amostra carrega os resultados de todas as medições para análise.
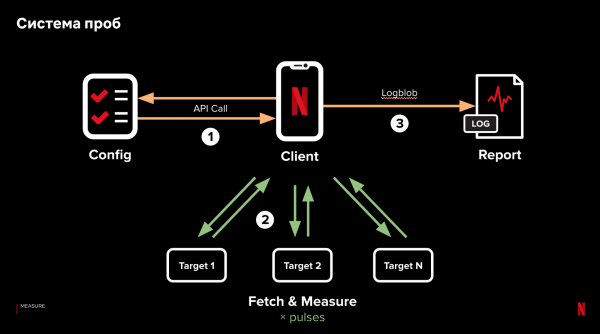
Os principais pontos são a mínima dependência da lógica no cliente, o processamento de dados no servidor e a medição de requisições paralelas. Assim, conseguimos isolar e testar a influência de diversos fatores que afetam o desempenho das requisições, variando-os dentro de uma única receita e obtendo resultados de clientes reais.
Essa infraestrutura se mostrou útil não apenas para a análise de desempenho das requisições. Neste momento, temos 14 receitas ativas, mais de 6000 amostras por segundo, recebendo dados de todos os cantos do mundo e com cobertura completa de dispositivos. Se a Netflix adquirisse um serviço semelhante de empresas terceiras, custaria milhões de dólares por ano, com uma cobertura muito inferior.
Verificamos a teoria na prática: protótipo
Com tal sistema, conseguimos avaliar a eficácia do proxy CDN na latência das requisições. Agora precisamos:
- criar um protótipo de proxy;
- hospedar o protótipo na CDN;
- determinar como direcionar clientes para o proxy em um servidor CDN específico;
- comparar o desempenho com requisições no AWS sem proxy.
A tarefa é avaliar a eficácia da solução proposta o mais rápido possível. Para implementar o protótipo, escolhemos o Go, devido à disponibilidade de boas bibliotecas de rede. Em cada servidor CDN, instalamos o protótipo de proxy como um binário estático, a fim de minimizar dependências e simplificar a integração. Na implementação inicial, utilizamos ao máximo os componentes padrão e pequenas modificações para o HTTP/2 connection pooling e request multiplexing.
Para balancear entre as regiões da AWS, usamos um banco de dados DNS geográfico, o mesmo utilizado para balanceamento de clientes. Para escolher o servidor CDN para o cliente, utilizamos TCP Anycast para servidores em Internet Exchange (IX). Neste caso, usamos um único endereço IP para todos os servidores CDN, e o cliente será direcionado ao servidor CDN com o menor número de saltos IP. Nos servidores CDN instalados nos provedores de internet (ISP), não temos controle sobre o roteador para configurar TCP Anycast, portanto empregamos , segundo a qual os clientes são direcionados para os provedores de internet para streaming de vídeo.
Assim, temos três tipos de caminhos para a solicitação: para a nuvem através da internet aberta, através do servidor CDN no IX ou através do servidor CDN localizado no provedor de internet. Nosso objetivo é entender qual caminho é melhor e qual é o benefício do proxy, em comparação com a forma como as solicitações são direcionadas para a produção. Para isso, usamos um sistema de teste da seguinte maneira:
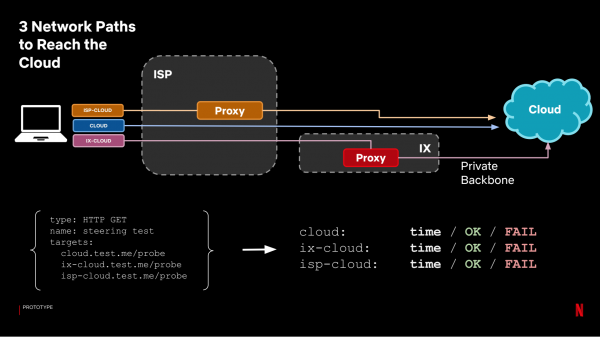
Cada um dos caminhos torna-se um alvo separado, e analisamos o tempo que obtivemos. Para a análise, agrupamos os resultados do proxy em um único grupo (escolhemos o melhor tempo entre o proxy do IX e o do ISP) e comparamos com o tempo das solicitações para a nuvem sem proxy:
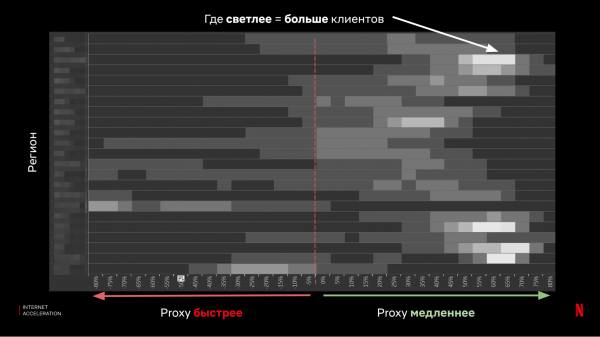
Como pode ser visto, os resultados foram ambíguos — na maioria dos casos, o proxy proporciona um bom aumento de velocidade, mas também há um número suficiente de clientes para os quais a situação piorará significativamente.
No final, fizemos algumas coisas importantes:
- Avaliaram a performance esperada das solicitações dos clientes para a nuvem através do proxy CDN.
- Obtivemos dados de clientes reais, de todos os tipos de dispositivos.
- Entendemos que a teoria não se confirmou 100% e a proposta inicial com o proxy CDN não funcionará para nós.
- Não arriscamos — não mudamos as configurações de produção para os clientes.
- Nada foi quebrado.
Protótipo 2.0
Assim, voltamos à prancheta e repetimos o processo novamente.
A ideia é — em vez de 100% de proxy, para cada cliente determinarmos o caminho mais rápido e direcionarmos as solicitações para lá — ou seja, faremos o que chamamos de client steering.
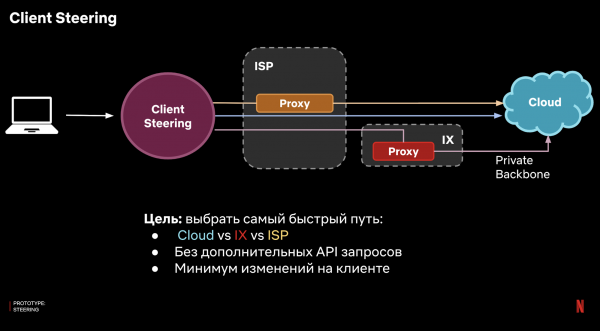
Como implementar isso? Não podemos usar a lógica do lado do servidor, pois o objetivo é conectar-se a esse servidor. Precisamos encontrar uma maneira de fazer isso no lado do cliente. E, idealmente, fazer isso com a mínima lógica complexa, para evitar problemas de integração com uma ampla variedade de plataformas do cliente.
A resposta é usar DNS. No nosso caso, temos nossa própria infraestrutura DNS, e podemos configurar a zona de domínio para a qual nossos servidores serão autoritativos. Funciona assim:
- O cliente faz uma solicitação ao servidor DNS usando o host, por exemplo, api.netflix.com.
- A solicitação chega ao nosso servidor DNS.
- O servidor DNS sabe qual é o caminho mais rápido para esse cliente e fornece o endereço IP correspondente.
A solução apresenta uma complexidade adicional: provedores DNS autoritativos não veem o endereço IP do cliente e podem considerar apenas o endereço IP do resolvedor recursivo utilizado pelo cliente.
No final, nosso resolvedor autoritativo deve tomar decisões não para um único cliente, mas para um grupo de clientes com base no resolvedor recursivo.
Para resolver isso, usamos as mesmas amostras, agregamos os resultados das medições dos clientes para cada resolvedor recursivo e decidimos para onde direcionar esse grupo - proxy através do IX usando TCP Anycast, através de proxy de ISP, ou diretamente para a nuvem.
Assim, obtemos o seguinte sistema:
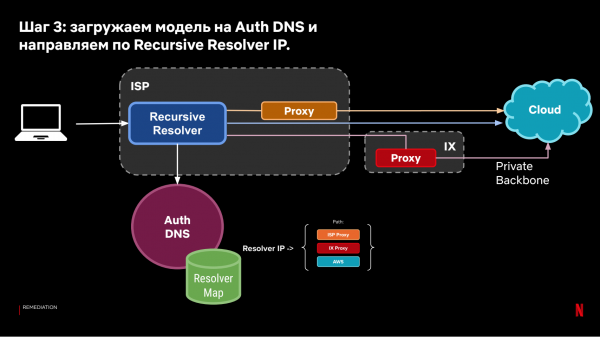
O modelo obtido de direcionamento DNS permite direcionar clientes com base em observações históricas sobre a velocidade das conexões dos clientes até a nuvem.
Novamente, a questão é: quão eficaz será esse método? Para responder, utilizamos novamente nosso sistema de amostras. Portanto, configuramos uma configuração recente, onde um dos destinos segue a direção do direcionamento DNS, enquanto o outro vai diretamente para a nuvem (produção atual).
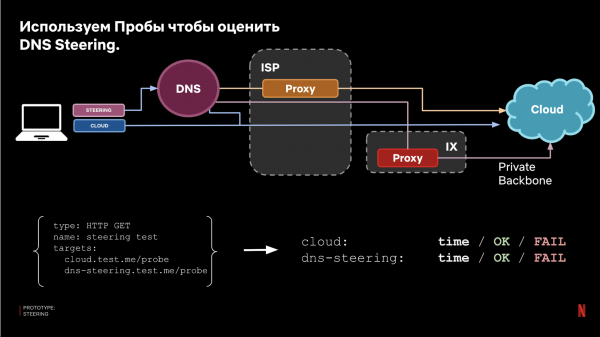
Por fim, comparamos os resultados e obtivemos uma avaliação da eficácia:
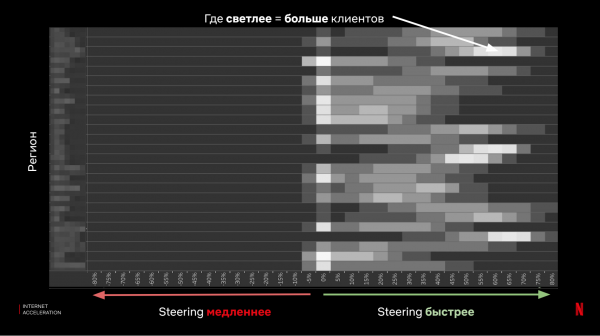
Como resultado, aprendemos algumas coisas importantes:
- Avaliaram o desempenho esperado das solicitações dos clientes na nuvem usando Direcionamento DNS.
- Obtivemos dados de clientes reais, de todos os tipos de dispositivos.
- Provamos a eficácia da ideia proposta.
- Não arriscamos — não mudamos as configurações de produção para os clientes.
- Nada foi quebrado.
Agora, a parte difícil – vamos colocar em produção.
O mais fácil já ficou para trás — temos um protótipo funcional. Agora a parte difícil é implementar uma solução para todo o tráfego da Netflix, implantá-la para 150 milhões de usuários, milhares de dispositivos, centenas de microsserviços e um produto e infraestrutura que mudam constantemente. Os servidores da Netflix recebem milhões de requisições por segundo, e é fácil quebrar o serviço com uma ação descuidada. Ao mesmo tempo, queremos direcionar dinamicamente o tráfego por meio de milhares de servidores CDN, na internet, onde algo está sempre mudando e quebrando, frequentemente no pior momento possível.
E, com tudo isso, na equipe há 3 engenheiros responsáveis pelo desenvolvimento, implantação e suporte total do sistema.
Por isso, continuaremos falando sobre um sono tranquilo e saudável.
Como continuar o desenvolvimento sem gastar todo o tempo em suporte? A base da nossa abordagem são 3 princípios:
- Reduzimos o potencial alcance de falhas (blast radius).
- Estamos preparados para surpresas — esperando que algo quebre, apesar dos testes e da experiência pessoal.
- Degradação gradual (graceful degradation) — se algo não funciona corretamente, deve ser corrigido automaticamente, mesmo que não da maneira mais eficiente.
Descobrimos que, no nosso caso, com essa abordagem ao problema, é possível encontrar uma solução simples e eficaz, simplificando significativamente o suporte ao sistema. Percebemos que podemos adicionar um pequeno trecho de código ao cliente para monitorar erros de requisições de rede, causados por problemas de conexão. Com erros de rede, fazemos fallback diretamente para a nuvem. Essa solução não exige esforços significativos das equipes de clientes, mas reduz consideravelmente o risco de falhas inesperadas e surpresas para nós.
Certamente, apesar do fallback, seguimos uma disciplina rigorosa durante o desenvolvimento:
- Teste em amostras.
- Teste A/B ou Canaries.
- Lançamento progressivo (progressive rollout).
Para as amostras, a abordagem foi descrita — as mudanças são inicialmente testadas usando uma receita configurada.
Para o teste canário, precisamos obter pares de servidores comparáveis, onde possamos comparar como o sistema funciona antes e depois das mudanças. Para isso, a partir de nossos numerosos sites CDN, fazemos uma amostra de pares de servidores que recebem tráfego comparável:
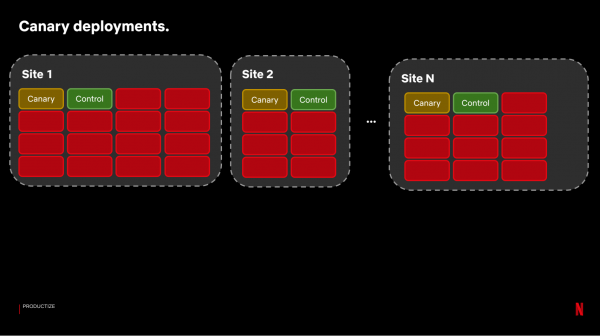
Em seguida, colocamos a montagem com as alterações nos servidores Canary. Para avaliar os resultados, executamos um sistema que compara cerca de 100-150 métricas com um grupo de servidores de Controle:
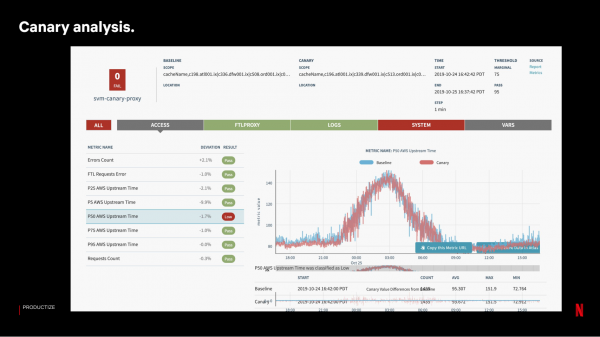
Se o teste Canary for bem-sucedido, fazemos o lançamento gradualmente, em ondas. Em cada site, não atualizamos os servidores ao mesmo tempo — a perda de um site inteiro em caso de problemas tem um impacto mais significativo no serviço para os usuários do que a perda do mesmo número de servidores em locais diferentes.
No geral, a eficácia e a segurança dessa abordagem dependem da quantidade e da qualidade das métricas coletadas. Para o nosso sistema de aceleração de requisições, coletamos métricas de todos os componentes possíveis:
- dos clientes — número de sessões e requisições, taxas de fallback;
- proxy — estatísticas sobre o número e o tempo das requisições;
- DNS — número e resultados das requisições;
- cloud edge — número e tempo de processamento das requisições na nuvem.
Tudo isso é coletado em um único pipeline e, dependendo das necessidades, decidimos quais métricas enviar para a análise em tempo real e quais enviar para Elasticsearch ou Big Data para diagnósticos mais detalhados.
Monitorando
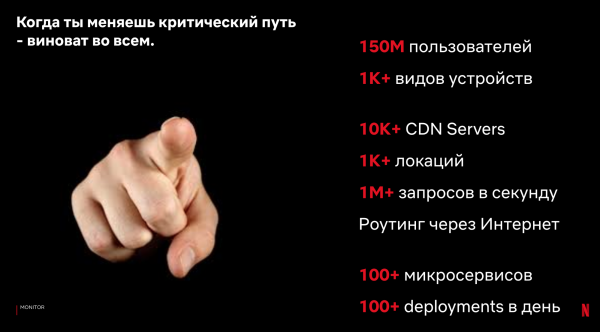
No nosso caso, fazemos alterações no caminho crítico das requisições entre o cliente e o servidor. Nesse sentido, o número de componentes diferentes no cliente, no servidor e no caminho pela internet é enorme. As mudanças no cliente e no servidor ocorrem constantemente — durante o trabalho de dezenas de equipes e mudanças naturais no ecossistema. Estamos no meio — ao diagnosticar problemas, é muito provável que estejamos envolvidos. Portanto, precisamos entender claramente como determinar, coletar e analisar métricas para uma rápida localização de problemas.
Idealmente, teríamos acesso completo a todos os tipos de métricas e filtros em tempo real. Porém, há muitas métricas, portanto surge a questão de custo. No nosso caso, separamos métricas e ferramentas de desenvolvimento da seguinte forma:
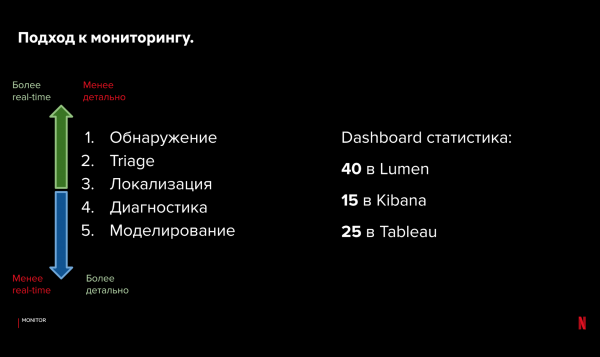
Para a detecção e triagem de problemas, usamos nosso próprio sistema de tempo real de código aberto e — para visualização. Ele armazena métricas agregadas na memória, é confiável e se integra ao sistema de alertas. Para localização e diagnóstico, temos acesso aos logs através do Elasticsearch e Kibana. Para análise estatística e modelagem, utilizamos big data e visualização no Tableau.
Parece que é muito difícil trabalhar com essa abordagem. No entanto, com uma organização hierárquica das métricas e ferramentas, podemos rapidamente analisar o problema, identificar o tipo de problema e, em seguida, nos aprofundar nas métricas detalhadas. Em geral, levamos cerca de 1 a 2 minutos para identificar a fonte da falha. Depois disso, já trabalhamos com uma equipe específica na diagnose — de dezenas de minutos a várias horas.
Mesmo que a diagnose seja feita rapidamente, não queremos que isso ocorra com frequência. Idealmente, receberemos um alerta crítico apenas quando houver um impacto significativo no serviço. Para o nosso sistema de aceleração de requisições, temos apenas 2 alertas que nos notificarão:
- percentual de Client Fallback — uma avaliação do comportamento dos clientes;
- percentual de Probe errors — dados sobre a estabilidade dos componentes da rede.
Esses alertas críticos monitoram se o sistema está funcionando para a maioria dos usuários. Observamos quantos clientes utilizaram o fallback caso não tenham conseguido a aceleração das requisições. Temos, em média, menos de 1 alerta crítico por semana, embora ocorram muitas mudanças no sistema. Por que isso é suficiente para nós?
- Há um client fallback no caso de nossa proxy não funcionar.
- Há um sistema de steering automático que reage a problemas.
Sobre o último, vamos nos aprofundar. Nosso sistema de probes e o sistema de determinação automática do melhor caminho para as requisições do cliente para a nuvem permitem lidar automaticamente com alguns problemas.
Voltando à nossa configuração de probes e às 3 categorias de caminhos. Além do tempo de carregamento, podemos observar o fato da entrega em si. Se não conseguirmos carregar os dados, ao observar os resultados dos diferentes caminhos, podemos determinar onde e o que quebrou, e se podemos corrigir isso automaticamente, alterando o caminho da requisição.
Exemplos:
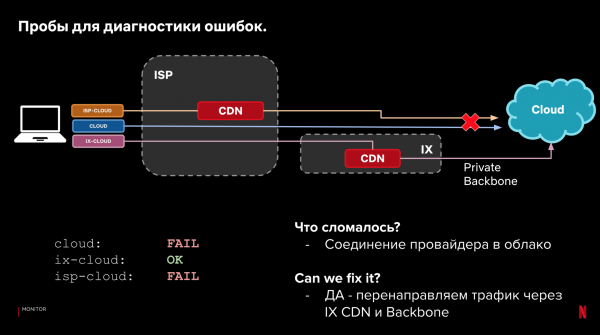
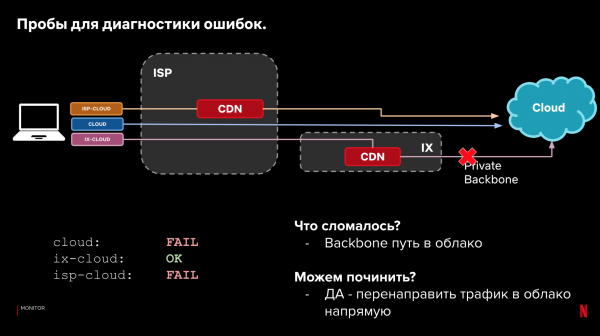
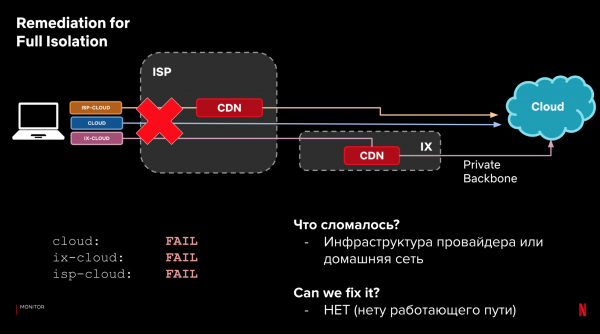
Esse processo pode ser automatizado. Integrá-lo ao sistema de steering. E ensiná-lo a reagir a problemas de desempenho e confiabilidade. Se algo começa a falhar — reagir, se houver uma opção melhor. Nesse caso, a reação imediata não é crítica, graças ao fallback dos clientes.
Assim, os princípios de suporte do sistema podem ser formulados da seguinte forma:
- reduzimos a escala das falhas;
- coletamos métricas;
- corrigimos automaticamente falhas, se pudermos;
- se não pudermos — notificamos;
- Estamos trabalhando em dashboards e um conjunto de ferramentas de triagem para uma resposta rápida.
Lições aprendidas
Não leva muito tempo para escrever um protótipo. No nosso caso, ele estava pronto em apenas 4 meses. Com isso, começamos a obter novas métricas, e após 10 meses desde o início do desenvolvimento, recebemos o primeiro tráfego em produção. Depois, começou o trabalho árduo e muito complexo: gradualmente transformar e escalar o sistema, migrar o tráfego principal e aprender com os erros. Além disso, esse processo eficiente não será linear — apesar de todos os esforços, não é possível prever tudo. É muito mais eficaz iterar rapidamente e reagir a novos dados.
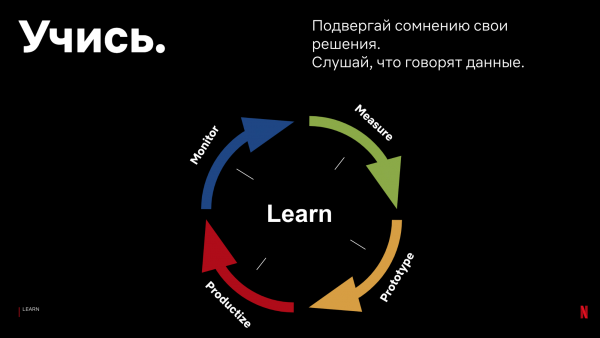
Com base em nossa experiência, podemos aconselhar o seguinte:
- Não confie na intuição.
Nossa intuição nos enganava constantemente, apesar da vasta experiência dos membros da equipe. Por exemplo, prevíamos incorretamente o aumento esperado com o uso de proxies CDN, ou o comportamento do TCP Anycast.
- Obtenha dados da produção.
É importante ter acesso o mais rápido possível, mesmo que a uma pequena quantidade de dados de produção. É praticamente impossível obter a quantidade de casos únicos, configurações e definições em condições de laboratório. O acesso rápido aos resultados permitirá identificar mais rapidamente potenciais problemas e considerá-los na arquitetura do sistema.
- Não siga conselhos e resultados de outros — colete seus próprios dados.
Siga os princípios de coleta e análise de dados, mas não aceite cegamente os resultados e afirmações dos outros. Apenas você pode saber com precisão o que funciona para seus usuários. Seus sistemas e seus clientes podem ser substancialmente diferentes de outras empresas. Felizmente, hoje em dia as ferramentas de análise estão disponíveis e são fáceis de usar. Os resultados que você obtém podem não coincidir com o que afirmam Netflix, Facebook, Akamai e outras empresas. No nosso caso, o desempenho de TLS, HTTP2 ou as estatísticas de consultas DNS diferem dos resultados do Facebook, Uber, Akamai — porque temos dispositivos, clientes e fluxos de dados diferentes.
- Não corra atrás de tendências populares sem necessidade e avaliação de eficácia.
Comece com o simples. É melhor criar um sistema funcional simples em pouco tempo do que gastar uma quantidade enorme de tempo desenvolvendo componentes desnecessários. Resolva tarefas e problemas que são importantes com base em suas medições e resultados.
- Prepare-se para novas aplicações.
Assim como é difícil prever todos os problemas, também é complicado antecipar os benefícios e aplicações. Inspire-se em startups — sua capacidade de adaptação às necessidades dos clientes. No seu caso, você pode descobrir novos problemas e suas soluções. Em nosso projeto, nosso objetivo era reduzir a latência das solicitações. No entanto, durante a análise e discussões, percebemos que os servidores proxy também podem ser aplicados:
- para balancear o tráfego entre regiões da AWS e reduzir custos;
- para simular a estabilidade de uma CDN;
- para configurar o DNS;
- para configurar o TLS/TCP.
Conclusão
No relatório, descrevi como a Netflix aborda a questão de acelerar as solicitações de internet entre clientes e a nuvem. Como coletamos dados por meio de um sistema de amostras nos clientes e utilizamos os dados históricos coletados para direcionar as solicitações de produção pelos caminhos mais rápidos da internet. Como aplicamos princípios de funcionamento de protocolos de rede, nossa infraestrutura de CDN, rede backbone e servidores DNS para atingir esse objetivo.
No entanto, nossa solução é apenas um exemplo de como implementamos tal sistema na Netflix. O que funcionou para nós. A parte prática do meu relatório para vocês são os princípios de desenvolvimento e manutenção que seguimos e cujo resultado é bem-sucedido.
Nossa solução pode não se adequar a você. No entanto, a teoria e os princípios de desenvolvimento permanecem, mesmo se você não tiver uma infraestrutura de CDN própria, ou se ela for substancialmente diferente da nossa.
A importância da velocidade das solicitações para os negócios também continua. E mesmo para um serviço simples, é necessário fazer uma escolha: entre provedores “na nuvem”, localização dos servidores, provedores de CDN e DNS. Sua escolha influenciará a eficácia das solicitações de internet para seus clientes. E é importante que você meça e compreenda essa influência.
Comece com soluções simples, cuide do modo como você altera o produto. Aprenda no processo e melhore o sistema com base nos dados de seus clientes, de sua infraestrutura e de seu negócio. Pense na possibilidade de falhas inesperadas durante o projeto. Assim, você poderá acelerar seu processo de desenvolvimento, melhorar a eficácia da solução, evitar sobrecargas no suporte e dormir tranquilamente.
Este ano em formato online. Será possível fazer perguntas a um dos pais do DevOps, o próprio John Willis!
Fonte: habr.com
