

Olá a todos, compartilhamos com vocês a segunda parte da publicação "Sistemas de Arquivos Virtuais no Linux: por que são necessários e como funcionam?" A primeira parte pode ser lida . Lembramos que esta série de publicações está relacionada ao lançamento de um novo curso , que começará em breve.
Como monitorar o VFS com ferramentas eBPF e bcc
A maneira mais simples de entender como o kernel opera os arquivos sysfs – é observar isso na prática, e a forma mais fácil de observar o ARM64 é usar o eBPF. eBPF (abreviação de Berkeley Packet Filter) é uma máquina virtual executada no , que usuários privilegiados podem acessar (query) a partir da linha de comando. O código-fonte do kernel informa ao leitor o que o kernel pode fazer; executar ferramentas eBPF em um sistema carregado mostra o que o kernel realmente faz.
Felizmente, começar a usar o eBPF é bastante fácil com as ferramentas , que estão disponíveis como pacotes na distribuição geral e são amplamente documentadas . As ferramentas bcc são scripts em Python com pequenos trechos de código em C, o que significa que qualquer um que conheça ambas as linguagens pode facilmente modificá-los. No bcc/tools existem 80 scripts em Python, o que significa que provavelmente um desenvolvedor ou administrador de sistemas conseguirá encontrar algo adequado para resolver a tarefa.
Para ter pelo menos uma noção superficial do trabalho realizado pelo VFS em um sistema em execução, experimente vfscount ou vfsstat. Isso mostrará, por exemplo, que dezenas de chamadas vfs_open() e seus "amigos" ocorrem literalmente a cada segundo.
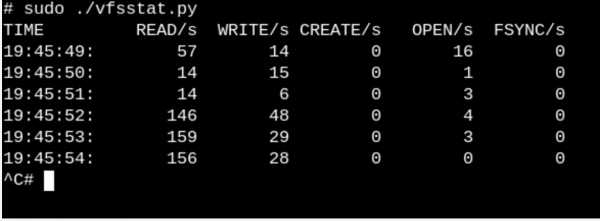
vfsstat.pyé um script em Python, com inserções de código em C, que simplesmente conta as chamadas de funções VFS.
Vamos dar um exemplo mais trivial e ver o que acontece quando conectamos um pen drive ao computador e o sistema o detecta.
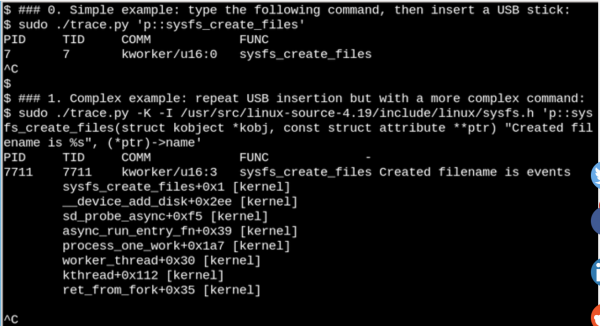
Com o eBPF, podemos ver o que acontece em
/sys, quando o pen drive é inserido. Aqui está um exemplo simples e um complicado.
No exemplo mostrado acima, bcc ferramenta gera uma mensagem quando o comando é executado sysfs_create_files(). Vemos que sysfs_create_files() foi iniciado por meio de kworker em resposta à inserção do pen drive, mas qual arquivo foi criado? O segundo exemplo mostra todo o poder do eBPF. Aqui trace.py exibe o backtrace do núcleo (kernel backtrace) (opção -K) e o nome do arquivo que foi criado sysfs_create_files(). A inserção em declarações simples é um código em C que inclui uma string de formato facilmente reconhecível, fornecida por um script Python que executa o LLVM compilador just-in-time. Essa string é compilada e executada em uma máquina virtual dentro do núcleo. A assinatura completa da função sysfs_create_files () deve ser reproduzida no segundo comando para que a string de formato possa se referir a um dos parâmetros. Erros nesse trecho de código em C levam a erros reconhecíveis do compilador C. Por exemplo, se um parâmetro -l for omitido, você verá "Falha ao compilar o texto BPF." Desenvolvedores que estão bem familiarizados com C e Python acharão as ferramentas bcc simples de expandir e modificar.
Quando o pen drive USB é inserido, o backtrace do núcleo mostrará que o PID 7711 é o thread kworker, que criou o arquivo "events" em sysfs. Assim, a chamada com sysfs_remove_files() mostrará que a remoção do dispositivo resultou na exclusão do arquivo events, o que corresponde ao conceito geral de contagem de referências. Nesse processo, visualizar sysfs_create_link () com eBPF durante a inserção do pen drive USB mostrará que foram criadas pelo menos 48 links simbólicos.
Então, qual é o significado do arquivo events? O uso de para buscar , mostra que ela chama disk_add_events (), e ou "media_change", ou "eject_request" podem ser registrados no arquivo de eventos. Aqui, a camada de bloco do núcleo informa o espaço do usuário sobre a inserção e remoção de um "disco". Observe como esse método de investigação é informativo, usando o exemplo da inserção do pen drive USB em comparação com as tentativas de descobrir como tudo funciona apenas a partir dos códigos-fonte.
Sistemas de arquivos somente leitura tornam possíveis os dispositivos incorporados
Claro, ninguém desliga um servidor ou seu computador puxando o plugue da tomada. Mas por quê? Tudo porque os sistemas de arquivos montados em dispositivos de armazenamento físico podem ter gravações pendentes, e as estruturas de dados que registram seu estado podem não estar sincronizadas com os registros no armazenamento. Quando isso acontece, os proprietários do sistema têm que esperar pela próxima inicialização para executar a ferramenta fsck filesystem-recovery e, na pior das hipóteses, perder dados.
No entanto, todos nós sabemos que muitos dispositivos IoT, bem como roteadores, termostatos e automóveis, agora funcionam com Linux. Muitos desses dispositivos praticamente não têm interface de usuário, e não há como desligá-los 'limpamente'. Imagine ligar um carro com a bateria descarregada, enquanto a alimentação do dispositivo de controle está constantemente oscilando. Como é possível que o sistema inicie sem um longo fsck, quando finalmente o motor começa a funcionar? A resposta é simples. Dispositivos embarcados confiam no sistema de arquivos raiz (abreviado ro-rootfs (sistema de arquivos raiz somente leitura)).
ro-rootfs oferecem muitas vantagens que são menos óbvias do que a autenticidade. Uma das vantagens é que malware não pode gravar em /usr ou /lib, se nenhum processo Linux puder escrever lá. Outra é que um sistema de arquivos em grande parte imutável é crucial para o suporte de campo de dispositivos remotos, pois a equipe de assistência usa sistemas locais que são nominalmente idênticos aos sistemas no local. Talvez a vantagem mais importante (mas também a mais traiçoeira) seja que ro-rootfs força os desenvolvedores a decidir quais objetos de sistema serão imutáveis já na fase de design do sistema. Trabalhar com ro-rootfs pode ser inconveniente e doloroso, como costuma ser com variáveis const em linguagens de programação, mas suas vantagens compensam facilmente o custo adicional.
Criar rootfs somente para leitura exige um esforço extra por parte dos desenvolvedores de sistemas embarcados, e é aqui que entra o VFS. O Linux exige que arquivos em /var sejam acessíveis para gravação, e, além disso, muitos aplicativos populares que executam sistemas embarcados tentarão criar dot-files em $HOME. Uma das soluções para arquivos de configuração no diretório home geralmente é sua pré-geração e empacotamento em rootfs. Para /var uma das abordagens possíveis é montá-lo em uma partição separada, acessível para gravação, enquanto o próprio / monta apenas em modo somente leitura. Outra alternativa popular é o uso de montagens vinculadas ou sobrepostas (bind ou overlay mounts).
Montagens vinculadas e sobrepostas, seu uso por contêineres
Executando o comando man mount é a melhor maneira de aprender sobre montagens vinculadas e sobrepostas, que permitem que desenvolvedores e administradores de sistema criem um sistema de arquivos em um caminho e, em seguida, o disponibilizem para aplicações em outro. Para sistemas embutidos, isso significa poder armazenar arquivos em /var em um pen drive disponível apenas para leitura, mas a montagem sobreposta ou vinculada de um caminho de tmpfs em /var na inicialização permitirá que as aplicações escrevam lá anotações (scrawl). Na próxima inicialização, as mudanças em /var serão perdidas. A montagem sobreposta cria uma união entre tmpfs e o sistema de arquivos subjacente e permite fazer alterações aparentemente em arquivos existentes em ro-tootf enquanto a montagem vinculada pode tornar novas pastas vazias visíveis como disponíveis para gravação em tmpfs caminhos. Enquanto ro-rootfs overlayfs é o tipo correto ( proper) de sistema de arquivos, a montagem vinculada é implementada noespaço de nomes VFS .
contêineres Linux systemd-nspawn mountsnoop system-nspawn de bcc.
Chamada inicia o contêiner durante a execução mountsnoop.py Vamos ver o que ocorreu:.
durante o "início" do contêiner, mostra que o ambiente de execução do contêiner depende fortemente da montagem vinculada (Apenas o início de uma longa saída é exibido).
Iniciar system-nspawn fornece arquivos selecionados do
Aqui para iniciar um contêiner, utilizando a ferramenta host para o contêiner como caminhos em seu procfs. e sysfs . Além do rootfsMS_BIND flag, que estabelece a montagem vinculada, algumas outras flags no sistema montado definem a relação entre as mudanças no espaço de nomes do host e do contêiner. Por exemplo, a montagem vinculada pode ou passar as mudanças em para o contêiner, ou oculta-las dependendo da chamada. /proc e /sys em um contêiner ou ocultá-los dependendo da chamada.
Conclusão
Entender a estrutura interna do Linux pode parecer uma tarefa impossível, já que o núcleo contém uma enorme quantidade de código, além das aplicações do espaço do usuário Linux e das interfaces de chamada de sistema nas bibliotecas em C, como glibc. Uma das maneiras de avançar é ler o código-fonte de um subsistema do núcleo, com foco na compreensão das chamadas de sistema e dos cabeçalhos direcionados ao espaço do usuário, bem como nas principais interfaces internas do núcleo, por exemplo, a tabela file_operations. As operações de arquivo sustentam o princípio de que "tudo é um arquivo", tornando o gerenciamento delas especialmente agradável. Os arquivos de origem do núcleo em C no diretório de nível superior fs/ representam a implementação de sistemas de arquivos virtuais, que atuam como uma camada de shell, proporcionando ampla e relativamente simples compatibilidade com sistemas de arquivos e dispositivos de armazenamento populares. O montagem por ligação e sobreposição através de namespaces no Linux é a mágica do VFS, que torna possível a criação de contêineres e sistemas de arquivos raiz somente para leitura. Juntamente com o estudo do código-fonte, a ferramenta do núcleo eBPF e sua interface bcc
tornam a exploração do núcleo mais fácil do que nunca.
Amigos, escrevam se este artigo foi útil para vocês? Talvez vocês tenham alguns comentários ou observações? E aqueles que se interessam pelo curso "Administrador Linux" estão convidados para o , que ocorrerá em 18 de abril.
Fonte: habr.com
