

A motivação para escrever este artigo foram os muitos materiais sobre análise estática que têm aparecido cada vez mais. Em primeiro lugar, este é o , que se promove ativamente no Habr por meio de análises de erros encontrados por sua ferramenta em projetos de código aberto. Recentemente, a PVS-studio implementou , e, claro, os desenvolvedores do IntelliJ IDEA, cujo analisador integrado é, atualmente, provavelmente o mais avançado para Java, .
Ao ler tais análises, surge a sensação de que se trata de uma poção mágica: pressione um botão e lá está — uma lista de defeitos diante de você. Parece que, à medida que os analisadores melhoram, mais e mais erros serão automaticamente detectados, e os produtos, analisados por esses robôs, se tornarão cada vez melhores, sem qualquer esforço da nossa parte.
Mas poções mágicas não existem. Eu gostaria de falar sobre o que geralmente não é mencionado em postagens como "veja o que nosso robô pode encontrar": o que os analisadores não conseguem fazer, qual é o seu verdadeiro papel e lugar no processo de entrega de software, e como implementá-los corretamente.
Relé (fonte: ).
O que os analisadores estáticos nunca poderão fazer
O que é, do ponto de vista prático, a análise de código-fonte? Nós fornecemos alguns códigos-fonte, e em um curto espaço de tempo (muito mais curto do que a execução de testes) obtemos algumas informações sobre o nosso sistema. A limitação fundamental e matematicamente insuperável é que, dessa forma, podemos obter apenas uma classe bastante restrita de informações.
O exemplo mais famoso de um problema que não pode ser resolvido por meio de análise estática é a : é um teorema que demonstra que não é possível desenvolver um algoritmo geral que, dado o código-fonte de um programa, determine se ele ficará em loop ou se terminará em um tempo finito. Uma extensão desse teorema é , afirmando que, para qualquer propriedade não trivial de funções computáveis, a definição de se um programa arbitrário calcula uma função com essa propriedade é um problema algorítmicamente indecidível. Por exemplo, é impossível escrever um analisador que, a partir de qualquer código-fonte, determine se o programa analisado é uma implementação de um algoritmo que calcula, digamos, o quadrado de um número inteiro.
Assim, a funcionalidade dos analisadores estáticos tem limitações intransponíveis. Um analisador estático nunca conseguirá, em todos os casos, determinar coisas como, por exemplo, a ocorrência de uma «exceção de ponteiro nulo» em linguagens que permitem o valor nulo, ou em todos os casos determinar a ocorrência de «atributo não encontrado» em linguagens com tipagem dinâmica. Tudo o que o analisador estático mais avançado pode fazer é destacar casos particulares, cuja quantidade entre todos os possíveis problemas com seu código-fonte é, sem exagero, uma gota no oceano.
Análise estática não é busca de bugs
Do exposto, segue a conclusão: análise estática não é um meio de reduzir a quantidade de defeitos em um programa. Arrisco-me a afirmar: ao ser aplicado pela primeira vez em seu projeto, ele encontrará no código 'pontos interessantes', mas, provavelmente, não encontrará nenhum defeito que afete a qualidade do funcionamento do seu programa.
Os exemplos de defeitos encontrados automaticamente por analisadores são impressionantes, mas não se deve esquecer que esses exemplos foram encontrados por meio da varredura de um grande número de grandes bases de código. Da mesma forma, hackers que têm a capacidade de testar várias senhas simples em uma grande quantidade de contas eventualmente encontrarão aquelas contas que têm senhas simples.
Isso significa que a análise estática não deve ser aplicada? Claro que não! E exatamente pela mesma razão pela qual vale a pena verificar cada nova senha para ver se ela está na lista de 'senhas simples'.
Análise estática é mais do que busca de bugs
Na verdade, as tarefas que podem ser resolvidas pela análise são muito mais amplas. Afinal, no geral, a análise estática é qualquer verificação de código-fonte realizada antes de sua execução. Aqui estão algumas coisas que podem ser feitas:
- A verificação do estilo de codificação no sentido amplo da palavra. Isso inclui tanto a verificação de formatação quanto a busca por uso de parênteses desnecessários, a configuração de limites para métricas como o número de linhas / a complexidade ciclomática de um método etc. — tudo o que pode potencialmente dificultar a legibilidade e a manutenção do código. Em Java, uma ferramenta desse tipo é o Checkstyle, em Python, o flake8. Programas dessa classe são geralmente chamados de 'linters'.
- A análise pode ser aplicada não apenas ao código executável. Arquivos de recursos, como JSON, YAML, XML, .properties podem (e devem!) ser automaticamente verificados quanto à validade. Afinal, é melhor descobrir que a estrutura JSON foi comprometida devido a algumas aspas não pareadas em uma etapa inicial da verificação automática do Pull Request do que durante a execução dos testes ou em tempo de execução? Existem ferramentas apropriadas, como, por exemplo, , .
- A compilação (ou parsing para linguagens de programação dinâmicas) também é um tipo de análise estática. Normalmente, compiladores são capazes de emitir avisos que sinalizam problemas com a qualidade do código-fonte, e estes não devem ser ignorados.
- Às vezes, a compilação não se limita apenas à compilação do código executável. Por exemplo, se você tiver documentação em formato , no momento em que ela é convertida para HTML/PDF, o processador AsciiDoctor () pode emitir avisos, por exemplo, sobre links internos quebrados. E isso é uma razão significativa para não aceitar um Pull Request com alterações na documentação.
- A verificação ortográfica também é um tipo de análise estática. A ferramenta pode verificar a ortografia não apenas em documentação, mas também em códigos fonte de programas (comentários e literais) em várias linguagens de programação, incluindo C/C++, Java e Python. Um erro de ortografia na interface do usuário ou na documentação também é um defeito!
- Os testes de configuração (sobre o que isso é — veja e relatórios), embora sejam executados em ambientes de teste modular como pytest, na verdade também são uma forma de análise estática, pois não executam os códigos-fonte durante sua execução.
Como vemos, a busca por bugs nessa lista desempenha o papel menos importante, enquanto tudo o que é necessário está disponível através do uso de ferramentas open source gratuitas.
Quais desses tipos de análise estática devem ser aplicados em seu projeto? Claro, todos eles — quanto mais, melhor! O importante é implementá-los corretamente, sobre o que falaremos a seguir.
O pipeline de entrega como um filtro em várias etapas e a análise estática como seu primeiro estágio
A metáfora clássica de integração contínua é um pipeline, pelo qual as mudanças fluem — desde a alteração do código fonte até a entrega em produção. A sequência padrão de etapas deste pipeline é a seguinte:
- análise estática
- compilação
- testes de unidade
- testes de integração
- testes de interface do usuário
- verificação manual
Mudanças rejeitadas na etapa N do pipeline não são transferidas para a etapa N+1.
Por que exatamente assim e não de outra forma? Na parte do pipeline que diz respeito aos testes, os testadores conhecem bem a famosa pirâmide de testes.
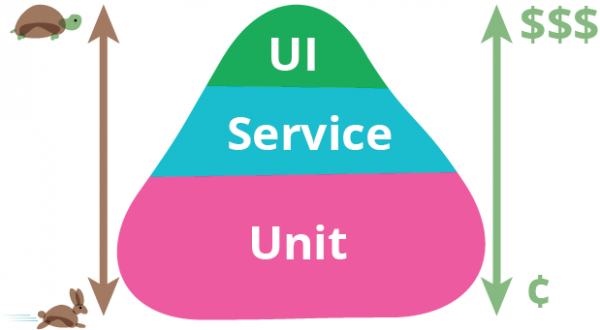
Pirâmide de testes. Fonte: Martin Fowler.
Na parte inferior dessa pirâmide estão os testes que são mais fáceis de escrever, que são executados mais rapidamente e não tendem a gerar falsos positivos. Portanto, deve haver mais deles, cobrindo mais código e sendo executados primeiro. Na parte superior da pirâmide, a situação é exatamente o oposto, por isso o número de testes de integração e UI deve ser reduzido ao mínimo necessário. A pessoa nessa cadeia é o recurso mais caro, lento e menos confiável, portanto, ela está na extremidade e realiza seu trabalho apenas se as etapas anteriores não detectarem nenhum defeito. No entanto, o mesmo princípio se aplica ao pipeline nas partes que não estão diretamente relacionadas aos testes!
Eu gostaria de propor uma analogia com um sistema de filtragem de água em várias etapas. Água suja (mudanças com defeitos) entra, e devemos obter água limpa na saída, com todas as impurezas indesejadas filtradas.
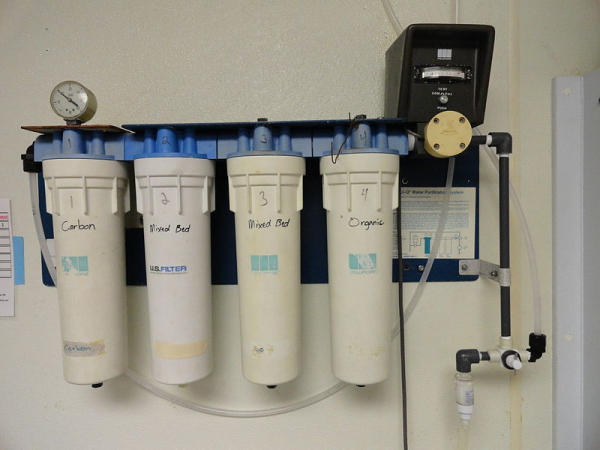
Filtro em várias etapas. Fonte:
Como é sabido, os filtros de limpeza são projetados de modo que cada cascata subsequente possa eliminar frações cada vez menores de poluição. Neste contexto, as cascatas de limpeza mais grossa têm uma maior capacidade de passagem e um custo menor. Em nossa analogia, isso significa que os quality gates de entrada têm um desempenho melhor, requerem menos esforço para serem acionados e são, por si mesmos, mais simples de operar — e justamente nessa sequência estão organizados. O papel da análise estática, que agora entendemos ser capaz de filtrar apenas os defeitos mais grosseiros — é o papel de uma grelha de
O que sabemos é que a análise estática, por si só, não melhora a qualidade do produto final, assim como a grelha não torna a água potável. No entanto, a sua importância é evidente quando combinada com outros elementos da linha de produção. Embora, em um filtro em múltiplas cascatas, as cascatas de saída possam potencialmente capturar o mesmo que as de entrada — é claro quais serão as consequências de tentar depender apenas das cascatas de filtragem fina, sem as cascatas de entrada.
O objetivo da grelha é aliviar as cascatas subsequentes de capturarem defeitos realmente grosseiros. Por exemplo, pelo menos o indivíduo que realiza a revisão de código não deve ser distraído por código mal formatado e violações das normas de codificação estabelecidas (como parênteses desnecessários ou ramificações muito profundamente aninhadas). Bugs como o NPE devem ser identificados por testes unitários, mas se antes do teste o analisador nos informa que um bug ocorrerá inevitavelmente — isso acelerará significativamente sua correção.
Acredito que agora está claro por que a análise estática não melhora a qualidade do produto quando aplicada de forma esporádica, e deve ser utilizada regularmente para filtrar mudanças com defeitos grosseiros. A questão sobre se o uso de um analisador estático melhorará a qualidade do seu produto é aproximadamente equivalente à pergunta: "Asqualidades da água potável provenientes de um corpo d'água sujo melhorarão se forem passadas por uma peneira?"
Implementação em um projeto legado
Uma questão prática importante: como implementar a análise estática no processo de integração contínua como um "quality gate"? No caso de testes automáticos, tudo é claro: existe um conjunto de testes, e a falha em qualquer um deles é motivo suficiente para considerar que a compilação não passou pelo quality gate. Tentar estabelecer um gate com base nos resultados da análise estática falha: no código legado, há muitas advertências de análise, não queremos ignorá-las completamente, mas também não é possível interromper a entrega do produto apenas porque existem advertências do analisador.
Quando aplicado pela primeira vez em qualquer projeto, o analisador gera uma grande quantidade de advertências, a maioria das quais não se relaciona com o funcionamento correto do produto. Corrigir todos esses pontos imediatamente não é viável, e muitos nem precisam ser corrigidos. Afinal, sabemos que nosso produto, de maneira geral, funciona, mesmo antes da implementação da análise estática!
Como resultado, muitos se limitam ao uso esporádico da análise estática ou a utilizam apenas em modo informativo, quando um relatório do analisador é simplesmente gerado durante a compilação. Isso é equivalente à ausência de qualquer análise, pois se já temos uma série de advertências, a ocorrência de mais uma (por mais séria que seja) ao alterar o código passa despercebida.
Os seguintes métodos de implementação de quality gates são conhecidos:
- Definir um limite para o número total de advertências ou para o número de advertências dividido pelo número de linhas de código. Isso funciona mal, pois esse gate deixa passar mudanças com novos defeitos enquanto seu limite não for excedido.
- A fix for all old warnings in the code at a specific moment as ignored, and a refusal to compile when new warnings arise. This functionality is provided by PVS-studio and some online resources, such as Codacy. I haven't worked with PVS-studio; regarding my experience with Codacy, their main issue is that determining what is an 'old' versus a 'new' error is quite complex and doesn't always function correctly, especially when files are heavily modified or renamed. In my memory, Codacy has been known to miss new warnings in pull requests while also blocking pull requests due to warnings unrelated to the changes in that PR.
- In my view, the most effective solution is described in the book the 'ratcheting method'. The main idea is that a property of each release is the number of static analysis warnings, and only changes that do not increase the total number of warnings are permitted.
Ratcheting
It works like this:
- At the initial stage, metadata is recorded about the release regarding the number of warnings in the code found by analyzers. Thus, when the main branch is built, your repository manager records not just 'release 7.0.2,' but 'release 7.0.2, containing 100,500 Checkstyle warnings.' If you are using an advanced repository manager (such as Artifactory), saving such metadata about your release is easy.
- Now, each pull request compares the number of resulting warnings upon compilation with the number present in the current release. If the PR results in an increase in this number, the code does not pass the quality gate for static analysis. If the number of warnings decreases or remains unchanged, it passes.
- In the next release, the recalculated number of warnings will again be recorded in the release's metadata.
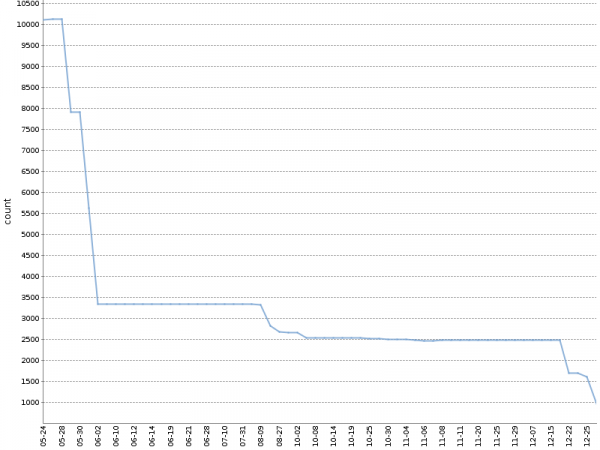
Assim, lentamente, mas de forma constante (como funciona um mecanismo de ratchet), o número de avisos tende a zero. Claro, é possível enganar o sistema, inserindo um novo aviso enquanto corrige outro. Isso é normal, pois a longo prazo resulta em eficácia: os avisos geralmente são corrigidos não um a um, mas em grupos de um determinado tipo, e todos os avisos facilmente removíveis são eliminados rapidamente.
Este gráfico mostra o total de avisos do Checkstyle acumulados ao longo de seis meses de operação de tal "mecanismo de ratchet" em O número de avisos foi reduzido drasticamente, e isso ocorreu de forma natural, paralelamente ao desenvolvimento do produto!
Eu aplico uma versão modificada desse método, contando separadamente os avisos por módulos do projeto e pelas ferramentas de análise. O arquivo YAML gerado com metadados da compilação se parece aproximadamente com isto:
celesta-sql:
  checkstyle: 434
  spotbugs: 45
celesta-core:
  checkstyle: 206
  spotbugs: 13
celesta-maven-plugin:
  checkstyle: 19
  spotbugs: 0
celesta-unit:
  checkstyle: 0
  spotbugs: 0
Em qualquer sistema CI avançado, o "mecanismo de ratchet" pode ser implementado para qualquer ferramenta de análise estática, sem depender de plugins e ferramentas de terceiros. Cada um dos analisadores gera seu relatório em formato de texto simples ou XML, fácil de analisar. Basta escrever a lógica necessária no script CI. É possível verificar como isso foi implementado em nossos projetos de código aberto baseados em Jenkins e Artifactory. ou Ambos os exemplos dependem da biblioteca : o método countWarnings() conta as tags xml nos arquivos gerados pelo Checkstyle e Spotbugs, enquanto que compareWarningMaps() implementa o verdadeiro mecanismo de ratchet, lançando um erro caso o número de avisos em qualquer uma das categorias aumente.
Uma abordagem interessante para a implementação de um "ratchet" é analisar a ortografia de comentários, literais de texto e documentação com o uso do aspell. Como é sabido, na verificação ortográfica, nem todas as palavras desconhecidas para o dicionário padrão são consideradas erradas, pois podem ser adicionadas ao dicionário do usuário. Se o dicionário do usuário for parte do código-fonte do projeto, então o quality gate para ortografia pode ser formulado da seguinte maneira: executar o aspell com o dicionário padrão e o dicionário do usuário. encontrar erros de ortografia.
Sobre a importância de fixar a versão do analisador
Em conclusão, é importante notar o seguinte: independentemente da forma como você implementar a análise em seu pipeline de entrega, a versão do analisador deve ser fixada. Se permitir uma atualização espontânea do analisador, novos defeitos podem "surgir" ao compilar um pull request, que não estão relacionados a alterações no código, mas ao fato de que o novo analisador é capaz de detectar mais defeitos — e isso poderá comprometer seu processo de aceitação de pull requests. A atualização do analisador deve ser uma ação consciente. No entanto, a fixação rigorosa da versão de cada componente da compilação é uma exigência geral necessária e um tema para uma conversa separada.
Como resultado, obtemos um serviço de "monitoramento como serviço", automatizado na linha de produção de integração contínua. O desenvolvedor ou testador precisa apenas definir a lista de métricas em um arquivo JSON, e tudo o mais acontece automaticamente. Obtemos um controle de qualidade transparente dos lançamentos: todas as notificações sobre desempenho, consumo de recursos ou regressões arquitetônicas.
- A análise estática não encontrará bugs nem melhorará a qualidade do seu produto como resultado de uma única aplicação. O efeito positivo na qualidade só aparece com a aplicação contínua durante o processo de entrega.
- A busca por bugs não é, de fato, a principal função da análise; a esmagadora maioria das funções úteis está disponível em ferramentas de código aberto.
- Implemente quality gates com base nos resultados da análise estática na primeira etapa do pipeline de entrega, utilizando o "ratchet" para código legado.
Links
- palestra sobre diferentes métodos de análise de código (não apenas estática!)
Fonte: habr.com
