

Olá a todos. Abaixo está a transcrição .
– um sistema de monitoramento de diferentes sistemas e serviços, através do qual os administradores de sistemas podem coletar informações sobre os parâmetros atuais dos sistemas e configurar alertas para receber notificações sobre desvios no funcionamento dos sistemas.
A apresentação fará uma comparação e — de projetos para armazenamento de métricas a longo prazo no Prometheus.
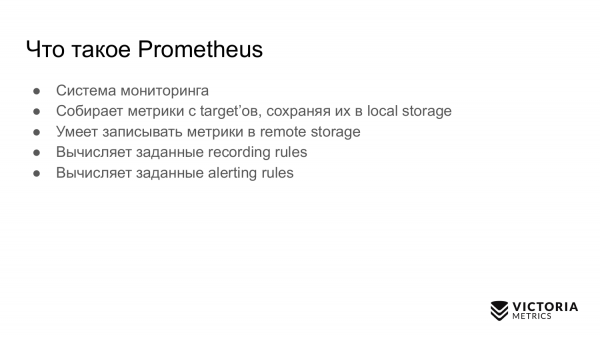
Primeiro, falarei sobre o Prometheus. É um sistema de monitoramento que coleta métricas de alvos designados e as salva em um armazenamento local. O Prometheus consegue gravar métricas em armazenamento remoto, gerar alertas e regras de gravação.
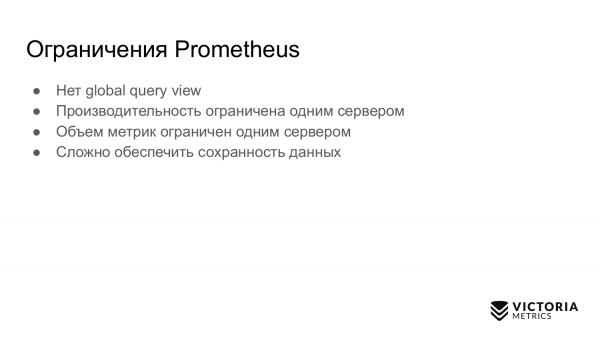
Limitações do Prometheus:
- Ele não possui uma visão global de consulta. Isso acontece quando você tem várias instâncias independentes do Prometheus. Elas coletam métricas. E você deseja fazer uma consulta sobre todas essas métricas coletadas de diferentes instâncias do Prometheus. O Prometheus não permite isso.
- A performance do Prometheus é limitada a um único servidor. O Prometheus não pode escalar automaticamente para vários servidores. Você pode apenas dividir manualmente seus alvos entre várias instâncias do Prometheus.
- O volume de métricas no Prometheus é limitado a um único servidor pela mesma razão pela qual ele não pode escalar automaticamente para vários servidores.
- No Prometheus, não é tão fácil organizar a persistência dos dados.
Soluções para esses problemas/tarefas?
As soluções são as seguintes:
Todas essas soluções são para armazenamento remoto de dados coletados pelo Prometheus. Elas abordam o problema do armazenamento remoto da apresentação anterior de maneiras diferentes. Nesta apresentação, falarei apenas sobre as duas primeiras soluções: e .
As informações sobre apareceram pela primeira vez em . Ela descreve a arquitetura e como funciona.
O Thanos pega os dados que o Prometheus salvou no disco local e os copia para o S3, para ou para outro armazenamento de objetos.
Dessa forma, o Thanos proporciona uma visão global de consulta. Você pode consultar dados armazenados em armazenamento de objetos de várias instâncias do Prometheus.
O Thanos suporta PromQL e .
O Thanos utiliza o código do Prometheus para armazenamento de dados.
O Thanos é desenvolvido pelos mesmos desenvolvedores do Prometheus.
Sobre . Aqui está , onde falamos pela primeira vez sobre .
O VictoriaMetrics recebe dados de vários Prometheus através da protocolo suportado pelo Prometheus.
VictoriaMetrics oferece uma visão global de consulta, pois várias instâncias do Prometheus podem gravar dados em uma única VictoriaMetrics. Assim, você pode fazer consultas sobre todos esses dados.

VictoriaMetrics também suporta, assim como o Thanos, PromQL e a API de consulta do Prometheus.
Ao contrário do Thanos, o código fonte da VictoriaMetrics foi escrito do zero e otimizado para velocidade e consumo de recursos.
VictoriaMetrics, ao contrário do Thanos, se escala tanto vertical quanto horizontalmente. Existe , que se escala verticalmente. Você pode começar com um processador e 1 GB de memória e crescer gradualmente até centenas de processadores e 1 TB de memória. A VictoriaMetrics consegue utilizar todos esses recursos. Seu desempenho aumentará cerca de 100 vezes em comparação com um sistema de 1 núcleo.
A história do Thanos começou em novembro de 2017, quando o primeiro commit público foi feito. Antes disso, o Thanos estava sendo desenvolvido internamente na .
Em junho de 2019, houve um lançamento marcante 0.5.0, que protocolo. Ele foi removido do Thanos, pois teve um desempenho abaixo das expectativas. Frequentemente, o cluster Thanos apresentava problemas, com nós se conectando incorretamente devido ao protocolo de gossip. Por isso, decidiram removê-lo. Acredito que essa foi uma decisão acertada.
No mesmo junho de 2019, eles enviaram o pedido número em .
E, após alguns meses, o Thanos foi aceito na , que inclui o Prometheus, Kubernetes e outros projetos populares.
Em janeiro de 2018, começou o desenvolvimento da VictoriaMetrics.
Em setembro de 2018, mencionei publicamente a VictoriaMetrics pela primeira vez.
Em dezembro de 2018, publicaram a versão de nó único.
Em maio de 2019 os códigos-fonte tanto da versão de nó único quanto da versão em cluster.
Em junho de 2019, assim como o Thanos, enviamos um pedido para a fundação CNCF sob o número . Enviamos nosso pedido um dia antes do Thanos.
Mas, infelizmente, ainda não fomos aceitos lá. Precisamos da ajuda da comunidade.
Vamos considerar os slides mais importantes que mostram a arquitetura do Thanos e da VictoriaMetrics.
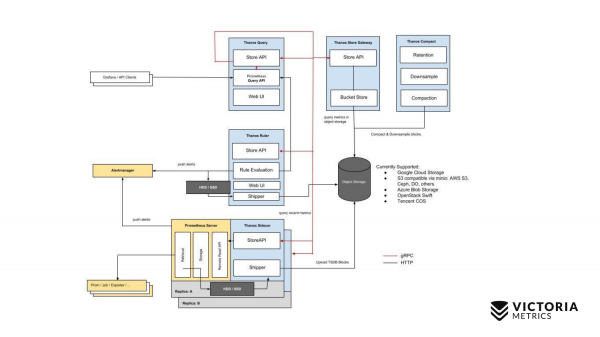
Começamos com o Thanos. Os componentes amarelos são componentes do Prometheus. Todo o resto são componentes do Thanos. Começaremos com o componente mais importante. O Thanos Sidecar é um componente que é instalado ao lado de cada Prometheus. Ele se encarrega de carregar os dados do Prometheus do armazenamento local para o S3 ou outro armazenamento de objetos.
Há também um componente chamado Thanos Store Gateway, que pode ler esses dados do Object Storage em solicitações recebidas do Thanos Query. O Thanos Query implementa PromQL e a API do Prometheus. Ou seja, do lado de fora, ele parece um Prometheus. Aceita solicitações PromQL, as envia para o Thanos Store Gateway, que extrai os dados necessários do Object Storage e os envia de volta.
Mas em nosso Object Storage, os dados dos últimos duas horas estão armazenados devido à peculiaridade da implementação do Thanos Sidecar, que não pode carregar as últimas duas horas no Object Storage S3, pois, para essas duas horas, o Prometheus ainda não criou os arquivos no armazenamento local.
Como conseguimos contornar isso? O Thanos Query, além de fazer solicitações ao Thanos Store Gateway, envia paralelamente solicitações para cada Thanos Sidecar que está próximo ao Prometheus.
E o Thanos Sidecar, por sua vez, encaminha as solicitações para o Prometheus e obtém os dados das últimas duas horas.
Além desses componentes, há ainda um componente opcional, sem o qual o Thanos terá um desempenho insatisfatório. É o Thanos Compact, que se encarrega de mesclar pequenos arquivos no Object Storage em arquivos maiores que foram carregados lá pelos Thanos Sidecars. O Thanos Sidecar carrega arquivos com dados das últimas duas horas. Esses arquivos, se não forem mesclados em arquivos maiores, podem crescer exponencialmente em número. Quanto mais arquivos houver, mais memória o Thanos Store Gateway precisa, e mais recursos são necessários para a transmissão de dados pela rede, incluindo metadados. O funcionamento do Thanos Store Gateway se torna ineficiente. Portanto, é essencial executar o Thanos Compact, que mescla pequenos arquivos em arquivos maiores, para reduzir a quantidade de arquivos e diminuir a sobrecarga no Thanos Store Gateway.
Há também um componente chamado Thanos Ruler. Ele executa as regras de alerta do Prometheus e pode calcular regras de gravação do Prometheus para que os dados sejam gravados novamente no Object Storage. No entanto, esse componente não é recomendado, pois ele .
Este é o esquema simples do Thanos.
Agora, vamos comparar com o esquema do VictoriaMetrics.
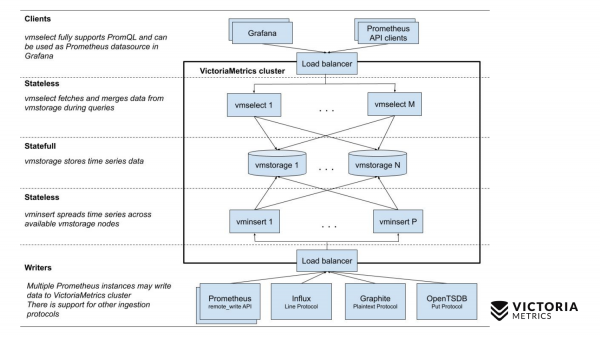
O VictoriaMetrics possui 2 versões: versão de nó único e versão em cluster. A versão de nó único funciona em um único computador. Na versão de nó único, não há esses componentes, apenas um único binário. Esse binário na apresentação é representado por este quadrado. Tudo que está dentro do quadrado é o conteúdo do arquivo binário da versão de nó único. Você não precisa se preocupar com isso. Basta executar o binário e tudo funcionará.
A versão em cluster é mais complexa. Dentro dela, existem três componentes diferentes: vmselect, vminsert e vmstorage. A partir de seus nomes, deve estar claro qual a função de cada um deles. O componente Insert recebe dados em diferentes formatos: da API remote write do Prometheus, do protocolo Influx line, do protocolo Graphite e do protocolo OpenTSDB. O componente Insert os recebe, analisa e distribui entre os componentes de armazenamento disponíveis, onde os dados já são salvos. , bem como a API de consulta do Prometheus, e pode ser usado como uma substituição do Prometheus no Grafana ou em outros clientes da API do Prometheus. O Select recebe consultas em promql, as analisa, lê os dados necessários para executar essa consulta a partir dos nós de armazenamento, processa esses dados e retorna a resposta.
Vamos comparar a complexidade de instalação do Thanos e do VictoriaMetrics.
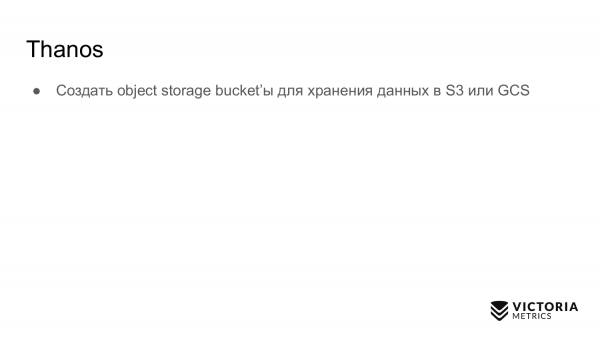
Começaremos com o Thanos. Antes de começar a trabalhar com o Thanos, é necessário criar um bucket em um Armazenamento de Objetos, como S3 ou GCS, para que o Thanos Sidecar possa gravar dados lá.
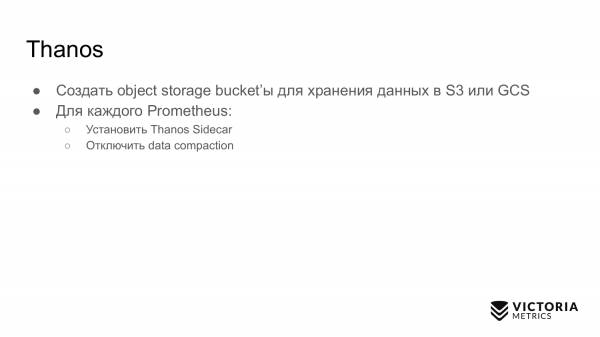
Em seguida, para cada Prometheus, você precisa instalar o Thanos Sidecar. Antes disso, não se esqueça de desativar a compactação de dados no Prometheus. A compactação de dados periodicamente comprime os dados no armazenamento local do Prometheus para reduzir o consumo de recursos.
Quando você instala o Thanos Sidecar nos seus Prometheus, deve desativar essa compactação de dados, porque o Thanos Sidecar não funciona corretamente quando a compactação de dados está ativada. Isso significa que seu Prometheus começa a salvar dados em blocos de duas horas e para de mesclar esses blocos em blocos maiores. Assim, se você fizer consultas que excedem a duração dos últimos dois horas, elas não funcionarão com tanta eficiência como poderiam funcionar se a compactação de dados estivesse habilitada.
Portanto, o Thanos recomenda reduzir o tempo de retenção de dados no armazenamento local para 6-8 horas, a fim de reduzir este overhead de muitos blocos pequenos.
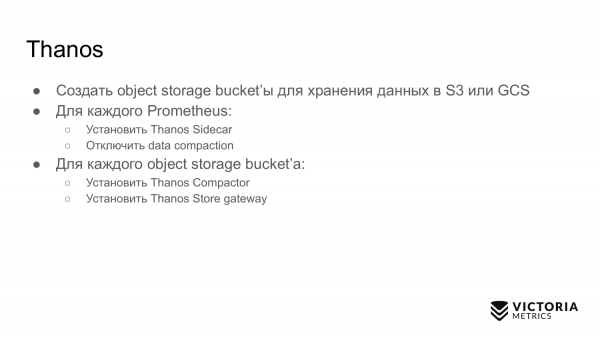
Depois de instalar o Thanos Sidecar, você deve instalar dois componentes para cada bucket do Armazenamento de Objetos. São eles o Thanos Compactor e o Thanos Store Gateway.
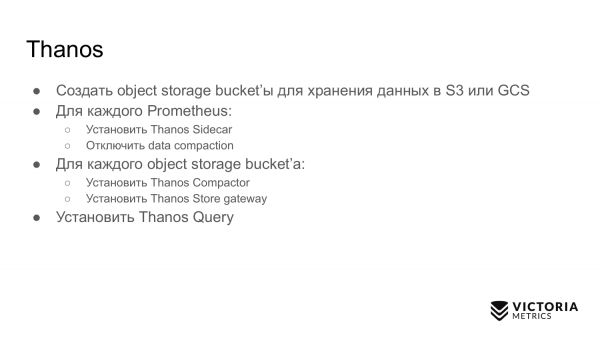
Depois disso, é necessário instalar o Thanos Query e configurá-lo para se conectar a todos os Thanos Store Gateways que você tem, além de conseguir se conectar a todos os Thanos Sidecars.
Aqui pode haver um pequeno problema.
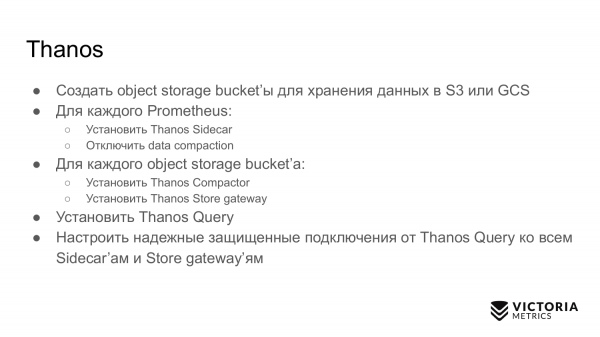
Você precisa configurar uma conexão segura e confiável do Thanos Query para esses componentes. E se seus Prometheus estão em diferentes data centers ou em diferentes VPCs, as conexões externas são proibidas. Mas, para que o Thanos Query funcione, você precisa de alguma forma de estabelecer essa conexão, e deve encontrar uma solução.
Se você tiver muitos desses data centers, a confiabilidade de todo o sistema diminui. Como o Thanos Query deve manter constantemente conexões com todos os Thanos Sidecars localizados em diferentes data centers. A cada solicitação recebida, ele irá encaminhar as requisições para todos os Thanos Sidecars. Se a conexão falhar, você receberá um conjunto de dados incompleto ou a resposta 'o cluster não está funcionando'.
No VictoriaMetrics, tudo é um pouco mais simples. Para a versão de nó único, basta executar um binário e tudo funciona.
Na versão em cluster, basta executar todos os três tipos de componentes mencionados acima na quantidade necessária ou usar para automatizar o início dos componentes no Kubernetes. Também estamos planejando criar um operador para Kubernetes. O Helm chart não cobre alguns casos e pode causar problemas. Por exemplo, ele permite reduzir o número de nós de armazenamento, o que levará à perda de dados.
Após iniciar um binário ou a versão em cluster, você só precisa adicionar à configuração do Prometheus , para que comece a gravar dados simultaneamente no armazenamento local e no armazenamento remoto. Como você percebeu, essa configuração deve funcionar de forma muito mais confiável em comparação com a configuração do Thanos. Não precisamos manter uma conexão do VictoriaMetrics com todos os Prometheus, pois os Prometheus se conectam ao VictoriaMetrics e transmitem os dados.
Vamos considerar a manutenção do Thanos e do VictoriaMetrics.
O Thanos precisa monitorar o Sidecar para que eles não parem de carregar dados no Object Storage. Eles podem interromper esse carregamento devido a erros de upload, como uma desconexão temporária da rede com o Object Storage ou se o Object Storage estiver temporariamente indisponível. Nesse momento, o Thanos Sidecar notará isso, relatará um erro e pode falhar, parando de funcionar. Se você não monitorá-lo, os dados deixarão de ser transferidos para o Object Storage. Se passar o período de retenção (6-8 horas recomendado), você perderá dados que não foram para o Object Storage.
Os compactadores do Thanos podem parar de funcionar devido a . Os compactadores pegam dados do Object Storage e os combinam em blocos de dados maiores. Como os compactadores não estão sincronizados com os Sidecars, pode ocorrer o seguinte: o Sidecar não conseguiu terminar de escrever um bloco, e o Compactador decide que esse bloco está totalmente gravado. O Compactador começa a lê-lo. Ele lê o bloco incompleto e para de funcionar. Veja os detalhes .
O Store Gateway pode fornecer dados inconsistentes devido a conflitos entre o Compactador e os Sidecars. Aqui acontece a mesma situação, pois o Store Gateway não está sincronizado com os Compactadores e Sidecars. Assim, podem surgir condições de corrida, onde o Store Gateway não vê parte dos dados ou vê dados extras.
O componente de Consulta no Thanos, por padrão, retorna um resultado parcial se alguns Sidecars ou o Store Gateway não estiverem disponíveis no momento. Você receberá parte dos dados e não saberá que não recebeu todos os dados. Essa é sua operação padrão. Em uma situação similar, o VictoriaMetrics retorna dados marcados como parciais.
Ao contrário do Thanos, o VictoriaMetrics raramente perde dados. Mesmo se a conexão do Prometheus com o VictoriaMetrics for interrompida, não há problema, pois o Prometheus continua gravando os novos dados que chegam no Write Ahead Log, que tem um tamanho de 2 horas. Se você restaurar a conexão com o VictoriaMetrics dentro de duas horas, os dados não serão perdidos. O Prometheus .
Ao contrário do Thanos, que grava dados no object storage apenas após duas horas, o Prometheus replica automaticamente os dados através do protocolo remote write no remote storage, como o VictoriaMetrics. A perda do local storage no Prometheus não é uma preocupação. Se ele perder o local storage, no pior dos casos, você perderá apenas os últimos segundos de dados que não foram gravados no remote storage.
O Kubernetes gerencia automaticamente o cluster, diferentemente do Thanos. Todos os componentes do Thanos são difíceis de acomodar em um único cluster Kubernetes, ao contrário dos componentes cluster do VictoriaMetrics.
A atualização para uma nova versão do VictoriaMetrics é muito simples. Basta parar o VictoriaMetrics, atualizar os binários e reiniciar. Ao parar com o sinal SIGINT, todos os binários do VictoriaMetrics realizam um gracefull shutdown. Eles salvam corretamente os dados necessários e fecham adequadamente as conexões de entrada, para que nada seja perdido. Portanto, você não perderá nada ao atualizar.
A expansão do cluster no VictoriaMetrics é muito fácil. Basta adicionar os componentes necessários e continuar a trabalhar.
Sobre as armadilhas do Thanos e do VictoriaMetrics.
O Thanos possui as seguintes armadilhas. O Prometheus deve armazenar dados das últimas duas horas. Se esses dados forem perdidos, você os perderá completamente, pois ainda não foram gravados no Object Storage, como o S3.
O componente Store Gateway e o componente compactor podem exigir muita memória para operar com um grande Object Storage, se houver muitos arquivos pequenos armazenados. Quanto maior a quantidade e o volume dos arquivos, mais memória RAM o Store Gateway e o compactor exigirão para armazenar a metainformação. O Thanos tem muitos problemas relacionados a isso. .
O Thanos é promovido como capaz de escalar indefinidamente com o número de seus Prometheus. Na verdade, isso não é verdade. Já que todas as solicitações passam pelo componente Query, que deve consultar em paralelo todos os componentes Store Gateway e todos os componentes Sidecar, extrair os dados de lá e depois preprocessar. É evidente que a velocidade das solicitações é limitada pelo elo mais fraco, seja o Store Gateway mais lento ou o Sidecar mais lento.
Esses componentes podem estar desiguais em carga. Por exemplo, você tem um Prometheus que coleta milhões de métricas por segundo. E há um Prometheus que coleta milhares de métricas por segundo. O Prometheus que coleta milhões de métricas por segundo carrega muito mais o servidor em que está operando. Assim, o Sidecar lá funciona mais lentamente. E, no geral, tudo lá funciona devagar. E o componente de consultas puxará os dados de lá muito lentamente. Portanto, o desempenho de todo o seu cluster será limitado por esse Sidecar lento.
Por padrão, o Thanos fornece dados parciais se alguns Sidecars ou o Store Gateway estiverem inacessíveis. Por exemplo, se seus Sidecars estiverem espalhados pelo mundo em diferentes data centers, a probabilidade de desconexão e inacessibilidade dos componentes aumenta consideravelmente. Assim, na maioria dos casos, você receberá dados parciais, mesmo sem saber.
O VictoriaMetrics também tem suas armadilhas. A primeira armadilha é a opção que limita a quantidade de memória RAM utilizada pelo cache do VictoriaMetrics. Por padrão, essa configuração é igual a 60% da memória RAM na máquina onde o VictoriaMetrics está em execução ou 60% da RAM do pod do VictoriaMetrics no Kubernetes.
Se você alterar esse valor incorretamente, pode comprometer o desempenho do VictoriaMetrics. Por exemplo, se definir um valor muito baixo, os dados podem não caber no cache do VictoriaMetrics. Isso fará com que o sistema precise realizar trabalho adicional e sobrecarregar o processador com o disco. Se essa opção for configurada como muito alta, aumentará, em primeiro lugar, a probabilidade de o VictoriaMetrics falhar com um erro de falta de memória e, em segundo lugar, deixará muito pouca memória RAM disponível para o cache de arquivos no sistema operacional. E o VictoriaMetrics depende do cache de arquivos para o desempenho. Se ele for insuficiente, a carga no disco pode aumentar significativamente. Portanto, a recomendação é não alterar esse parâmetro sem necessidade extrema.
A segunda opção é o retentionPeriod — período que, por padrão, é definido em 1 mês. Esse é o tempo durante o qual o VictoriaMetrics armazena os dados. Após esse prazo, o VictoriaMetrics exclui os dados.
Muitos iniciam o VictoriaMetrics sem esse parâmetro, gravam dados durante um mês. E depois perguntam: por que os dados desapareceram no mês anterior? Porque o retentionPeriod padrão é de 1 mês. Portanto, é necessário saber e definir o retentionPeriod correto.
Vamos explorar as possibilidades únicas.
O Thanos possui um recurso chamado downsampling: intervalos de 5 minutos e hora, que muitas vezes . Se você pesquisar e olhar os problemas dele no GitHub, encontrará muitos problemas relacionados a esse downsampling, que às vezes não funciona como esperado pelos usuários.
O Thanos tem deduplicação de dados para pares de Prometheus HA. Quando dois Prometheus coletam as mesmas métricas dos mesmos targets e o Thanos as armazena no Object Storage. O Thanos é capaz de deduplicar esses dados corretamente, em contraste com o VictoriaMetrics.
O Thanos possui um componente de alerta, que estava no esquema do Thanos. Mas é .
Uma vantagem do Thanos é que o código do Thanos e do Prometheus é compartilhado. O Thanos e o Prometheus foram desenvolvidos pelos mesmos desenvolvedores. Com as melhorias no Thanos, o Prometheus também se beneficia.
A principal característica do VictoriaMetrics é o MetricsQL. É uma extensão do VictoriaMetrics para PromQL, sobre a qual falei no recente meetup de big monitoring.
O VictoriaMetrics suporta a ingestão de dados por diversos protocolos. O VictoriaMetrics pode não só receber dados do Prometheus, mas também através de protocolos como Influx, OpenTSDB e Graphite.
Os dados do VictoriaMetrics geralmente ocupam muito menos espaço em comparação ao Thanos e ao Prometheus.
Ao gravar dados reais, os usuários relatam uma redução de 2 a 5 vezes no tamanho dos dados no disco em comparação com o Prometheus e o Thanos.
Outra vantagem do VictoriaMetrics é que ele é otimizado para velocidade.
Vamos abordar o custo da infraestrutura.
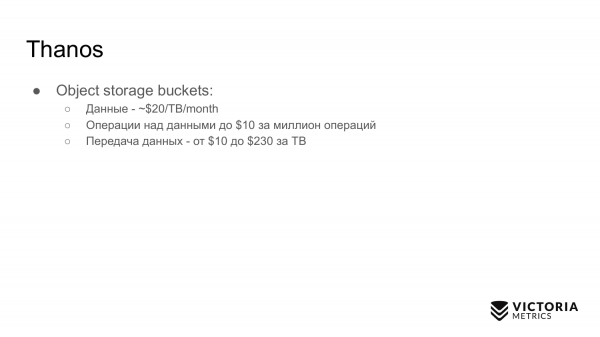
Uma das vantagens do Thanos é que ele armazena dados em object storage, que é relativamente barato.
Ao armazenar dados em object storage, você deve pagar por operações de gravação e leitura de dados ($10 por milhão de operações). Quando você grava dados no object storage, precisa arcar com os custos de upload dos dados pela internet se seu cluster não estiver na AWS — lá é gratuito. Ao ler os dados, você paga de $10 a $230 por 1TB. Isso pode ser significativo se você frequentemente solicitar dados históricos do cluster do Thanos.
Para o cluster Thanos, é necessário pagar pelos servidores para os componentes Compact, Store Gateway e Query, que requerem muita memória e CPU para grandes volumes de dados.
Os custos para o VictoriaMetrics são os seguintes. Se os dados forem armazenados em discos GCE HDD, o custo é de $40 por 1TB. Para o VictoriaMetrics, discos HDD comuns são suficientes, não são necessários SSDs, que custam cinco vezes mais. O VictoriaMetrics é otimizado para HDD.
Para o VictoriaMetrics, são necessários servidores para os componentes: ou Single-nod ou para componentes de cluster, que, ao contrário dos componentes Thanos, requerem muito menos CPU e RAM — portanto, será mais barato.
Exemplos de implantação.
Um exemplo de implantação do Thanos é o Gitlab. O Gitlab funciona completamente no Thanos. Mas as coisas não são tão simples. Se olharmos para eles , podemos ver que eles enfrentam continuamente alguns : a memória para os componentes Store Gateway ou Query é insuficiente. Eles estão constantemente aumentando a quantidade de memória.
Por causa disso, os custos para resolver esses problemas aumentam.
A segunda implantação, que pode ser mais bem-sucedida, é a da empresa Improbable, que começou o desenvolvimento do Thanos. Eles publicaram os fontes do Thanos. A Improbable é uma empresa que desenvolve motores de jogos.
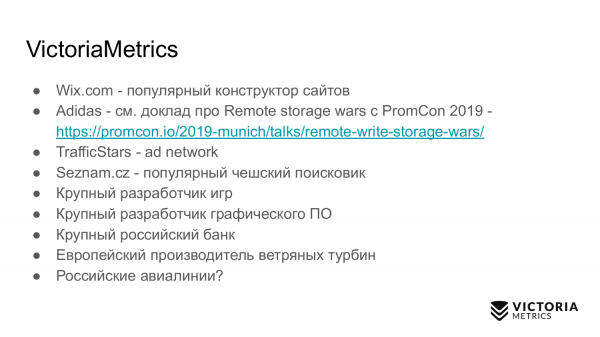
Os exemplos públicos de implantação do VictoriaMetrics são:
- wix.com, criador de sites
- Adidas implementa o VictoriaMetrics e até fez uma apresentação na última PromCon 2019
- TrafficStars — rede de anúncios
- Seznam.cz — popular motor de busca checo.
E depois vieram empresas desconhecidas, que não posso nomear agora. Elas não deram consentimento.
- Um grande desenvolvedor de jogos. Maior do que a Improbable.
- Um grande desenvolvedor de software gráfico.
- Um grande banco russo.
- Um fabricante europeu de turbinas eólicas, que testou com sucesso o VictoriaMetrics. Este fabricante utiliza o VictoriaMetrics para monitorar dados obtidos das turbinas eólicas a uma taxa de 50 amostras por segundo por sensor. Cada turbina eólica tem várias centenas de sensores. Eles têm várias centenas de turbinas eólicas.
- As linhas aéreas russas, que querem implementar o VictoriaMetrics, mas ainda não conseguiram. Estamos em fase de contrato com eles.
 Conclusões.
VictoriaMetrics e Thanos resolvem problemas semelhantes, mas de maneiras diferentes:
- Visão de consulta global
- escalonamento horizontal
- retenção arbitrária
Obrigado.
Estamos esperando por você em nosso .
Apenas usuários registrados podem participar da pesquisa. , por favor.
O que você usa como armazenamento a longo prazo para o Prometheus?
35,3%Thanos6
0,0%Cortex0
0,0%M3DB0
41,2%VictoriaMetrics7
23,5%outro4
17 usuários votaram. 16 usuários se abstiveram.
Fonte: habr.com
