

Zabbix é um sistema de monitoramento. Como qualquer outro sistema, ele enfrenta três problemas principais de todos os sistemas de monitoramento: coleta e processamento de dados, armazenamento de histórico e sua limpeza.
As etapas de recebimento, processamento e gravação de dados consomem tempo. Um pouco, mas para um grande sistema isso pode resultar em grandes atrasos. O problema de armazenamento é uma questão de acesso aos dados. Eles são usados para relatórios, verificações e gatilhos. Os atrasos no acesso aos dados também afetam o desempenho. Quando os bancos de dados crescem, é necessário remover dados obsoletos. A remoção é uma operação pesada que também consome parte dos recursos.
Os problemas de atrasos na coleta e no armazenamento no Zabbix são resolvidos com cache: vários tipos de caches, cache no banco de dados. Para resolver o terceiro problema, o cache não é adequado, por isso o Zabbix utiliza o TimescaleDB. Sobre isso falará Andrey Gushchin — engenheiro de suporte técnico . Andrey está no suporte do Zabbix há mais de 6 anos e lida diretamente com o desempenho.
Como funciona o TimescaleDB, que desempenho pode oferecer em comparação com o PostgreSQL comum? Qual é o papel do Zabbix para o banco de dados TimescaleDB? Como iniciar do zero e como migrar do PostgreSQL, e qual configuração oferece o melhor desempenho? Tudo isso está a seguir.

Desafios de desempenho
Todo sistema de monitoramento enfrenta desafios de desempenho específicos. Vou falar sobre três deles: coleta e processamento de dados, armazenamento, limpeza de histórico.
Coleta e processamento de dados rápidos. Um bom sistema de monitoramento deve coletar rapidamente todos os dados e processá-los de acordo com expressões de gatilho — de acordo com seus critérios. Após o processamento, o sistema também deve salvar rapidamente esses dados no banco de dados para uso posterior.
Armazenamento de histórico. Um bom sistema de monitoramento deve armazenar o histórico no banco de dados e fornecer acesso fácil às métricas. O histórico é necessário para ser utilizado em relatórios, gráficos, gatilhos, limites e elementos de dados calculados para alertas.
Limpeza de histórico. Às vezes, chega o dia em que você não precisa mais armazenar métricas. Para que você precisa de dados coletados há 5 anos, um ou dois meses: alguns nós foram removidos, alguns hosts ou métricas já não são necessários porque se tornaram obsoletos e deixaram de ser coletados. Um bom sistema de monitoramento deve armazenar dados históricos e de tempos em tempos excluí-los para evitar o crescimento excessivo do banco de dados.
A limpeza de dados obsoletos é uma questão crítica que afeta significativamente o desempenho do banco de dados.
Cache no Zabbix
No Zabbix, a primeira e a segunda chamadas são resolvidas por meio de cache. A memória RAM é utilizada para coletar e processar dados. Para armazenamento, utiliza-se a história em gatilhos, gráficos e elementos de dados calculados. Do lado do banco de dados, há um certo caching para as consultas principais, como gráficos.
O cache no próprio servidor Zabbix é:
- ConfigurationCache;
- ValueCache;
- HistoryCache;
- TrendsCache.
Vamos analisá-los em mais detalhes.
ConfigurationCache
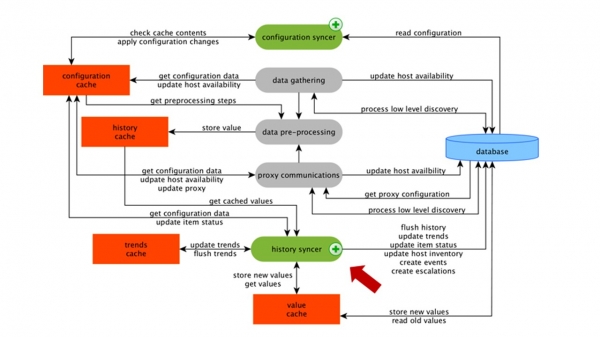
Este é o cache principal onde armazenamos métricas, hosts, elementos de dados, gatilhos - tudo o que é necessário para o PreProcessing e para a coleta de dados.
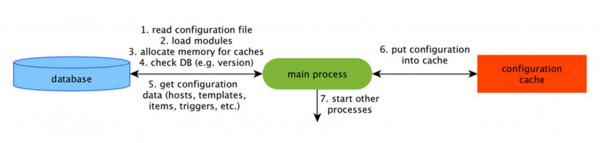
Tudo isso é mantido no ConfigurationCache para evitar fazer requisições desnecessárias ao banco de dados. Após a inicialização do servidor, atualizamos esse cache, criamos e periodicamente atualizamos as configurações.
Coleta de dados
O esquema é bastante amplo, mas o principal nele são coletadores. Esses são diferentes 'pollers' - processos de coleta. Eles são responsáveis por diferentes tipos de coleta: coletam dados via SNMP, IPMI, e transmitem tudo isso para o PreProcessing.
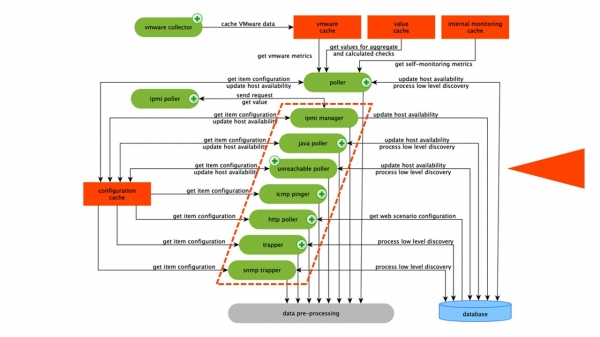 Os coletadores estão destacados com uma linha laranja.
No Zabbix, existem elementos de dados calculados e agregados que são necessários para agregar verificações. Se tivermos esses dados, coletamos informações diretamente do ValueCache.
PreProcessing HistoryCache
Todos os coletadores usam o ConfigurationCache para receber tarefas. Em seguida, eles as transmitem para o PreProcessing.
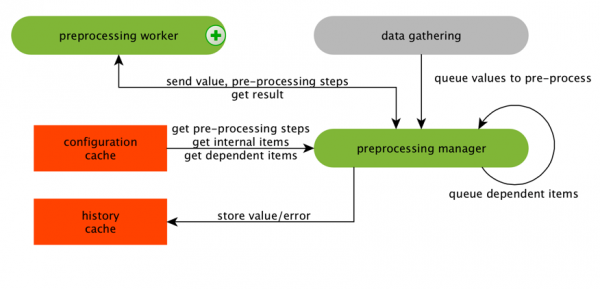
O PreProcessing utiliza o ConfigurationCache para obter os passos do PreProcessing. Ele processa esses dados de várias maneiras.
Após o processamento dos dados com o PreProcessing, os armazenamos no HistoryCache para processá-los. Aqui termina a coleta de dados e passamos para o processo principal no Zabbix - history syncer, uma vez que se trata de uma arquitetura monolítica.
Nota: O PreProcessing é uma operação bastante pesada. A partir da versão 4.2, foi deslocado para o proxy. Se você tem um Zabbix muito grande com um grande número de elementos de dados e frequência de coleta, isso facilita muito o trabalho.
ValueCache, histórico e cache de tendências
O sincronizador de histórico é o processo principal que processa atômica cada elemento de dados, ou seja, cada valor.
O sincronizador de histórico pega valores do HistoryCache e verifica na Configuração a presença de gatilhos para cálculos. Se existirem, ele realiza o cálculo.
O sincronizador de histórico cria um evento, uma escalada, para gerar alertas, se necessário conforme a configuração, e registra. Se houver gatilhos para processamento posterior, ele memoriza esse valor no ValueCache, para não acessar a tabela de história. Assim, o ValueCache é preenchido com os dados necessários para o cálculo dos gatilhos e elementos calculáveis.
O sincronizador de histórico grava todos os dados no banco de dados, que os armazena no disco. O processo de processamento termina nesse ponto.
Cache no Banco de Dados
No lado do banco de dados, existem vários caches quando você deseja visualizar gráficos ou relatórios de eventos:
Innodb_buffer_poolno lado do MySQL;shared_buffersno lado do PostgreSQL;effective_cache_sizeno lado do Oracle;shared_poolno lado do DB2.
Existem muitos outros caches, mas estes são os principais para todos os bancos de dados. Eles permitem manter na memória os dados que são frequentemente necessários para consultas. Cada um com suas próprias tecnologias para isso.
A performance do banco de dados é criticamente importante
O servidor Zabbix continuamente coleta dados e os grava. Ao reiniciar, ele também lê do histórico para preencher o ValueCache. Utiliza scripts e relatórios API do Zabbix, que é baseado na interface Web. A API do Zabbix acessa o banco de dados e obtém os dados necessários para gráficos, relatórios, listas de eventos e problemas recentes.
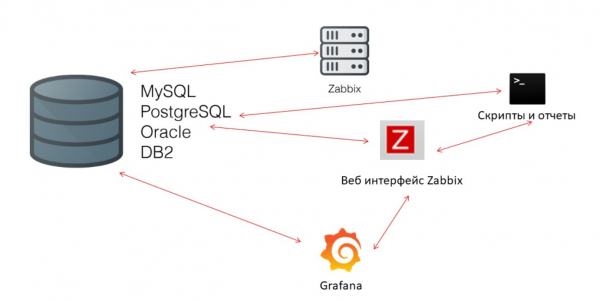
Para visualização — Grafana. Entre nossos usuários, essa é uma solução popular. Ela pode enviar requisições diretamente através da API do Zabbix tanto para o banco de dados, criando uma certa concorrência na obtenção de dados. Portanto, uma configuração mais refinada e boa do banco de dados é necessária para corresponder à rápida entrega de resultados e testes.
Housekeeper
A terceira chamada de performance no Zabbix é a limpeza do histórico através do Housekeeper. Ele respeita todas as configurações — nos elementos de dados, está indicado quanto tempo manter a dinâmica de mudanças (tendências) em dias.
O TrendsCache é calculado em tempo real. Quando os dados chegam, nós os agregamos em uma hora e os registramos em tabelas para a dinâmica de mudanças das tendências.
O Housekeeper é iniciado e remove informações do banco de dados com comandos "select" comuns. Isso nem sempre é eficiente, como pode ser visto nos gráficos de desempenho dos processos internos.
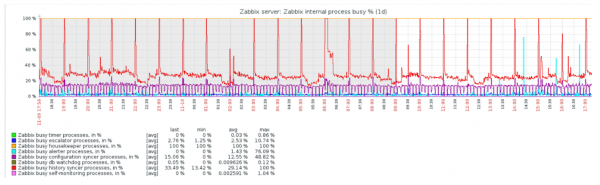
O gráfico vermelho mostra que o History syncer está constantemente ocupado. O gráfico laranja acima é o Housekeeper, que está sempre sendo iniciado. Ele aguarda o banco de dados remover todas as linhas que ele designou.
Quando é apropriado desabilitar o Housekeeper? Por exemplo, se há um "Item ID" e é necessário remover as últimas 5.000 linhas dentro de um determinado período. Claro, isso ocorre através de índices. Mas geralmente o dataset é muito grande, e o banco de dados ainda assim lê do disco e carrega no cache. Essa operação é sempre muito custosa para o banco de dados e, dependendo do tamanho da base, pode causar problemas de desempenho.
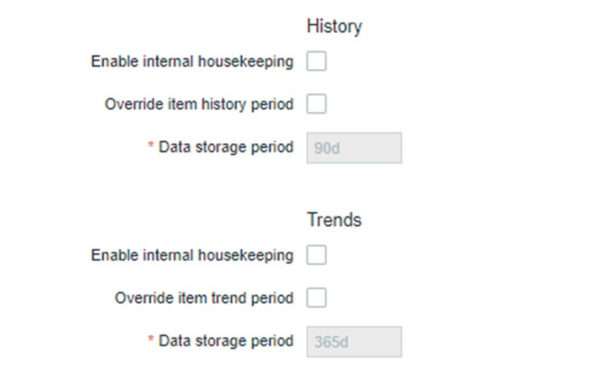
O Housekeeper pode ser simplesmente desabilitado. Na interface web, há uma configuração em "Administração geral" para o Housekeeper. Desabilitamos o gerenciamento interno do Housekeeping para o histórico interno de tendências e ele não gerencia mais isso.
Housekeeper desativado, os gráficos se estabilizaram — quais problemas podem surgir nesse caso e o que pode ajudar a resolver o terceiro chamado de desempenho?
Particionamento — particionamento ou seccionamento.
Geralmente, o particionamento é configurado de maneiras diferentes em cada banco de dados relacional que mencionei. Cada um possui sua própria tecnologia, mas são semelhantes, de modo geral. A criação de uma nova partição frequentemente leva a certos problemas.
Geralmente, as partições são configuradas de acordo com o "setup" — a quantidade de dados gerados em um único dia. Normalmente, o Particionamento é estabelecido para um dia, esse é o mínimo. Para tendências, uma nova partição é feita por 1 mês.
Os valores podem mudar em caso de um "setup" muito grande. Se o "setup" for pequeno — até 5.000 nvps (novos valores por segundo), médio — de 5.000 a 25.000, e grande — acima de 25.000 nvps. Essas são instalações grandes e muito grandes que exigem um ajuste cuidadoso do banco de dados.
Em instalações muito grandes, um segmento de um dia pode não ser ideal. Eu vi partições no MySQL de 40 GB ou mais por dia. Esse é um volume muito grande de dados que pode levar a problemas, e precisa ser reduzido.
O que o Particionamento proporciona?
Particionamento de tabelas. Muitas vezes, estes são arquivos separados no disco. O plano de consultas escolhe uma partição de forma mais otimizada. Normalmente, a partição é utilizada por intervalo — isso também é verdadeiro para o Zabbix. Nós usamos lá um "timestamp" — o tempo desde o início da era. Para nós, são números comuns. Você define o início e o fim do dia — esta é a partição.
Remoção rápida — DELETE. Um arquivo/subtabela é selecionado, em vez de uma amostra de linhas para exclusão.
Acelera significativamente a seleção de dados SELECT — usa uma ou mais partições, em vez de toda a tabela. Se você solicitar dados de dois dias atrás, eles são recuperados do banco de dados mais rapidamente, pois é necessário carregar no cache e fornecer apenas um arquivo, em vez de uma tabela grande.
Frequentemente, muitos bancos de dados também aceleram INSERT — inserções na tabela filha.
TimescaleDB
Para a versão 4.2, observamos o TimescaleDB. Esta é uma extensão para PostgreSQL com uma interface nativa. A extensão funciona eficientemente com dados de séries temporais, mantendo as vantagens dos bancos de dados relacionais. O TimescaleDB também realiza partições automaticamente.
No TimescaleDB existe o conceito de hipertabela (hypertable), que você cria. Nela estão chunks — partições. Os chunks são fragmentos gerenciados automaticamente da hipertabela, que não afetam outros fragmentos. Cada chunk possui seu próprio intervalo de tempo.
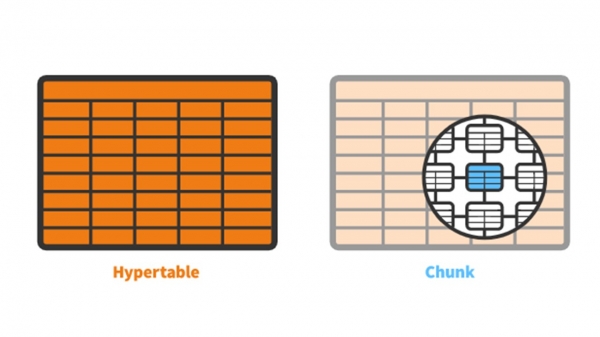
TimescaleDB vs PostgreSQL
O TimescaleDB funciona realmente de forma eficiente. Os criadores da extensão afirmam que utilizam um algoritmo de processamento de consultas mais adequado, em particular, inserts. À medida que os tamanhos das inserções de conjunto de dados aumentam, o algoritmo mantém desempenho constante.
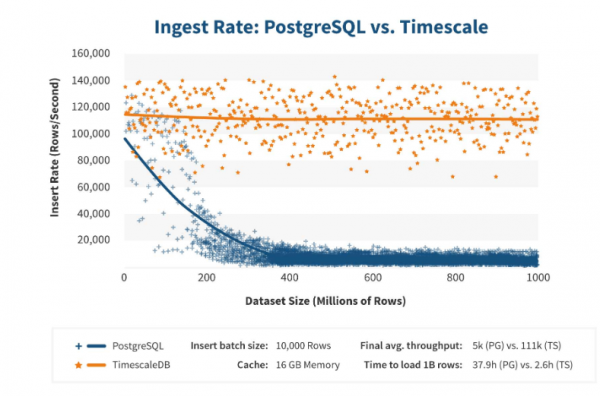
Após 200 milhões de linhas, o PostgreSQL geralmente começa a ter uma queda significativa e perde desempenho até 0. O TimescaleDB permite inserir "inserts" de forma eficiente com qualquer volume de dados.
Instalação
A instalação do TimescaleDB é bastante simples para quaisquer pacotes. No está tudo detalhadamente descrito — ele depende dos pacotes oficiais do PostgreSQL. O TimescaleDB também pode ser construído e compilado manualmente.
Para o banco de dados Zabbix, ativamos simplesmente a extensão:
echo "CREATE EXTENSION IF NOT EXISTS timescaledb CASCADE;" | sudo -u postgres psql zabbix Você ativa a extensão e a cria para o banco de dados Zabbix. O último passo é a criação da hipertabela.
Migração de tabelas de histórico para o TimescaleDB
Para isso existe uma função especial create_hypertable:
SELECIONE create_hypertable('history', 'clock', chunk_time_interval => 86400, migrate_data => true);
SELECIONE create_hypertable('history_unit', 'clock', chunk_time_interval => 86400, migrate_data => true);
SELECIONE create_hypertable('history_log', 'clock', chunk_time_interval => 86400, migrate_data => true);
SELECIONE create_hypertable('history_text', 'clock', chunk_time_interval => 86400, migrate_data => true);
SELECIONE create_hypertable('history_str', 'clock', chunk_time_interval => 86400, migrate_data => true);
SELECIONE create_hypertable('trends', 'clock', chunk_time_interval => 86400, migrate_data => true);
SELECIONE create_hypertable('trends_unit', 'clock', chunk_time_interval => 86400, migrate_data => true);
ATUALIZE config SET db_extension='timescaledb', hk_history_global=1, hk_trends_global=1
A função tem três parâmetros. O primeiro — a tabela no banco de dados, para a qual precisa ser criada uma hipertabela. O segundo — campo, pelo qual deve ser criado chunk_time_interval — o intervalo dos chunks das partições a serem usadas. No meu caso, o intervalo é de um dia — 86.400.
O terceiro parâmetro — migrar_dados. Se definido como verdadeiro, todos os dados atuais são transferidos para os chunks previamente criados. Eu mesmo usei migrar_dados. Eu tinha cerca de 1 TB, o que levou mais de uma hora. Mesmo em alguns casos durante os testes, eu removi dados históricos desnecessários de tipos de caracteres para não transferi-los.
O último passo — ATUALIZAÇÃO: em db_extension definimos como timescaledb, para que o banco de dados entenda que existe essa extensão. O Zabbix a ativa e usa corretamente a sintaxe e as consultas já para o banco de dados — aquelas funcionalidades necessárias para o TimescaleDB.
Configuração do hardware
Eu usei dois servidores. O primeiro — uma máquina VMware. Ela é bastante pequena: 20 processadores Intel® Xeon® CPU E5-2630 v4 @ 2.20GHz, 16 GB de RAM e um disco SSD de 200 GB.
Instalei o PostgreSQL 10.8 com o Debian 10.8-1.pgdg90+1 e sistema de arquivos xfs. Configurei o mínimo necessário para usar precisamente esse banco de dados, exceto pelo que será usado pelo próprio Zabbix.
Nessa mesma máquina, estava o servidor Zabbix, o PostgreSQL e agentes de carga. Eu tinha 50 agentes ativos que usavam LoadableModule, para gerar resultados variados rapidamente: números, strings. Eu alimentava o banco de dados com uma grande quantidade de dados.
Inicialmente, a configuração continha 5.000 itens de dados por host. Quase cada item continha um gatilho, para parecer com instalações reais. Em alguns casos, havia mais de um gatilho. Para um nó de rede, havia 3.000-7.000 gatilhos.
O intervalo de atualização dos itens de dados — 4-7 segundosEu regulei a carga usando não apenas 50 agentes, mas também adicionei mais. Além disso, usei elementos de dados dinâmicos para ajustar a carga e reduzi o intervalo de atualização para 4 segundos.
PostgreSQL. 35.000 nvps
A primeira execução nesse hardware foi com PostgreSQL puro — 35 mil valores por segundo. Como pode ser visto, a inserção de dados leva frações de segundo — tudo está bom e rápido. A única coisa é que o disco SSD de 200 GB enche rapidamente.
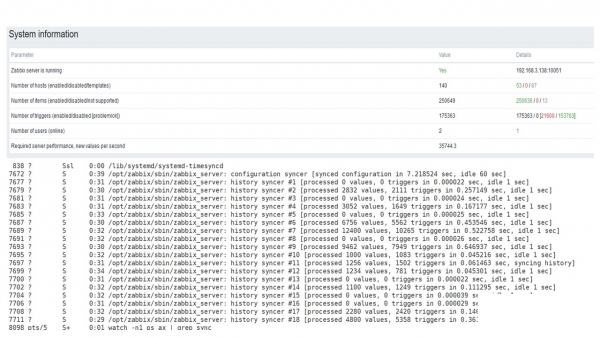
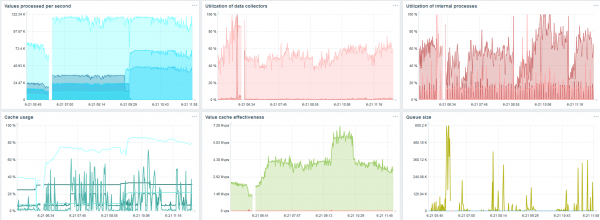
Este é o dashboard padrão de desempenho do Zabbix — servidores.
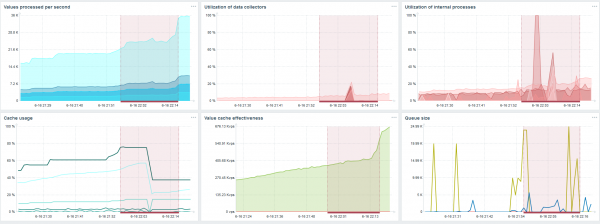
O primeiro gráfico azul mostra a quantidade de valores por segundo. O segundo gráfico à direita mostra a carga dos processos de coleta. O terceiro — a carga dos processos internos de coleta: history syncers e o Housekeeper, que estava sendo executado aqui por um tempo considerável.
O quarto gráfico mostra o uso do HistoryCache. Isso é um tipo de buffer antes da inserção no banco de dados. O quinto gráfico verde mostra a utilização do ValueCache, ou seja, quantos hits houve no ValueCache para gatilhos — isso chega a milhares de valores por segundo.
PostgreSQL. 50.000 nvps
Depois, aumentei a carga para 50 mil valores por segundo nesse mesmo hardware.
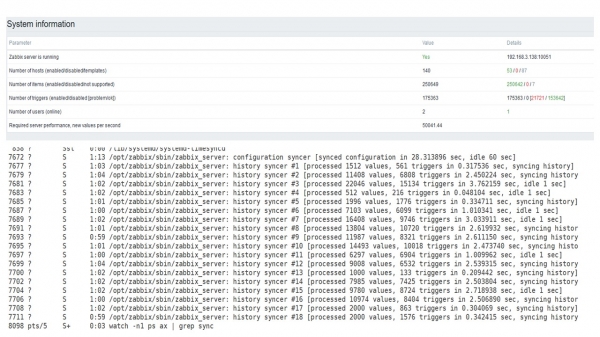
Ao carregar com o Housekeeper, a inserção de 10 mil valores levou de 2 a 3 segundos.
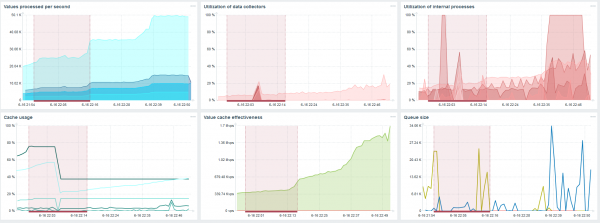
O Housekeeper já começa a interferir no trabalho.
Pelo terceiro gráfico, pode-se ver que, de forma geral, a carga dos trapper e history syncers ainda está em 60%. No quarto gráfico, o HistoryCache, durante a execução do Housekeeper, já começa a se preencher bastante. Ele se encheu em 20% — isso é cerca de 0,5 GB.
PostgreSQL. 80.000 nvps
Depois, aumentei a carga para 80 mil valores por segundo. Isso equivale a cerca de 400 mil elementos de dados e 280 mil gatilhos.
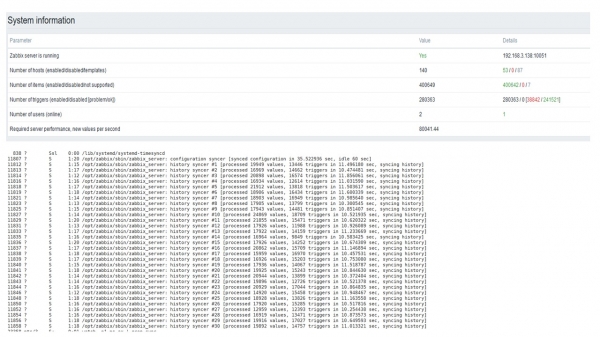
A inserção com uma carga de trinta history syncers já é bastante alta.
Também aumentei vários parâmetros: history syncers, caches.
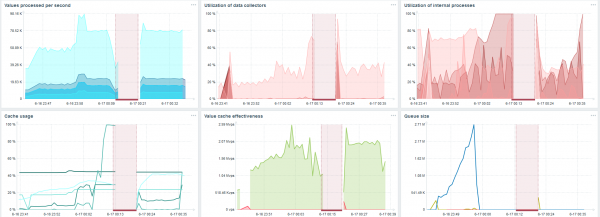
No meu hardware, a carga dos history syncers aumentou ao máximo. O HistoryCache se preencheu rapidamente com dados — havia dados acumulados no buffer para processamento.
Durante todo esse tempo, observei como a CPU, a memória RAM e outros parâmetros do sistema estavam sendo utilizados, e percebi que a utilização dos discos estava no máximo.
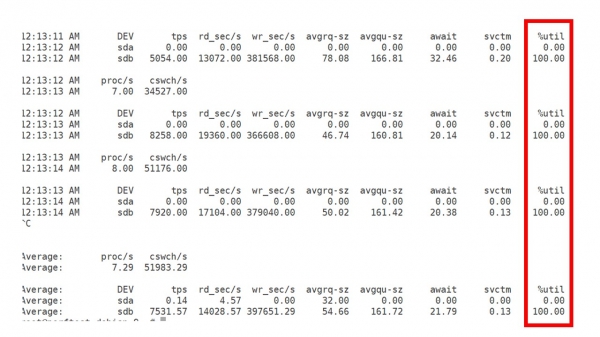
Consegui utilizar a capacidade máxima do disco neste hardware e nesta máquina virtual. Com essa intensidade, o PostgreSQL começou a descartar dados com bastante frequência, e o disco já não conseguia acompanhar a leitura e gravação.
Servidor dois
Eu peguei outro servidor, que já tinha 48 processadores e 128 GB de memória RAM. O otimizei – instalei 60 history syncer e cheguei a um desempenho aceitável.
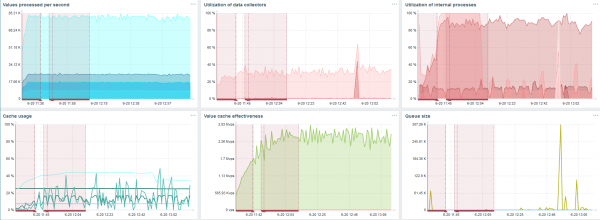
De fato, isso já é o limite de desempenho, onde é necessário fazer algo.
TimescaleDB. 80.000 nvps
Meu principal objetivo é verificar as capacidades do TimescaleDB sob a carga do Zabbix. 80 mil valores por segundo é muito, com uma frequência de coleta de métricas (exceto para o Yandex, claro) e um 'setup' bastante grande.
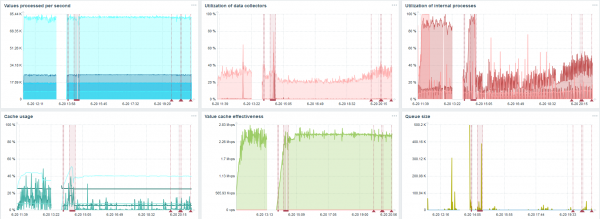
Em cada gráfico há um pico — isso é exatamente a migração de dados. Depois dos picos no servidor Zabbix, o perfil de carga do history syncer mudou consideravelmente — caiu três vezes.
TimescaleDB permite inserir dados quase 3 vezes mais rápido e usar menos HistoryCache.
Portanto, você receberá os dados em tempo hábil.
TimescaleDB. 120.000 nvps
Depois, aumentei o número de elementos de dados para 500 mil. O principal objetivo era verificar as capacidades do TimescaleDB — recebi um valor calculado de 125 mil valores por segundo.
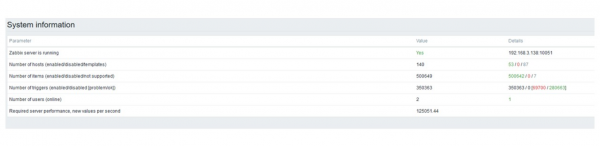
Este é um 'setup' funcional, que pode operar por um longo tempo. Mas como meu disco era de apenas 1,5 TB, eu o enchi em poucos dias.
O mais importante é que, ao mesmo tempo, novas partições do TimescaleDB estavam sendo criadas.
Para o desempenho, isso é completamente imperceptível. Quando partições são criadas no MySQL, por exemplo, tudo é diferente. Normalmente, isso acontece à noite, pois bloqueia a inserção geral, o trabalho com tabelas e pode criar degradação no serviço. No caso do TimescaleDB, isso não acontece.
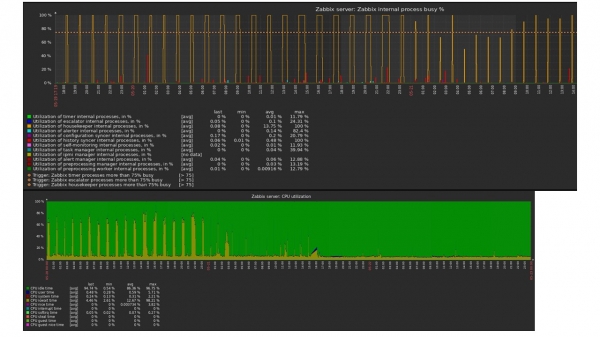
Para exemplificar, mostrarei um gráfico de muitos na comunidade. Na imagem, o TimescaleDB está ativado, e graças a isso a carga no uso de io.weight no processador diminuiu. O uso dos elementos dos processos internos também foi reduzido. E isso é uma máquina virtual comum em discos comuns, e não em SSDs.
Como resultado, obtemos um serviço de "monitoramento como serviço", automatizado na linha de produção de integração contínua. O desenvolvedor ou testador precisa apenas definir a lista de métricas em um arquivo JSON, e tudo o mais acontece automaticamente. Obtemos um controle de qualidade transparente dos lançamentos: todas as notificações sobre desempenho, consumo de recursos ou regressões arquitetônicas.
TimescaleDB é uma boa solução para 'setups' pequenos, que esbarram na performance do disco. Ela permitirá continuar funcionando bem até a migração do banco de dados para hardware mais rápido.
TimescaleDB é fácil de configurar, oferece aumento de desempenho, funciona bem com Zabbix e tem vantagens em relação ao PostgreSQL.
Se você está utilizando o PostgreSQL e não planeja mudá-lo, recomendo usar o PostgreSQL com a extensão TimescaleDB em conjunto com o Zabbix. Essa solução funciona de forma eficiente para 'setups' medianos.
Quando dizemos 'alto desempenho' — nos referimos a . Não vai demorar muito para conhecer as tecnologias e práticas que permitem que os serviços atendam milhões de usuários. Lista para os dias 7 e 8 de novembro já está pronta, mas podem ser sugeridos ainda.
Siga a nossa e , em que revelamos dicas da próxima conferência e descubra como aproveitar ao máximo.
Fonte: habr.com
