

VictoriaMetrics, TimescaleDB e InfluxDB foram comparados em um conjunto de dados com um bilhão de pontos de dados pertencentes a 40 mil séries temporais únicas.
Há alguns anos, havia a era do Zabbix. Cada servidor bare metal tinha no máximo alguns indicadores – uso de CPU, uso de memória, uso de disco e uso de rede. Assim, as métricas de milhares de servidores poderiam se encaixar em 40 mil séries temporais únicas, e o Zabbix poderia usar o MySQL como backend para esses dados de séries temporais 🙂
Atualmente, um com configurações padrão fornece mais de 500 métricas por host médio. Existem muitos para diferentes bancos de dados, servidores web, sistemas de hardware, etc. Todos eles fornecem uma série de métricas úteis. Todos começam a expor diferentes métricas sobre si mesmas. Existe o Kubernetes com clusters e pods, revelando inúmeras métricas. Isso faz com que os servidores exponham milhares de métricas únicas por host. Assim, uma série temporal única de 40K não é mais um grande feito. Tornou-se uma norma que deve ser facilmente processada por qualquer TSDB moderna em um servidor.
Qual é a quantidade de séries temporais únicas nesse momento? Provavelmente, 400K ou 4M? Ou 40M? Vamos comparar TSDBs modernas com esses números.
Configuração de benchmark
é uma excelente ferramenta de benchmark para TSDBs. Ela permite gerar um número arbitrário de métricas, passando o número necessário de séries temporais, dividido por 10 – flag (anteriormente -scale-var). 10 é o número de medições (métricas) geradas em cada host, servidor. Os seguintes conjuntos de dados foram criados com o TSBS para o benchmark:
- 400K série temporal única, intervalo de 60 segundos entre pontos de dados, dados cobrem um total de 3 dias, ~1.7B total de pontos de dados.
- 4M série temporal única, intervalo de 600 segundos, dados cobrem um total de 3 dias, ~1.7B total de pontos de dados.
- 40M série temporal única, intervalo de 1 hora, dados cobrem um total de 3 dias, ~2.8B total de pontos de dados.
O cliente e o servidor foram executados em instâncias dedicadas na nuvem do Google. Essas instâncias tinham as seguintes configurações:
- vCPUs: 16
- RAM: 60 GB
- Armazenamento: disco rígido padrão de 1 TB. Ele fornece uma taxa de transferência de leitura/gravação de 120 Mbps, 750 operações de leitura por segundo e 1,5K operações de gravação por segundo.
Os TSDBs foram extraídos das imagens oficiais do Docker e executados no Docker com as seguintes configurações:
VictoriaMetrics:
docker run -it --rm -v /mnt/disks/storage/vmetrics-data:/victoria-metrics-data -p 8080:8080 valyala/victoria-metricsOs valores do InfluxDB (- e são necessários para suportar alta capacidade. Detalhes em ):
docker run -it --rm -p 8086:8086
-e INFLUXDB_DATA_MAX_VALUES_PER_TAG=4000000
-e INFLUXDB_DATA_CACHE_MAX_MEMORY_SIZE=100g
-e INFLUXDB_DATA_MAX_SERIES_PER_DATABASE=0
-v /mnt/disks/storage/influx-data:/var/lib/influxdb influxdb
TimescaleDB (a configuração foi extraída do arquivo):
MEM=`free -m | grep "Mem" | awk ‘{print $7}’`
let "SHARED=$MEM/4"
let "CACHE=2*$MEM/3"
let "WORK=($MEM-$SHARED)/30"
let "MAINT=$MEM/16"
let "WAL=$MEM/16"
docker run -it --rm -p 5432:5432
--shm-size=${SHARED}MB
-v /mnt/disks/storage/timescaledb-data:/var/lib/postgresql/data
timescale/timescaledb:latest-pg10 postgres
-cmax_wal_size=${WAL}MB
-clog_line_prefix="%m [%p]: [%x] %u@%d"
-clogging_collector=off
-csynchronous_commit=off
-cshared_buffers=${SHARED}MB
-ceffective_cache_size=${CACHE}MB
-cwork_mem=${WORK}MB
-cmaintenance_work_mem=${MAINT}MB
-cmax_files_per_process=100
O carregador de dados foi executado com 16 threads paralelas.
Este artigo contém apenas resultados para os indicadores de inserção. Resultados de benchmark amostral serão publicados em um artigo separado.
400K séries temporais únicas
Vamos começar com elementos simples — 400K. Resultados do benchmark:
- VictoriaMetrics: 2,6M pontos de dados por segundo; uso de memória: 3 GB; tamanho final dos dados no disco: 965 MB
- InfluxDB: 1.2M pontos de dados por segundo; uso de memória: 8.5 GB; tamanho final dos dados no disco: 1.6 GB
- Timescale: 849K pontos de dados por segundo; uso de memória: 2,5 GB; tamanho final dos dados no disco: 50 GB
Como você pode ver pelos resultados acima, VictoriaMetrics vence em desempenho de inserção e taxa de compressão. Timescale vence em uso de memória, mas consome muito espaço em disco — 29 bytes por ponto de dados.
Abaixo estão gráficos de uso da CPU para cada um dos TSDBs durante o benchmark:
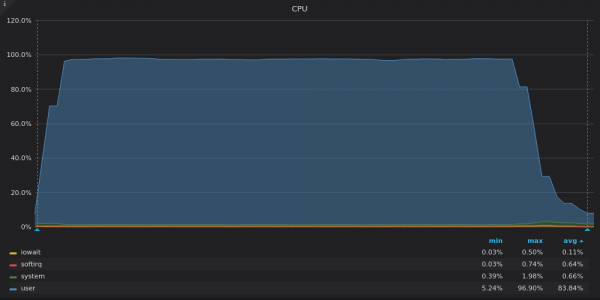
Acima, captura de tela: VictoriaMetrics — Uso da CPU durante o teste de inserção para uma métrica única de 400K.
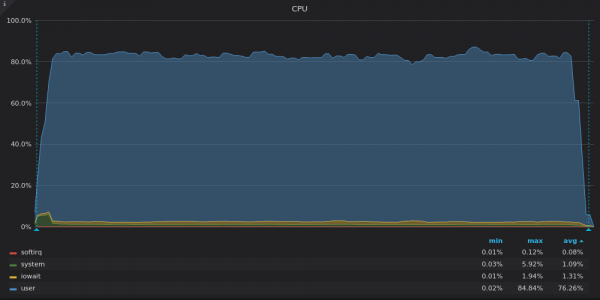
Acima, captura de tela: InfluxDB — Uso da CPU durante o teste de inserção para uma métrica única de 400K.
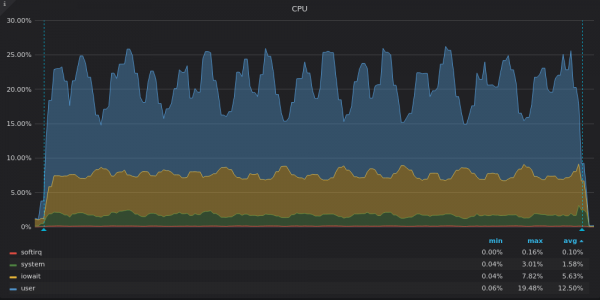
Acima, captura de tela: TimescaleDB — Uso da CPU durante o teste de inserção para uma métrica única de 400K.
VictoriaMetrics utiliza todos os vCPUs disponíveis, enquanto InfluxDB utiliza apenas cerca de 2 de 16 vCPUs.
Timescale utiliza apenas 3-4 de 16 vCPUs. Altas porcentagens de iowait e system no gráfico do TimescaleDB indicam um gargalo na subsistema de entrada/saída (I/O). Vamos dar uma olhada nos gráficos de uso de largura de banda do disco:
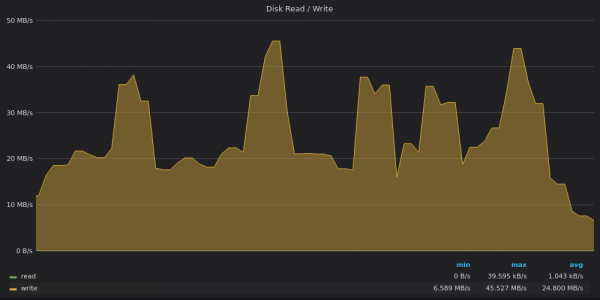
Acima, captura de tela: VictoriaMetrics — Uso de largura de banda do disco durante o teste de inserção para métricas únicas de 400K.
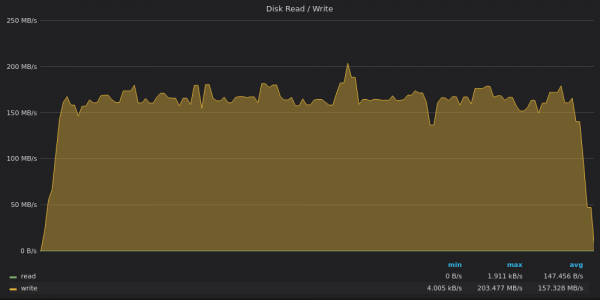
Acima, captura de tela: InfluxDB — Uso de largura de banda do disco durante o teste de inserção para métricas únicas de 400K.
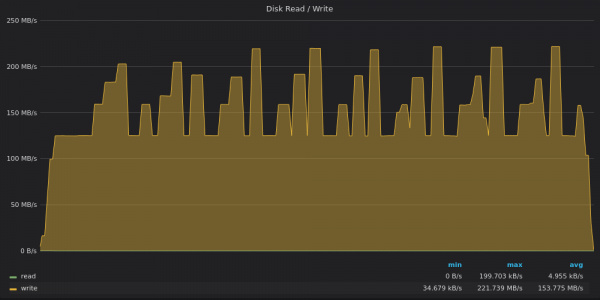
Acima, captura de tela: TimescaleDB — Uso de largura de banda do disco durante o teste de inserção para métricas únicas de 400K.
VictoriaMetrics grava dados a uma taxa de 20 Mb/s, com picos de até 45 Mb/s. Os picos correspondem a grandes mesclagens parciais na árvore. .
InfluxDB grava dados a uma taxa de 160 MB/s, enquanto o disco de 1 TB a uma largura de banda de gravação de 120 MB/s.
TimescaleDB é limitada a uma largura de banda de gravação de 120 Mb/s, mas às vezes ultrapassa esse limite, alcançando 220 Mb/s em picos. Esses picos correspondem a falhas devido à carga insuficiente do processador no gráfico anterior.
Vamos dar uma olhada nos gráficos de uso de entrada/saída (I/O):
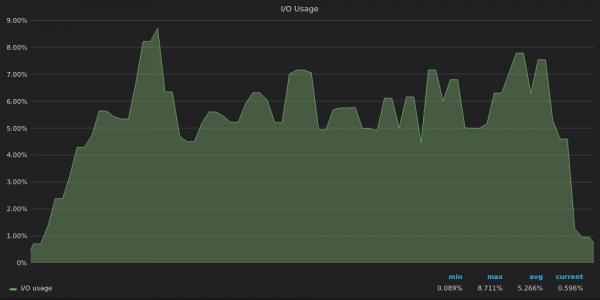
Acima, captura de tela: VictoriaMetrics — Uso de entrada/saída durante o teste de inserção para 400K métricas únicas.
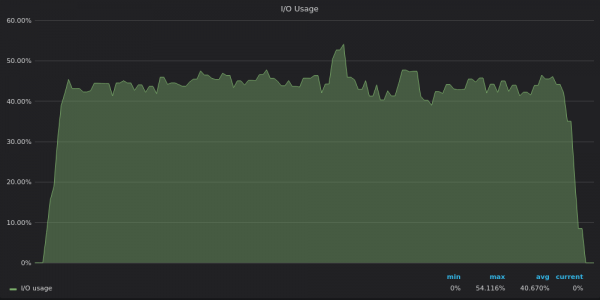
Acima, captura de tela: InfluxDB — Uso de entrada/saída durante o teste de inserção para 400K métricas únicas.
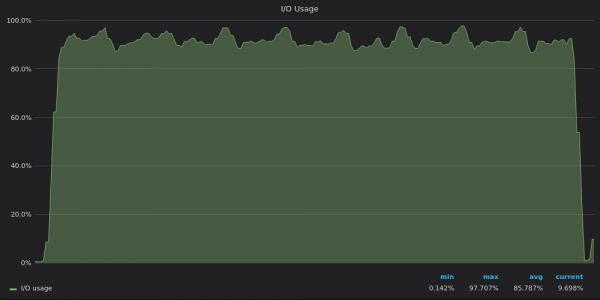
Acima, captura de tela: TimescaleDB — Uso de entrada/saída durante o teste de inserção para 400K métricas únicas.
Agora está claro que o TimescaleDB atinge o limite de entrada/saída, portanto não pode utilizar os 12 vCPUs restantes.
4M séries temporais únicas
4M séries temporais parecem um pouco desafiadoras. Mas nossos concorrentes passam por esse exame com sucesso. Resultados do benchmark:
- VictoriaMetrics: 2,2M pontos de dados por segundo; uso de memória: 6 GB; tamanho final dos dados no disco: 3 GB.
- InfluxDB: 330K pontos de dados por segundo; uso de memória: 20,5 GB; tamanho final dos dados no disco: 18,4 GB.
- TimescaleDB: 480K pontos de dados por segundo; uso de memória: 2,5 GB; tamanho final dos dados no disco: 52 GB.
O desempenho do InfluxDB caiu de 1,2 milhão de pontos de dados por segundo para 400 mil séries temporais para 330 mil pontos de dados por segundo para 4 milhões de séries temporais. Essa é uma perda significativa de desempenho em comparação com outros concorrentes. Vamos analisar os gráficos de uso de CPU para entender a causa raiz dessa perda:
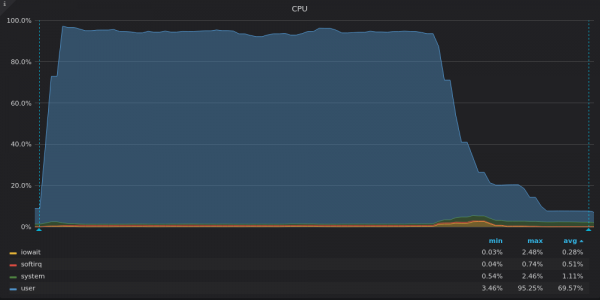
Acima está a captura de tela: VictoriaMetrics — Uso de CPU durante o teste de inserção para uma série temporal única de 4 milhões.
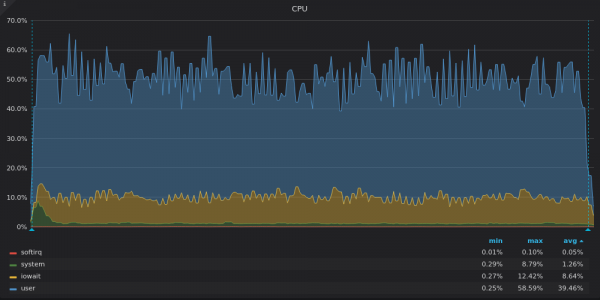
Acima está a captura de tela: InfluxDB — Uso de CPU durante o teste de inserção para uma série temporal única de 4 milhões.
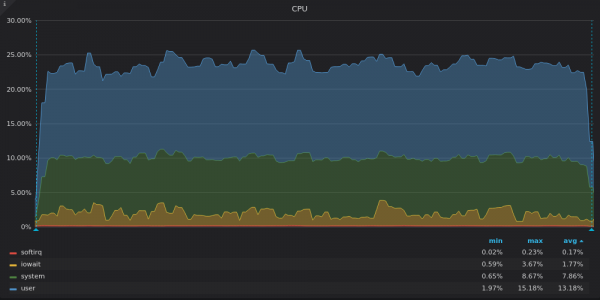
Acima está a captura de tela: TimescaleDB — Uso de CPU durante o teste de inserção para uma série temporal única de 4 milhões.
VictoriaMetrics utiliza quase toda a potência da CPU. A queda no final corresponde às fusões restantes do LSM após a inserção de todos os dados.
InfluxDB utiliza apenas 8 dos 16 vCPUs, enquanto o TimescaleDB utiliza 4 dos 16 vCPUs. O que há em comum em seus gráficos? Uma alta porcentagem de iowait, que novamente indica um gargalo de entrada e saída.
TimescaleDB possui uma alta porcentagem de system. Acreditamos que a alta carga levou a muitas chamadas de sistema ou a muitos .
Vamos dar uma olhada nos gráficos de largura de banda do disco:
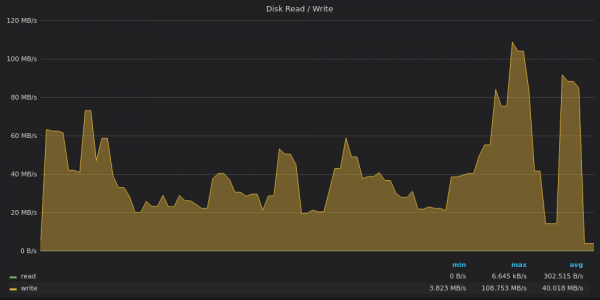
Acima está a captura de tela: VictoriaMetrics — Uso da largura de banda do disco para inserção de 4 milhões de métricas únicas.
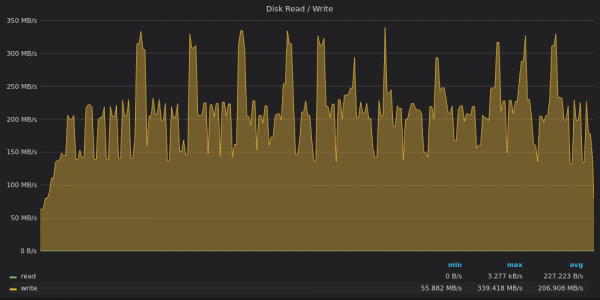
Acima está a captura de tela: InfluxDB — Uso da largura de banda do disco para inserção de 4 milhões de métricas únicas.
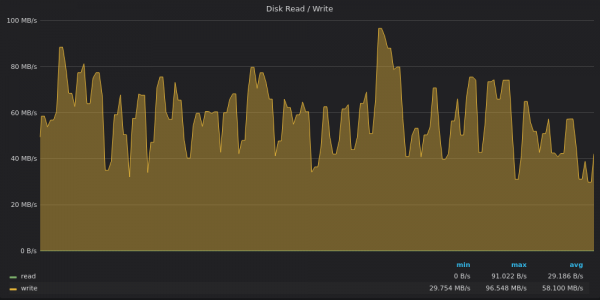
Acima está a captura de tela: TimescaleDB — Uso da largura de banda do disco para inserção de 4 milhões de métricas únicas.
VictoriaMetrics alcançou um limite de 120 MB/s em pico, enquanto a velocidade média de gravação foi de 40 MB/s. Provavelmente, durante o pico, várias fusões pesadas do LSM foram realizadas.
InfluxDB novamente extrai uma largura de banda média de gravação de 200 MB/s com picos de até 340 MB/s em um disco com limite de gravação de 120 MB/s 🙂
TimescaleDB não está mais limitado pelo disco. Parece que está limitado por algo mais relacionado à alta porcentagem de carga do CPU.
Vamos dar uma olhada nos gráficos de uso de IO:
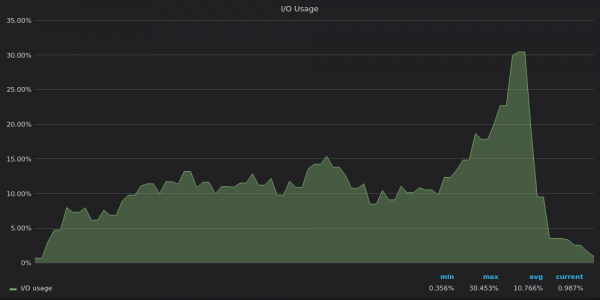
Acima está a captura de tela: VictoriaMetrics — Uso de entrada e saída durante o teste de inserção para uma série temporal única de 4 milhões.
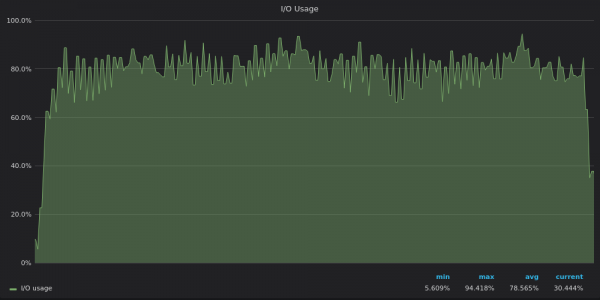
Acima está a captura de tela: InfluxDB — Uso de entrada e saída durante o teste de inserção para uma série temporal única de 4 milhões.
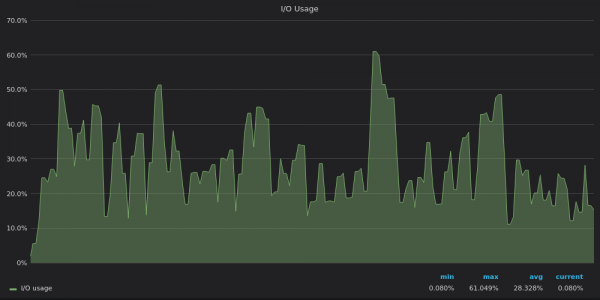
Acima está a captura de tela: TimescaleDB — Uso de entrada e saída durante o teste de inserção para uma série temporal única de 4 milhões.
Os gráficos de uso de IO replicam os gráficos de uso da largura de banda do disco — o InfluxDB tem IO limitado, enquanto o VictoriaMetrics e o TimescaleDB têm recursos de entrada e saída disponíveis.
40M séries temporais exclusivas
40M séries temporais exclusivas eram grandes demais para o InfluxDB 🙁
Resultados do benchmark:
- VictoriaMetrics: 1,7M pontos de dados por segundo; uso de memória: 29 GB; uso de espaço em disco: 17 GB.
- InfluxDB: não terminou, pois era necessário mais de 60 GB de memória.
- TimescaleDB: 330K pontos de dados por segundo, uso de memória: 2,5 GB; uso de espaço em disco: 84GB.
O TimescaleDB apresenta um uso de memória excepcionalmente baixo e estável – 2,5 GB — o mesmo que para as métricas exclusivas de 4M e 400K.
O VictoriaMetrics aumentou lentamente a uma taxa de 100 mil pontos de dados por segundo, até que todos os 40M nomes de métricas com rótulos foram processados. Então, ele alcançou uma taxa de inserção estável de 1,5 a 2,0M pontos de dados por segundo, resultando em uma taxa final de 1,7M pontos de dados por segundo.
Os gráficos para 40M séries temporais exclusivas são semelhantes aos gráficos para 4M séries temporais exclusivas, portanto, vamos pular esses.
Como resultado, obtemos um serviço de "monitoramento como serviço", automatizado na linha de produção de integração contínua. O desenvolvedor ou testador precisa apenas definir a lista de métricas em um arquivo JSON, e tudo o mais acontece automaticamente. Obtemos um controle de qualidade transparente dos lançamentos: todas as notificações sobre desempenho, consumo de recursos ou regressões arquitetônicas.
- Os bancos de dados de séries temporais modernos são capazes de processar inserções para milhões de séries temporais exclusivas em um único servidor. No próximo artigo, vamos verificar quão bem os TSDBs realizam consultas em milhões de séries temporais exclusivas.
- Carga de CPU insuficiente geralmente indica um gargalo de entrada e saída. Além disso, isso pode indicar um bloqueio muito grosseiro, onde apenas algumas threads podem ser executadas simultaneamente.
- Gargalos de entrada e saída realmente existem, especialmente em armazenamentos sem SSD, como dispositivos de bloco virtualizados de provedores de nuvem.
- O VictoriaMetrics oferece a melhor otimização para armazenamentos lentos com baixa entrada e saída. Ele proporciona a melhor velocidade e a melhor taxa de compressão.
Baixe e experimente com seus dados. O arquivo binário estático apropriado está disponível em .
Leia mais sobre o VictoriaMetrics neste .
Atualização: publicado com resultados reproduzíveis.
Atualização #2: Leia também .
Atualização #3: !
Chat do Telegram:
Fonte: habr.com
