

Olá, eu crio aplicações para SGBD — é uma plataforma desenvolvida pelo Mail.ru Group, que combina um SGBD de alto desempenho com um servidor de aplicações em Lua. A alta velocidade das soluções baseadas em Tarantool é alcançada, entre outras coisas, pelo suporte ao modo in-memory do SGBD e pela possibilidade de executar a lógica de negócio da aplicação no mesmo espaço de endereço que os dados. Isso garante persistência de dados usando transações ACID (um log WAL é mantido em disco). O Tarantool possui suporte embutido à replicação e sharding. A partir da versão 2.1, são suportadas consultas na linguagem SQL. O Tarantool possui código aberto e é distribuído sob a licença Simplified BSD. Também existe uma versão Enterprise comercial.
Sinta o poder! (…ou seja, aproveite o desempenho)
Tudo isso torna o Tarantool uma plataforma atraente para criar aplicações de alta carga que trabalham com bancos de dados. Nesses aplicativos, frequentemente surge a necessidade de replicação de dados.
Como mencionado acima, o Tarantool possui replicação de dados embutida. O princípio de seu funcionamento implica na execução sequencial em réplicas de todas as transações contidas no log do mestre (WAL). Normalmente, essa replicação (que chamaremos a partir daqui de baixo nível) é usada para garantir a resiliência da aplicação e/ou para distribuir a carga de leitura entre os nós do cluster.
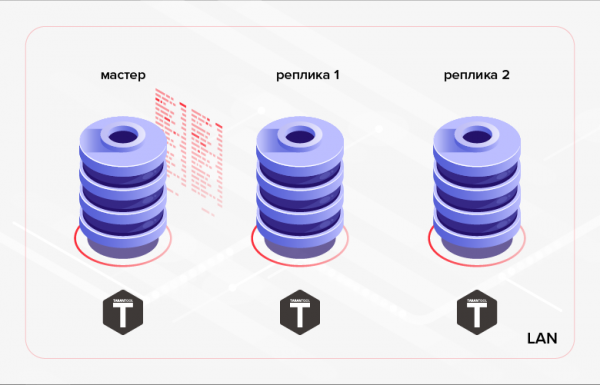
Fig. 1. Replicação dentro do cluster
Um exemplo de cenário alternativo pode ser a transferência de dados criados em um banco de dados para outro banco de dados para processamento/monitoramento. Neste último caso, uma solução mais conveniente pode ser o uso de replicação de alto nível — replicação de dados no nível da lógica de negócio da aplicação. Ou seja, não utilizamos uma solução pronta embutida no SGBD, mas implementamos a replicação dentro da aplicação que estamos desenvolvendo. Essa abordagem tem suas vantagens e desvantagens. Vamos listar os prós.
1. Economia de tráfego:
- é possível transmitir não todos os dados, mas apenas uma parte deles (por exemplo, podemos transmitir apenas algumas tabelas, algumas de suas colunas ou registros que atendam a um critério específico);
- Diferente da replicação de baixo nível, que é realizada continuamente em modo assíncrono (implementado na versão atual do Tarantool — 1.10) ou síncrono (será implementado em versões futuras do Tarantool), a replicação de alto nível pode ser executada em sessões (ou seja, o aplicativo sincroniza primeiro os dados — um sessão de troca de dados, então ocorre uma pausa na replicação, após a qual ocorre a próxima sessão de troca e assim por diante);
- se um registro foi modificado várias vezes, pode-se transmitir apenas sua última versão (diferente da replicação de baixo nível, onde todas as alterações feitas no mestre serão reproduzidas sequencialmente nas réplicas).
2. Não há complicações na implementação da troca via HTTP, o que permite sincronizar bancos de dados remotos.
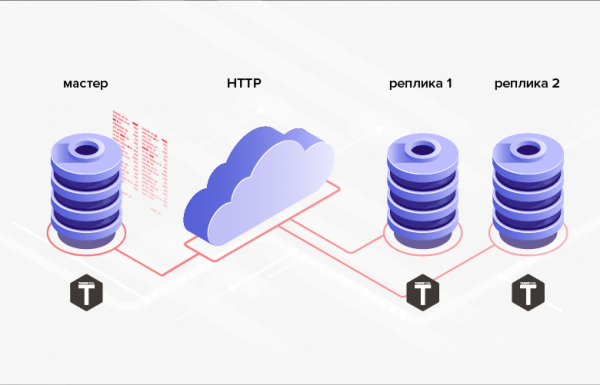
Fig. 2. Replicação via HTTP
3. As estruturas dos bancos de dados entre os quais os dados são transmitidos não precisam ser idênticas (mais ainda, em geral, é até possível usar diferentes SGBDs, linguagens de programação, plataformas, etc.).
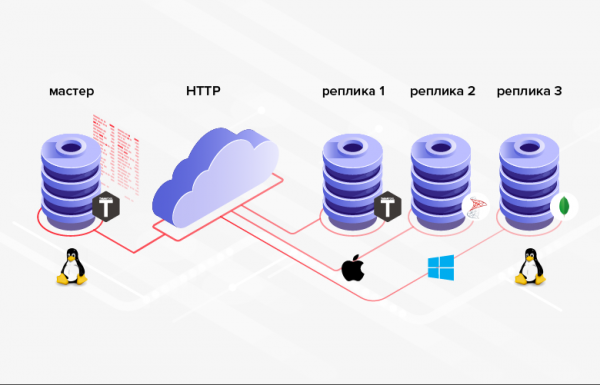
Fig. 3. Replicação em sistemas heterogêneos
Uma desvantagem é que, em média, a programação é mais complicada/custosa do que a configuração, e em vez de configurar a funcionalidade embutida, será necessário implementar a sua própria.
Se, na sua situação, as vantagens mencionadas forem decisivas (ou forem uma condição necessária), faz sentido utilizar a replicação de alto nível. Vamos considerar algumas maneiras de implementar a replicação de alto nível de dados no SGBD Tarantool.
Minimização do tráfego
Assim, uma das vantagens da replicação de alto nível é a economia de tráfego. Para que essa vantagem se manifeste plenamente, é necessário minimizar a quantidade de dados transferidos em cada sessão de troca. Claro, ao fazer isso, deve-se lembrar que, ao final da sessão, o receptor dos dados deve estar sincronizado com a fonte (pelo menos na parte dos dados que participa da replicação).
Como minimizar a quantidade de dados transmitidos durante a replicação de alto nível? Uma solução 'direta' pode ser a seleção de dados por data-hora. Para isso, pode-se utilizar o campo de data-hora já existente na tabela (se houver). Por exemplo, um documento de 'pedido' pode ter um campo 'tempo requerido para a execução do pedido' — tempo_de_entrega. O problema dessa abordagem é que os valores neste campo não precisam estar em uma sequência correspondente à criação dos pedidos. Assim, não podemos lembrar o valor máximo do campo tempo_de_entrega, transmitido na sessão de troca anterior, e na próxima sessão de troca selecionar todos os registros com um valor de campo maior tempo_de_entrega. Durante o intervalo entre as sessões de troca, podem ter sido adicionados registros com valores menores tempo_de_entrega. Além disso, o pedido pode ter passado por alterações que, no entanto, não afetaram o campo tempo_de_entrega. Em ambos os casos, as alterações não serão transmitidas da fonte para o receptor. Para resolver esses problemas, precisaremos transmitir os dados de forma "sobreposta". Ou seja, em cada sessão de troca, transmitiremos todos os dados com um valor de campo tempo_de_entrega, superior a um determinado momento no passado (por exemplo, N horas a partir do momento atual). No entanto, é evidente que, para sistemas grandes, essa abordagem é bastante redundante e pode anular a economia de tráfego que buscamos. Além disso, a tabela transmitida pode não conter um campo relacionado à data-hora.
Outra solução, mais complexa em termos de implementação, envolve a confirmação do recebimento dos dados. Nesse caso, em cada sessão de troca, todos os dados cujo recebimento não foi confirmado pelo receptor são transmitidos. Para implementar isso, será necessário adicionar uma coluna booleana na tabela de origem (por exemplo, is_transferred). Se o receptor confirma o recebimento do registro, o campo correspondente assume o valor verdadeiro, após o qual o registro não participa mais das trocas. Essa opção de implementação tem as seguintes desvantagens. Primeiro, para cada registro transmitido, é necessário gerar e enviar uma confirmação. Grosso modo, isso pode ser comparável a dobrar a quantidade de dados transmitidos e levar à duplicação do número de round trips. Em segundo lugar, não há como enviar o mesmo registro para vários receptores (o primeiro receptor que recebê-lo confirmará o recebimento por si e por todos os demais).
O método isento das desvantagens mencionadas anteriormente consiste em adicionar à tabela transmitida uma coluna para rastrear as alterações em suas linhas. Essa coluna pode ter o tipo data-hora e deve ser definida/atualizada pelo aplicativo para o tempo atual sempre que registros forem adicionados/alterados (de forma atômica com a adição/alteração). Como exemplo, chamaremos a coluna update_time. Ao manter o valor máximo do campo dessa coluna para os registros transmitidos, poderemos iniciar a próxima sessão de troca a partir desse valor (selecionar registros com um valor de campo update_time, superior ao valor previamente salvo). O problema associado à última abordagem é que as alterações nos dados podem ocorrer em lote. Como resultado, os valores dos campos na coluna update_time podem não ser únicos. Assim, essa coluna não pode ser utilizada para a emissão em lotes (paginação) de dados. Para a entrega de dados em páginas, será necessário inventar mecanismos adicionais, que provavelmente terão uma eficiência muito baixa (por exemplo, extrair do banco de dados todos os registros com um valor update_time acima do estipulado e devolver uma quantidade específica de registros, começando de algum deslocamento do início da seleção).
É possível aumentar a eficiência da transmissão de dados, aprimorando um pouco a abordagem anterior. Para isso, usaremos um tipo inteiro (inteiro longo) como valores dos campos da coluna de rastreamento de alterações. Chamaremos a coluna row_ver. O valor do campo dessa coluna ainda deve ser definido/atualizado sempre que um registro for criado/alterado. Mas, neste caso, o campo não receberá a data-hora atual, mas sim o valor de um contador, incrementado em um. Como resultado, a coluna row_ver terá valores únicos e poderá ser usada não apenas para emitir a "delta" dos dados (dados adicionados/modificados após a conclusão da sessão anterior de troca), mas também para uma simples e eficaz divisão em páginas.
O último método proposto para minimizar a quantidade de dados transmitidos no âmbito da replicação de alto nível me parece o mais otimizado e universal. Vamos nos deter mais sobre ele.
Transmissão de dados utilizando contador de versões de linhas
Implementação da parte do servidor/master
No MS SQL Server, para implementar uma abordagem semelhante, existe um tipo especial de coluna — rowversion. Cada banco de dados possui um contador que aumenta em um a cada vez que uma entrada na tabela, que contém uma coluna do tipo rowversion, é adicionada ou alterada. O valor desse contador é automaticamente atribuído ao campo dessa coluna na entrada adicionada ou alterada. O SGBD Tarantool não possui um mecanismo embutido análogo. No entanto, no Tarantool, isso pode ser facilmente implementado manualmente. Vamos ver como isso é feito.
Para começar, um pouco de terminologia: tabelas no Tarantool são chamadas de espaço (space), e entradas são chamadas de tuplas (tuple). No Tarantool, sequências (sequence) podem ser criadas. Sequências nada mais são do que geradores nomeados de valores inteiros ordenados. Ou seja, é exatamente o que precisamos para nossos objetivos. Abaixo, criaremos tal sequência.
Antes de executar qualquer operação com o banco de dados no Tarantool, é necessário executar o seguinte comando:
box.cfg{}Como resultado, o Tarantool começará a gravar no diretório atual capturas do banco de dados (snapshot) e o log das transações.
Vamos criar uma sequência row_version:
box.schema.sequence.create('row_version',
    { if_not_exists = true })
Opção if_not_exists permite executar o script de criação várias vezes: se o objeto existir, o Tarantool não tentará criá-lo novamente. Esta opção será usada em todos os próximos comandos DDL.
Vamos criar um espaço para exemplo.
box.schema.space.create('goods', {
    format = {
        {
            name = 'id',
            type = 'unsigned'

        },
        {
            name = 'name',
            type = 'string'

        },
        {
            name = 'code',
            type = 'unsigned'

        },
        {
            name = 'row_ver',
            type = 'unsigned'

        }
    },
    if_not_exists = true
})
Aqui definimos o nome do espaço (goods), os nomes dos campos e seus tipos.
Campos de auto-incremento no Tarantool também são criados através de sequências. Vamos criar uma chave primária de auto-incremento pelo campo id:
box.schema.sequence.create('goods_id',
    { if_not_exists = true })
box.space.goods:create_index('primary', {
    parts = { 'id' },
    sequence = 'goods_id',
    unique = true,
    type = 'HASH',
    if_not_exists = true
})
O Tarantool suporta vários tipos de índices. Os tipos mais comuns são os índices TREE e HASH, que têm suas respectivas estruturas subjacentes. TREE é o tipo de índice mais versátil. Ele permite extrair dados de forma ordenada. No entanto, para a seleção por igualdade, oHASH é mais apropriado. Assim, para a chave primária, é sensato usar o HASH (o que fizemos).
Para usar a coluna row_ver para transmitir dados alterados, é necessário vincular os campos dessa coluna aos valores da sequência row_ver. Mas, ao contrário da chave primária, o valor do campo da coluna row_ver deve aumentar em uma unidade não apenas ao adicionar novos registros, mas também ao modificar os existentes. Para isso, é possível usar gatilhos. No Tarantool, existem dois tipos de gatilhos para espaços: before_replace e on_replace. Os gatilhos são acionados em cada alteração de dados no espaço (para cada tupla afetada por alterações, uma função de gatilho é acionada). Ao contrário do on_replace, before_replace-os gatilhos permitem modificar os dados da tupla para a qual o gatilho é executado. Assim, o último tipo de gatilho nos atende.
box.space.goods:before_replace(function(old, new)
    return box.tuple.new({new[1], new[2], new[3],
        box.sequence.row_version:next()})
end)
O gatilho fornecido substitui o valor do campo row_ver da tupla armazenada pelo próximo valor da sequência row_version.
Para que possamos extrair dados do espaço goods pela coluna row_ver, vamos criar um índice:
box.space.goods:create_index('row_ver', {
    parts = { 'row_ver' },
    unique = true,
    type = 'TREE',
    if_not_exists = true
})
O tipo de índice é árvore (TREE), pois precisamos extrair os dados em ordem crescente dos valores da coluna row_ver.
Vamos adicionar alguns dados ao espaço:
box.space.goods:insert{nil, 'pen', 123}
box.space.goods:insert{nil, 'pencil', 321}
box.space.goods:insert{nil, 'brush', 100}
box.space.goods:insert{nil, 'watercolour', 456}
box.space.goods:insert{nil, 'album', 101}
box.space.goods:insert{nil, 'notebook', 800}
box.space.goods:insert{nil, 'rubber', 531}
box.space.goods:insert{nil, 'ruler', 135}
Como o primeiro campo é um contador de auto incremento, passamos nil em vez dele. O Tarantool irá automaticamente inserir o próximo valor. Da mesma forma, pode-se passar nil como valor dos campos da coluna, ou não especificar valor algum, já que essa coluna ocupa a última posição no espaço. row_ver Vamos verificar o resultado da inserção:
Vamos verificar o resultado da inserção:
tarantool> box.space.goods:select()
---
- - [1, 'caneta', 123, 1]
  - [2, 'lápis', 321, 2]
  - [3, 'pincel', 100, 3]
  - [4, 'aquarela', 456, 4]
  - [5, 'álbum', 101, 5]
  - [6, 'caderno', 800, 6]
  - [7, 'borracha', 531, 7]
  - [8, 'régua', 135, 8]
...
Como podemos ver, o primeiro e o último campo foram preenchidos automaticamente. Agora não será difícil escrever uma função para a exportação em várias páginas das alterações do espaço. goods:
local page_size = 5
local function get_goods(row_ver)
    local index = box.space.goods.index.row_ver
    local goods = {}
    local counter = 0
    for _, tuple in index:pairs(row_ver, {
        iterator = 'GT' }) do
        local obj = tuple:tomap({ names_only = true })
        table.insert(goods, obj)
        counter = counter + 1
        if counter >= page_size then
            break
        end
    end
    return goods
end
A função recebe como parâmetro o valor row_ver, a partir do qual as alterações devem ser exportadas, e retorna uma porção dos dados alterados.
A seleção de dados no Tarantool é feita através de índices. A função get_goods utiliza um iterador pelo índice row_ver para obter os dados alterados. O tipo de iterador é GT (Greater Than, maior que). Isso significa que o iterador fará a varredura sequencial dos valores do índice a partir da chave passada (valor do campo row_ver).
O iterador retorna tuplas. Para posteriormente poder transmitir os dados via HTTP, é necessário converter as tuplas para uma estrutura que seja conveniente para a serialização posterior. No exemplo, para isso é utilizada a função padrão tomap. Em vez de usar tomap , você pode escrever sua própria função. Por exemplo, podemos querer renomear o campo nome, não passar o campo code e adicionar o campo comentário:
local function unflatten_goods(tuple)
    local obj = {}
    obj.id = tuple.id
    obj.goods_name = tuple.name
    obj.comment = 'um comentário'
    obj.row_ver = tuple.row_ver
    return obj
end
O tamanho da página dos dados retornados (quantidade de registros em uma porção) é determinado pela variável page_size. No exemplo, o valor é page_size equivale a 5. Em um programa real, o tamanho da página geralmente é mais relevante. Ele depende do tamanho médio do tupla do espaço. O tamanho ideal da página pode ser ajustado empiricamente, medindo o tempo de transferência de dados. Quanto maior o tamanho da página, menor será o número de rodadas entre a parte transmissora e a receptora. Assim, podemos reduzir o tempo total de upload das alterações. No entanto, um tamanho de página excessivo pode levar a um tempo maior para o servidor serializar a amostra. Como resultado, pode haver atrasos no processamento de outras solicitações recebidas pelo servidor. O parâmetro page_size pode ser carregado a partir do arquivo de configuração. Para cada espaço transmitido, um valor específico pode ser definido. No entanto, para a maioria dos espaços, o valor padrão pode ser suficiente (por exemplo, 100).
Vamos executar a função get_goods:
tarantool> get_goods(0)

---
- - row_ver: 1
    code: 123
    name: caneta
    id: 1
  - row_ver: 2
    code: 321
    name: lápis
    id: 2
  - row_ver: 3
    code: 100
    name: pincel
    id: 3
  - row_ver: 4
    code: 456
    name: aquarela
    id: 4
  - row_ver: 5
    code: 101
    name: álbum
    id: 5
...
Pegaremos o valor do campo row_ver da última linha e chamaremos a função novamente:
tarantool> get_goods(5)

---
- - row_ver: 6
    code: 800
    name: caderno
    id: 6
  - row_ver: 7
    code: 531
    name: borracha
    id: 7
  - row_ver: 8
    code: 135
    name: régua
    id: 8
...
E novamente:
tarantool> get_goods(8)
---
- []
...
Como vemos, ao usar assim, a função retorna todos os registros do espaço de forma paginada goods. Após a última página, há uma amostra vazia.
Vamos fazer alterações no espaço:
box.space.goods:update(4, {{'=', 6, 'caderno'}})
box.space.goods:insert{nil, 'clipe', 234}
box.space.goods:insert{nil, 'pasta', 432}
Mudamos o valor do campo nome para um registro e adicionamos dois novos registros.
Vamos repetir a última chamada da função:
tarantool> get_goods(8)
---


- - row_ver: 9
    code: 800
    name: caderno
    id: 6
  - row_ver: 10
    code: 234
    name: clipe
    id: 9
  - row_ver: 11
    code: 432
    name: pasta
    id: 10
...
A função retornou os registros alterados e os novos adicionados. Assim, a função get_goods permite obter dados que mudaram desde sua última chamada, que é a base do método de replicação discutido.
Deixaremos a saída de resultados via HTTP em formato JSON fora do escopo deste artigo. Você pode ler sobre isso aqui:
Implementação da parte cliente/slave
Vamos ver como é a implementação do lado receptor. Vamos criar um espaço no lado receptor para armazenar os dados carregados:
box.schema.space.create('goods', {
    format = {
        {
            name = 'id',
            type = 'unsigned'

        },
        {
            name = 'name',
            type = 'string'

        },
        {
            name = 'code',
            type = 'unsigned'

        }
    },
    if_not_exists = true
})

box.space.goods:create_index('primary', {
    parts = { 'id' },
    sequence = 'goods_id',
    unique = true,
    type = 'HASH',
    if_not_exists = true
})
A estrutura do espaço é semelhante à estrutura do espaço na origem. Mas como não pretendemos transmitir os dados recebidos para outro lugar, a coluna row_ver no espaço de destino está ausente. No campo id serão registrados os identificadores da origem. Portanto, do lado do receptor, não há necessidade de torná-lo auto-incremental.
Além disso, precisaremos de um espaço para armazenar os valores row_ver:
box.schema.space.create('row_ver', {
    format = {
        {
            name = 'space_name',
            type = 'string'

        },
        {
            name = 'value',
            type = 'string'

        }
    },
    if_not_exists = true
})

box.space.row_ver:create_index('primary', {
    parts = { 'space_name' },
    unique = true,
    type = 'HASH',
    if_not_exists = true
})
Para cada espaço carregado (campo space_name) vamos armazenar aqui o último valor carregado row_ver (campo valor). A coluna space_name.
será a chave primária. goods Vamos criar uma função para carregar os dados do espaço
via HTTP. Para isso, precisaremos de uma biblioteca que implemente um cliente HTTP. A linha a seguir carrega a biblioteca e cria uma instância do cliente HTTP:local http_client = require('http.client').new()
Também precisaremos de uma biblioteca para deserializar json:local json = require('json')
Isso é suficiente para criar a função de carregamento de dados: local function load_data(url, row_ver) local url = ('%s?rowVer=%s'):format(url, tostring(row_ver)) local body = nil local data = http_client:request('GET', url, body, { keepalive_idle = 1, keepalive_interval = 1 }) return json.decode(data.body) end row_ver A função realiza uma solicitação HTTP para o endereço url, passando-o como parâmetro e retorna o resultado da solicitação deserializado.
A função de salvamento dos dados recebidos tem a seguinte aparência:
local function save_goods(goods)
    local n = #goods
    box.atomic(function()
        for i = 1, n do
            local obj = goods[i]
            box.space.goods:put(
                obj.id, obj.name, obj.code)
        end
    end)
end
O loop de salvamento dos dados no espaço goods está dentro de uma transação (para isso utilizamos a função box.atomic) para reduzir o número de operações no disco.
Finalmente, a função de sincronização do espaço local goods com a origem pode ser implementada assim:
local function sync_goods()
    local tuple = box.space.row_ver:get('goods')
    local row_ver = tuple and tuple.value or 0

    —— set your url here:
    local url = 'http://127.0.0.1:81/test/goods/list'

    while true do
        local goods = load_goods(url, row_ver)

        local count = #goods
        if count == 0 then
            return
        end

        save_goods(goods)

        row_ver = goods[count].rowVer
        box.space.row_ver:put({'goods', row_ver})
    end
end
Primeiro, lemos o valor previamente salvo row_ver para o espaço goods. Se estiver ausente (a primeira sessão de troca), pegamos como row_ver zero. Em seguida, no loop, realizamos o carregamento página a página dos dados alterados da fonte pelo URL especificado. A cada iteração, salvamos os dados recebidos no respectivo espaço local e atualizamos o valor row_ver (no espaço row_ver e na variável row_ver) — pegamos o valor row_ver da última linha dos dados carregados.
Para proteger contra loops acidentais (em caso de erro no programa), o loop while pode ser substituído por para:
for _ = 1, max_req do ... Como resultado da execução da função sync_goods espaço goods no receptor conterá as versões mais recentes de todos os registros do espaço goods na fonte.
É óbvio que dessa forma não é possível transitar a exclusão de dados. Se essa necessidade existir, pode-se usar uma marcação para exclusão. Adicionamos ao espaço goods um campo booleano is_deleted e, em vez de excluir registros fisicamente, usamos a exclusão lógica — definimos o valor do campo is_deleted como valor verdadeiro. Às vezes, em vez de um campo booleano, is_deleted é mais conveniente usar um campo deleted, que armazena a data e hora da exclusão lógica do registro. Após a execução da exclusão lógica, o registro marcado para exclusão será transferido da fonte para o receptor (de acordo com a lógica discutida acima).
A sequência row_ver pode ser usada para transferir dados de outros espaços: não há necessidade de criar uma sequência separada para cada espaço transferido.
Discutimos uma maneira eficaz de replicação de dados de alto nível em aplicativos que utilizam o SGBD Tarantool.
Como resultado, obtemos um serviço de "monitoramento como serviço", automatizado na linha de produção de integração contínua. O desenvolvedor ou testador precisa apenas definir a lista de métricas em um arquivo JSON, e tudo o mais acontece automaticamente. Obtemos um controle de qualidade transparente dos lançamentos: todas as notificações sobre desempenho, consumo de recursos ou regressões arquitetônicas.
- O SGBD Tarantool é um produto atraente e promissor para a criação de aplicativos de alta carga.
- A replicação de dados em alto nível tem várias vantagens em relação à replicação em baixo nível.
- O método de replicação em alto nível discutido no artigo permite minimizar a quantidade de dados transferidos, enviando apenas aqueles registros que foram alterados desde a última sessão de troca.
Fonte: habr.com
