

Desde 2019, existe uma lei na Rússia sobre a rotulagem obrigatória. A lei não se aplica a todos os grupos de produtos, e os prazos para a implementação da rotulagem obrigatória variam entre os grupos de produtos. Os primeiros a serem incluídos na rotulagem obrigatória são tabaco, calçados e medicamentos, com outros produtos, como perfumes, têxteis e leite, sendo adicionados posteriormente. Essa inovação legislativa estimulou o desenvolvimento de novas soluções de TI que permitirão rastrear toda a cadeia de vida do produto desde a produção até a compra pelo consumidor final, abrangendo todos os participantes do processo: tanto o próprio governo quanto todas as organizações que comercializam produtos com rotulagem obrigatória.
Na X5, o sistema que rastreará produtos com rotulagem e trocará dados com o governo e fornecedores foi chamado de “Marcus”. Vamos explicar, passo a passo, como e quem o desenvolveu, qual é sua pilha de tecnologias e por que temos motivos para nos orgulhar.
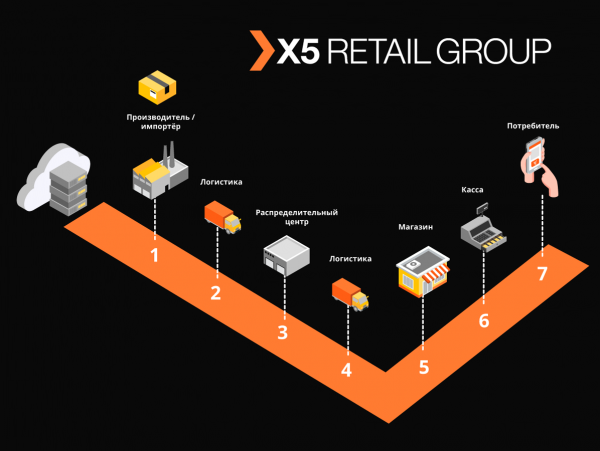
Um verdadeiro HighLoad
“Marcus” resolve várias tarefas, sendo a principal delas a interação de integração entre os sistemas de informação da X5 e o sistema de informação estatal de produtos rotulados (GIS MP) para rastrear o movimento de produtos rotulados. Além disso, a plataforma armazena todos os códigos de rotulagem que recebemos e todo o histórico de movimentação desses códigos entre os objetos, ajudando a eliminar a separação incorreta de produtos rotulados. Tomando como exemplo os produtos de tabaco, que foram os primeiros grupos de produtos rotulados, apenas um caminhão de cigarros contém cerca de 600.000 maços, cada um com seu código único. E a tarefa do nosso sistema é rastrear e verificar a legalidade dos movimentos de cada um desses maços entre armazéns e lojas e, em última instância, verificar a viabilidade da sua venda ao consumidor final. Registramos cerca de 125.000 operações de caixa por hora, além de precisar registrar como cada um desses maços chegou à loja. Assim, considerando todos os movimentos entre os objetos, esperamos dezenas de bilhões de registros por ano.
Equipe M
Embora o "Marcus" seja considerado um projeto dentro da X5, está sendo realizado com uma abordagem de produto. A equipe trabalha com Scrum. O projeto começou no verão do ano passado, mas os primeiros resultados só chegaram em outubro — uma equipe própria foi totalmente formada, a arquitetura do sistema foi desenvolvida e o equipamento foi comprado. Atualmente, a equipe conta com 16 pessoas, das quais seis estão envolvidas no desenvolvimento de backend e frontend, e três na análise de sistemas. Outros seis se ocupam de testes manuais, de carga, de automação e do suporte ao produto. Além disso, temos um especialista em SRE.
Na nossa equipe, não apenas os desenvolvedores escrevem código, praticamente todos os membros sabem programar e escrevem autotestes, scripts de carga e scripts de automação. Damos uma atenção especial a isso, pois mesmo o suporte ao produto requer um alto nível de automação. Sempre procuramos orientar e ajudar os colegas que antes não programavam, atribuindo-lhes algumas pequenas tarefas.
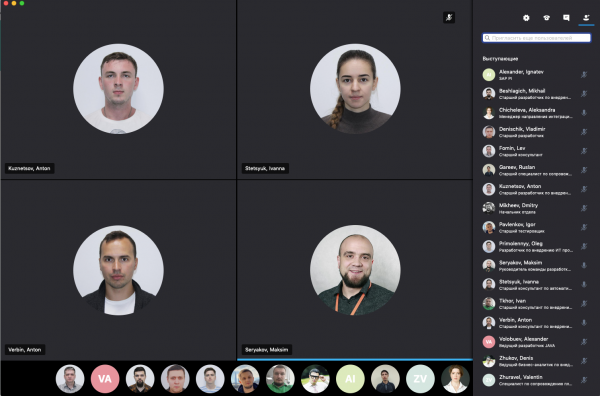
Devido à pandemia de coronavírus, transferimos toda a equipe para o trabalho remoto, e a disponibilidade de todas as ferramentas para gerenciamento de desenvolvimento, junto com o workflow definido no Jira e GitLab, permitiu que superássemos essa fase com facilidade. Os meses que passamos trabalhando remotamente mostraram que a produtividade da equipe não foi prejudicada, e para muitos, o conforto no trabalho aumentou; a única coisa que sentimos falta foi da comunicação face a face.
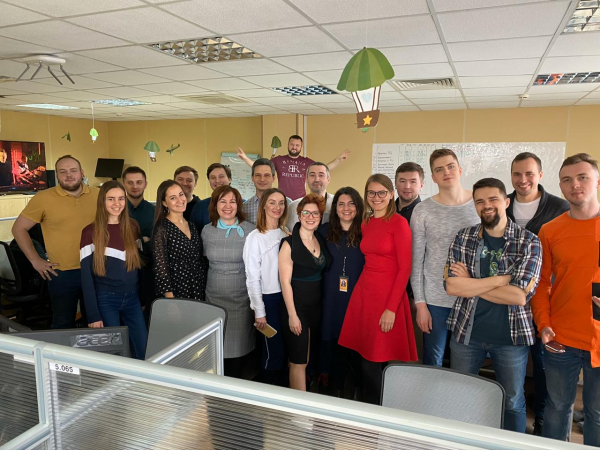
Reunião da equipe antes do trabalho remoto
Reuniões durante o trabalho remoto
Pilha tecnológica da solução
O repositório padrão e a ferramenta de CI/CD para a X5 é o GitLab. Usamos para armazenar código, realizar testes contínuos e implementar em servidores de teste e produção. Também adotamos a prática de revisão de código, que requer a aprovação de pelo menos dois colegas para as alterações feitas pelo desenvolvedor. Ferramentas de análise estática de código, como SonarQube e JaCoCo, nos ajudam a manter o código limpo e a garantir o nível exigido de cobertura de testes unitários. Todas as alterações no código devem passar por essas validações. Todos os cenários de teste que são executados manualmente são posteriormente automatizados.
Para a execução bem-sucedida dos processos de negócios do “Marcus”, tivemos que resolver uma série de desafios tecnológicos, cada um em sua ordem.
Tarefa 1. A necessidade de escalabilidade horizontal do sistema
Para resolver essa tarefa, optamos pela abordagem de microserviços na arquitetura. Foi muito importante entender as áreas de responsabilidade dos serviços. Nós nos esforçamos para dividi-los de acordo com as operações comerciais, levando em consideração a especificidade dos processos. Por exemplo, a recepção no armazém é uma operação não muito frequente, mas muito volumosa, durante a qual é necessário obter o mais rapidamente possível do órgão regulador as informações sobre as unidades de produto recebidas, cujas quantidades em uma única remessa podem chegar a 600000, verificar a aceitabilidade da recepção desse produto no armazém e fornecer todas as informações necessárias ao sistema de automação do armazém. Já a expedição dos armazéns tem uma intensidade muito maior, mas opera com volumes de dados menores.
Todos os serviços são implementados com o princípio stateless e até mesmo as operações internas tentamos dividir em etapas, utilizando, como chamamos, self-tópicos Kafka. Isso ocorre quando um microserviço envia uma mensagem para si mesmo, o que ajuda a balancear a carga em operações mais pesadas e simplifica a manutenção do produto, mas vamos falar mais sobre isso depois.
Decidimos destacar em serviços separados os módulos de interação com sistemas externos. Isso resolveu o problema de APIs externas frequentemente alteradas, quase sem impactar os serviços com funcionalidade comercial.
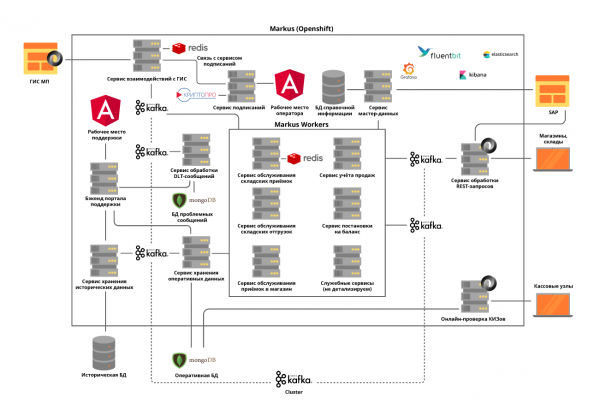
Todos os microserviços são implantados em um cluster OpenShift, que resolve tanto o problema de escalabilidade de cada microserviço quanto nos permite não utilizar ferramentas externas de Service Discovery.
Tarefa 2. A necessidade de suportar alta carga e um intercâmbio de dados muito intenso entre os serviços da plataforma: apenas na fase de lançamento do projeto, cerca de 600 operações por segundo são executadas. Esperamos que esse número aumente para 5000 op/sec à medida que mais pontos comerciais se conectem à nossa plataforma.
Essa tarefa foi resolvida através da implementação de um cluster Kafka e pela quase total eliminação da interação síncrona entre os microsserviços da plataforma. Isso exige uma análise muito cuidadosa dos requisitos do sistema, uma vez que nem todas as operações podem ser assíncronas. Além disso, não estamos apenas transmitindo eventos através de um broker, mas também passando todas as informações de negócios necessárias na mensagem. Assim, o tamanho da mensagem pode chegar a várias centenas de kilobytes. A limitação de tamanho de mensagens no Kafka exige uma previsão precisa do tamanho das mensagens, e, se necessário, as dividimos, mas essa divisão é lógica, relacionada às operações de negócios.
Por exemplo, um produto que chega de carro, dividimos por caixas. Para operações síncronas, são designados microsserviços separados e é realizado um rigoroso teste de carga. O uso do Kafka nos apresentou um novo desafio — o teste de funcionalidade do nosso serviço, dado que a integração com o Kafka torna todos os nossos testes unitários assíncronos. Para resolver essa questão, escrevemos nossos próprios métodos utilitários usando o Embedded Kafka Broker. Isso não elimina a necessidade de escrever testes unitários para métodos individuais, mas preferimos testar casos complexos usando o Kafka.
Colocamos muita atenção na rastreabilidade dos logs, para garantir que seus TraceId não se percam em caso de exceções durante a operação dos serviços ou ao lidar com o Kafka batch. E se com o primeiro isso não gerou questões especiais, no segundo caso fomos forçados a registrar no log todos os TraceId recebidos pelo batch e escolher um para continuar a rastreabilidade. Assim, ao procurar pelo TraceId original, o usuário facilmente encontrará com qual rastreamento continuou.
Tarefa 3. Necessidade de armazenar grandes quantidades de dados: mais de 1 bilhão de etiquetas por ano apenas de tabaco chega à X5. É necessário acesso constante e rápido a esses dados. Ao todo, o sistema deve processar cerca de 10 bilhões de registros sobre a história do movimento de produtos com marcas registradas.
Para resolver a terceira tarefa, foi escolhido o banco de dados NoSQL MongoDB. Construímos um shard com 5 nós e, em cada nó, um Replica Set com 3 servidores. Isso permite escalar o sistema horizontalmente, adicionando novos servidores no cluster, garantindo sua resiliência. Aqui nos deparamos com outro problema — a garantia de transacionalidade no cluster do mongo, considerando o uso de microserviços escaláveis horizontalmente. Por exemplo, uma das tarefas do nosso sistema é identificar tentativas de revenda de produtos com códigos de marcação iguais. Aqui surgem sobreposições com digitalizações incorretas ou com operações de caixa erradas. Descobrimos que essas duplicidades podem ocorrer tanto dentro de um único batch processado pelo Kafka, quanto entre dois batches processados em paralelo. Assim, a verificação da existência de duplicatas através de uma consulta ao banco não trouxe resultados. Para cada um dos microserviços, resolvemos o problema separadamente, baseado na lógica de negócios desse serviço. Por exemplo, para os recibos, adicionamos uma verificação dentro do batch e um tratamento separado para a aparição de duplicatas na inserção.
Para que o trabalho dos usuários com o histórico de operações não afete o mais importante — o funcionamento dos nossos processos de negócios, destacamos todos os dados históricos em um serviço separado com um banco de dados separado, que também recebe informações via Kafka. Assim, os usuários trabalham com um serviço isolado, sem influenciar os serviços que processam dados sobre operações atuais.
Tarefa 4. Reprocessamento de filas e monitoramento:
Em sistemas distribuídos, surgem inevitavelmente problemas e erros de acessibilidade das bases de dados, filas e fontes de dados externas. No caso do 'Markus', a origem desses erros é a integração com sistemas externos. Era necessário encontrar uma solução que permitisse fazer novas requisições após respostas erradas com um determinado timeout, mas sem interromper o processamento de requisições bem-sucedidas na fila principal. Para isso, foi escolhida a denominada conceito de “retry baseado em tópico”. Para cada tópico principal, cria-se um ou vários tópicos de retry, para onde são direcionadas as mensagens com erro, excluindo assim a latência no processamento das mensagens do tópico principal. O esquema de interação —
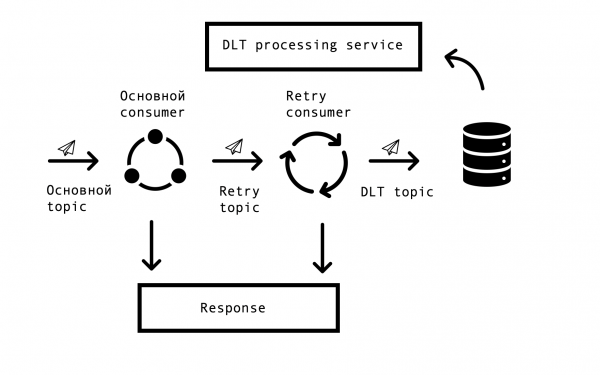
Para implementar esse esquema, precisávamos do seguinte - integrar essa solução com o Spring e evitar a duplicação de código. Na vastidão da internet, encontramos uma solução semelhante baseada no Spring BeanPostProcessor, mas ela nos pareceu excessivamente complicada. Nossa equipe desenvolveu uma solução mais simples, permitindo integrar-se ao ciclo de criação de consumidores do Spring e adicionar consumidores Retry adicionalmente. O protótipo da nossa solução foi apresentado à equipe do Spring, e pode ser visualizado. . O número de consumidores Retry e o número de tentativas de cada consumidor são configuráveis através de parâmetros, dependendo das necessidades do processo de negócios, e para que tudo funcione, é necessário apenas adicionar a familiar anotação org.springframework.kafka.annotation.KafkaListener, bem conhecida entre os desenvolvedores Spring.
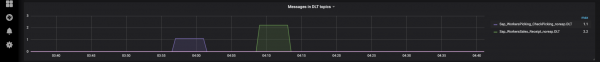
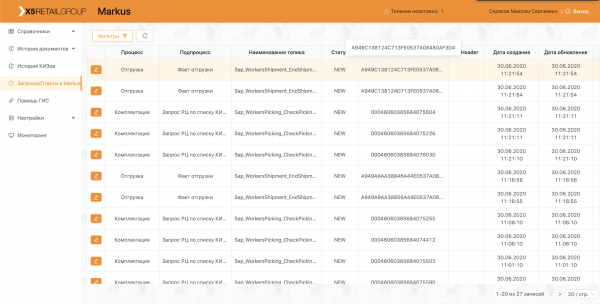
Caso a mensagem não consiga ser processada após todas as tentativas de retry, ela é direcionada para o DLT (dead letter topic) através do Spring DeadLetterPublishingRecoverer. A pedido do suporte, ampliamos essa funcionalidade e criamos um serviço separado que permite visualizar as mensagens que foram para o DLT, stackTrace, traceId e outras informações úteis sobre elas. Além disso, foram adicionados monitoramentos e alertas para todos os tópicos DLT, e atualmente, a aparição de uma mensagem no tópico DLT é um motivo para investigação e abertura de um defeito. Isso é muito conveniente – pelo nome do tópico, entendemos imediatamente em qual etapa do processo surgiu o problema, o que acelera significativamente a busca pela causa raiz.
Recentemente, implementamos uma interface que permite reenviar mensagens pela nossa equipe de suporte, após a resolução de suas causas (por exemplo, a restauração do funcionamento de um sistema externo) e, claro, a abertura do defeito correspondente para análise. Aqui, nossas self-tópicos foram úteis, pois, para não reiniciar toda a longa cadeia de processamento, podemos reiniciá-la a partir do passo necessário.
Operação da plataforma
A plataforma já está em operação produtiva, realizamos entregas e expedições todos os dias, conectamos novos centros de distribuição e lojas. No âmbito do piloto, o sistema opera com grupos de produtos "Tabaco" e "Calçados".
Toda a nossa equipe participa na realização dos pilotos, analisa os problemas que surgem e faz sugestões para aprimorar nosso produto, desde melhorias nos logs até mudanças nos processos.
Para não repetir os mesmos erros, todos os casos encontrados durante a fase piloto são refletidos em testes automatizados. A presença de um grande número de testes automatizados e de testes unitários permite realizar testes de regressão e implementar hotfixes em questão de poucas horas.
Atualmente, continuamos a desenvolver e aprimorar nossa plataforma e enfrentamos novos desafios constantemente. Se você estiver interessado, falaremos sobre nossas soluções em artigos futuros.
Fonte: habr.com
