

Pavel Selivanov, arquiteto de soluções da Southbridge e instrutor do Sloerm, apresentou uma palestra na DevOpsConf 2019. Esta palestra é parte de um dos temas do curso avançado em Kubernetes "Sloerm Mega".
acontece em Moscovo de 18 a 20 de novembro.
— Moscovo, de 22 a 24 de novembro.
disponível a qualquer momento.
Abaixo, está a transcrição da palestra.
Bom dia, colegas e simpatizantes. Hoje, vou falar sobre segurança.
Vejo que há muitos profissionais de segurança na sala hoje. Peço desculpas antecipadamente se usar termos do mundo da segurança de uma maneira que não seja a habitual para vocês.
Há cerca de seis meses, coloquei as mãos em um cluster Kubernetes público. Público significa que existem um certo número de namespaces, nesses namespaces há usuários, isolados em seus próprios namespaces. Todos esses usuários pertencem a diferentes empresas. E, supunha-se que esse cluster deveria ser usado como CDN. Ou seja, você recebe um cluster, recebe um usuário, você entra no seu namespace e faz o deploy das suas aplicações front-end.
A minha empresa anterior tentou vender um serviço desse tipo. E pediram-me para testar o cluster para ver se essa solução era adequada.
Entrei nesse cluster. Recebi direitos limitados e um namespace restrito. As pessoas lá entendiam o que era segurança. Elas estavam cientes do que era o controle de acesso baseado em função (RBAC) do Kubernetes — e configuraram de tal forma que eu não conseguia iniciar pods separadamente dos deployments. Não me lembro da tarefa que estava tentando resolver, iniciando um pod sem um deployment, mas realmente queria simplesmente iniciar um pod. Decidi verificar quais direitos eu tinha no cluster, o que eu podia fazer, o que não podia, e o que eles estavam fazendo de errado no RBAC.
Acabei de forma que, em dois minutos, consegui o acesso de administrador ao cluster deles, olhei todos os namespaces vizinhos e vi lá aplicações front-end de produção de empresas que já compraram o serviço e fizeram o deploy. Eu mal consegui me controlar para não ir a uma das front-ends e colocar uma palavra ofensiva na página inicial.
Vou falar com exemplos de como fiz isso e como é preciso se proteger contra isso.
Mas antes, deixem-me apresentar. Meu nome é Pavel Selivanov. Sou arquiteto da empresa Southbridge. Eu entendo de Kubernetes, DevOps e coisas modernas. Nós, engenheiros da Southbridge, construímos tudo isso, enquanto eu consulto.
Além da atividade principal, recentemente lançamos projetos chamados Slërmy. Estamos tentando trazer um pouco da nossa habilidade em trabalhar com Kubernetes para as massas, ensinando outras pessoas a também trabalhar com K8s.
Sobre o que vou falar hoje. O tema da apresentação é óbvio — sobre a segurança do cluster Kubernetes. Mas quero deixar claro que este é um tema muito amplo — e por isso, quero esclarecer do que definitivamente não falarei. Não falarei sobre termos batidos que já foram triturados na internet. Coisas como RBAC e certificados.
Vou falar sobre o que eu e meus colegas sentimos em relação à segurança no cluster Kubernetes. Vemos esses problemas tanto em provedores que oferecem clusters Kubernetes quanto em clientes que nos procuram. E até em clientes que vêm até nós de outras empresas de consultoria. Ou seja, a magnitude da tragédia é realmente grande.
Literalmente três pontos que vou abordar hoje:
- Direitos dos usuários vs direitos dos pods. Os direitos dos usuários e os direitos dos pods não são a mesma coisa.
- Coleta de informações sobre o cluster. Vou mostrar que é possível coletar todas as informações do cluster que são necessárias, sem ter permissões especiais nesse cluster.
- Ataque DoS ao cluster. Se não conseguirmos coletar informações, poderemos derrubar o cluster de qualquer forma. Vou falar sobre ataques DoS aos componentes de controle do cluster.
Outra coisa geral que mencionarei — em que testei tudo isso, que com certeza posso afirmar que tudo funciona.
Tomamos como base a instalação do cluster Kubernetes usando o Kubespray. Se alguém não sabe, isso é, na verdade, um conjunto de funções para Ansible. Nós o usamos constantemente em nosso trabalho. É bom porque pode ser implantado em qualquer lugar — tanto em hardware quanto em nuvem. Um método de instalação é, basicamente, adequado para tudo.
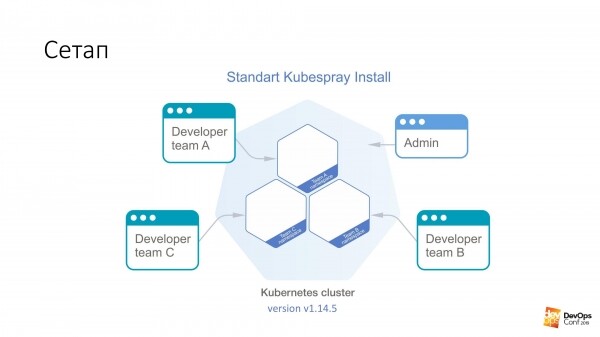
Neste cluster, terei Kubernetes v1.14.5. Todo o cluster Kube que iremos considerar é dividido em namespaces, cada namespace pertence a uma equipe separada, e cada namespace tem acesso concedido aos membros dessa equipe. Eles não podem acessar outros namespaces, apenas o seu próprio. Mas existe uma conta de administrador que possui direitos sobre todo o cluster.
Eu prometi que o primeiro passo seria obter direitos administrativos no cluster. Precisamos de um pod especialmente preparado que vai comprometer o cluster Kubernetes. Tudo o que precisamos fazer é aplicá-lo no cluster Kubernetes.
kubectl apply -f pod.yamlEste pod chegará a um dos mestres do cluster Kubernetes. E o cluster nos devolverá com alegria um arquivo chamado admin.conf. Este arquivo contém todos os certificados do administrador e também configura o API do cluster. É assim que podemos obter acesso administrativo, acho que em 98% dos clusters Kubernetes.
Para reiterar, este pod foi criado por um desenvolvedor em seu cluster, que tinha acesso para implantar suas propostas em um pequeno namespace, estando totalmente restringido por RBAC. Ele não tinha nenhum direito. No entanto, o certificado foi retornado.
Agora vamos falar sobre o pod especialmente preparado. Vamos executá-lo em qualquer imagem. Para exemplo, tomaremos debian:jessie.
Temos algo assim:
tolerations:
-   effect: NoSchedule
    operator: Exists
nodeSelector:
    node-role.kubernetes.io/master: ""
O que é toleration? Os mestres no cluster Kubernetes geralmente são marcados com uma coisa chamada taint ("contaminação" em inglês). A essência dessa "contaminação" é que os pods não podem ser alocados nos nós mestres. Mas nada impede que em qualquer pod se indique que ele é tolerante a essa "contaminação". A seção Toleration diz que se um nó tiver NoSchedule, nosso pod é tolerante a essa contaminação e não haverá problemas.
Em seguida, dizemos que nosso pod não é apenas tolerante, mas também deseja especificamente ser alocado em um mestre. Porque nos mestres está o que precisamos — todos os certificados. Portanto, dizemos nodeSelector — e temos um rótulo padrão nos mestres que permite escolher entre todos os nós do cluster aqueles que são mestres.
Com essas duas seções, o pod certamente será alocado no mestre. E ele terá permissão para residir lá.
Mas simplesmente chegar ao mestre não é suficiente. Isso não nos dará nada. Portanto, em seguida, temos duas coisas assim:
hostNetwork: true
hostPID: true
Indicamos que nosso pod, que estamos lançando, viverá no namespace do núcleo, no namespace de rede e no namespace PID. Assim que o pod for iniciado no master, ele poderá ver todas as interfaces reais e ativas desse nó, escutar todo o tráfego e ver o PID de todos os processos.
A partir daí, é simples. Você pega o etcd e lê o que quiser.
O mais interessante é essa funcionalidade do Kubernetes, que está lá por padrão.
volumeMounts:
- mountPath: /host
  name: host
volumes:
- hostPath:
    path: /
    type: Directory
  name: host
E a essência disso é que podemos, no pod que estamos lançando, mesmo sem privilégios sobre esse cluster, declarar que queremos criar um volume do tipo hostPath. Ou seja, pegar o caminho do host em que vamos executar — e usá-lo como volume. Em seguida, o nomeamos como name: host. Todo esse hostPath é montado dentro do pod. Neste exemplo, no diretório /host.
Vou repetir. Dissemos ao pod para ir ao master, obter hostNetwork e hostPID — e montar toda a raiz do master dentro desse pod.
Você entende que no Debian temos o bash em execução, e esse bash está funcionando como root. Ou seja, acabamos de obter acesso root ao master, sem ter quaisquer direitos no cluster Kubernetes.
A próxima tarefa é entrar no pod no diretório /host /etc/kubernetes/pki, se não me engano, pegar todos os certificados de mestre do cluster e, consequentemente, tornar-se o administrador do cluster.
Se olharmos bem, estes são alguns dos direitos mais perigosos nos pods — independentemente dos direitos que o usuário possui:
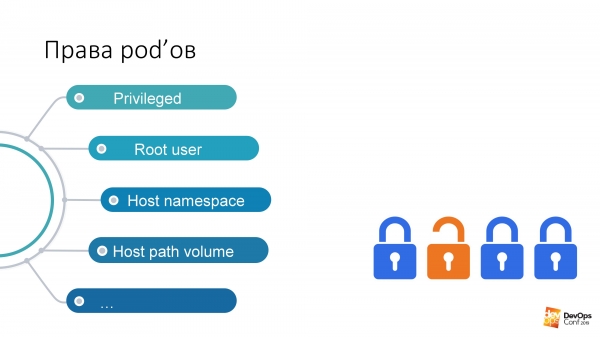
Se eu tenho privilégios para iniciar um pod em um namespace do cluster, esse pod tem esses direitos por padrão. Eu posso iniciar pods privilegiados, e isso é basicamente ter todos os direitos, praticamente como root no nó.
Meu favorito — o Root user. E o Kubernetes tem uma opção chamada Run As Non-Root. É uma espécie de proteção contra hackers. Você sabe o que é um 'vírus moldavo'? Se você, de alguma forma, é um hacker e entrou no meu cluster Kubernetes, nós, pobres administradores, pedimos: 'Por favor, especifique em seus pods, com os quais você irá hackear meu cluster, run as non-root. Caso contrário, você pode iniciar um processo em seu pod como root, e será muito fácil me hackear. Proteja-se, por favor, de si mesmo'.
O volume de caminho do host — na minha opinião, é a maneira mais rápida de obter o resultado desejado do cluster Kubernetes.
Mas o que fazer com tudo isso?
Pensamentos que devem vir à mente de qualquer administrador normal ao lidar com Kubernetes: “Ah, eu disse que o Kubernetes não funciona. Tem falhas. E tudo isso é uma droga”. Na verdade, existe algo chamado documentação, e se você olhar para lá, há uma seção .
Este é um objeto YAML - podemos criá-lo no cluster Kubernetes - que controla aspectos de segurança especificamente na descrição dos pods. Ou seja, na prática, ele controla os direitos de uso de várias coisas, como hostNetwork, hostPID, certos tipos de volume, que existem nos pods durante a execução. Com a Política de Segurança de Pod, tudo isso pode ser descrito.
O mais interessante sobre a Política de Segurança de Pod é que no cluster Kubernetes, todos os instaladores de PSP não estão simplesmente descritos de forma alguma; eles estão simplesmente desativados por padrão. A Política de Segurança de Pod é ativada por meio de um plugin de admission.
Ok, vamos implantar a Política de Segurança de Pod no cluster, digamos que temos alguns pods de serviço no namespace, aos quais apenas os administradores têm acesso. Vamos dizer que todos os outros pods têm direitos limitados. Porque provavelmente os desenvolvedores não precisam executar pods privilegiados no seu cluster.
E parece que está tudo bem. E nosso cluster Kubernetes não pode ser hackeado em dois minutos.
Há um problema. Provavelmente, se você tiver um cluster Kubernetes, terá um monitoramento instalado nele. Eu até me atrevo a prever que se houver monitoramento no seu cluster, ele se chama Prometheus.
O que vou dizer agora será válido tanto para o operador do Prometheus quanto para o Prometheus instalado em sua forma pura. A questão é que se eu não consigo obter rapidamente um administrador no cluster, isso significa que preciso procurar mais. E posso fazer essa busca usando seu monitoramento.
Provavelmente, todos leram os mesmos artigos no Habr, e o monitoramento está no namespace monitoring. O Helm chart de todos é chamado de forma semelhante. Presumo que se você fizer helm install stable/prometheus, os nomes serão aproximadamente os mesmos. E, provavelmente, o nome DNS no seu cluster eu não precisarei adivinhar. Porque é padrão.
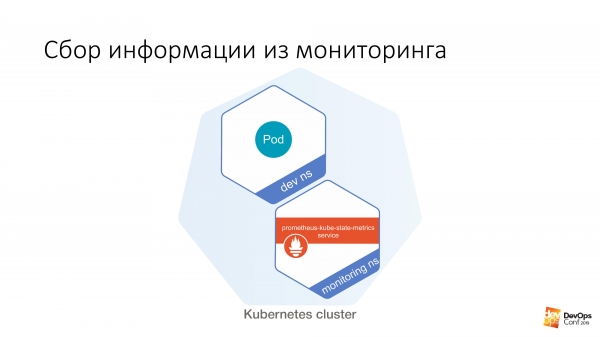
Em seguida, temos um namespace dev, onde é possível iniciar um pod. E depois desse pod, é muito fácil fazer assim:
$ curl http://prometheus-kube-state-metrics.monitoring prometheus-kube-state-metrics é um dos exportadores do Prometheus que coleta métricas da API do Kubernetes. Há uma grande quantidade de dados sobre o que está rodando no seu cluster, como está esse ambiente e quais problemas você tem com ele.
Como um exemplo simples:
kube_pod_container_info{namespace="kube-system",pod="kube-apiserver-k8s-1",container="kube-apiserver",image=
"gcr.io/google-containers/kube-apiserver:v1.14.5"
,image_id="docker-pullable://gcr.io/google-containers/kube-apiserver@sha256:e29561119a52adad9edc72bfe0e7fcab308501313b09bf99df4a9638ee634989",container_id="docker://7cbe7b1fea33f811fdd8f7e0e079191110268f2853397d7daf08e72c22d3cf8b"} 1
Fazendo uma simples requisição curl de um pod não privilegiado, você pode obter essas informações. Se você não sabe em qual versão do Kubernetes está rodando, ele pode facilmente informar você.
E a parte mais interessante é que, além de acessar o kube-state-metrics, você também pode acessar diretamente o Prometheus com a mesma eficácia. Você pode coletar métricas de lá. Você pode até construir métricas a partir dali. Teoricamente, você poderia elaborar uma requisição do cluster para o Prometheus que simplesmente o desligaria. E seu monitoramento pararia completamente de funcionar.
E aqui surge a questão: algum monitoramento externo está monitorando o seu monitoramento? Acabei de conseguir atuar no cluster do Kubernetes sem consequências para mim. Você nem vai saber que estou lá, pois o monitoramento já não existe.
Da mesma forma que com o PSP, dá a sensação de que o problema é que todas essas tecnologias modernas — Kubernetes, Prometheus — simplesmente não funcionam e estão cheias de buracos. Na verdade, não é isso.
Há uma coisa chamada — .
Se você é um bom administrador, provavelmente sabe que a Política de Rede é apenas mais um yaml, que já existem muitos no cluster. E algumas Políticas de Rede definitivamente não são necessárias. E mesmo que você tenha lido o que é uma Política de Rede, que se trata de um firewall em yaml do Kubernetes, que permite restringir os direitos de acesso entre namespaces e entre pods, você deve ter decidido que um firewall em formato yaml no Kubernetes é apenas mais uma das abstrações... Não, isso definitivamente não é necessário.
Mesmo que seus especialistas de segurança não tenham sido informados de que é possível construir, de maneira muito simples, um firewall granulado com seu Kubernetes, se eles ainda não souberem disso e não te pressionarem: "Então, pode passar, pode passar...". De qualquer forma, você precisará da Network Policy para restringir o acesso a alguns locais administrativos que podem ser acessados do seu cluster sem qualquer autorização.
Como no exemplo que mencionei, é possível acessar os kube state metrics de qualquer namespace no cluster Kubernetes, sem ter direitos para isso. As políticas de rede restringiram o acesso de todos os outros namespaces ao namespace de monitoramento e com isso: sem acesso, sem problemas. Em todos os charts disponíveis, tanto do Prometheus padrão quanto do Prometheus do operador, há simplesmente uma opção na values do Helm que permite ativar políticas de rede para eles. Basta habilitar e elas funcionarão.
Aqui, na verdade, há um problema. Sendo um bom administrador, você provavelmente decidiu que as políticas de rede não são necessárias. E, após ler vários artigos em sites como o Habr, você chegou à conclusão de que o flannel, especialmente no modo host-gateway, é a melhor opção que você pode escolher.
O que fazer?
Você pode tentar redesplegar a solução de rede que está em seu cluster Kubernetes e substituí-la por algo mais funcional. Por exemplo, pelo Calico. Mas, quero avisar imediatamente, a tarefa de mudar a solução de rede em um cluster Kubernetes em funcionamento não é nada trivial. Eu já resolvi isso duas vezes (ambas teoricamente), mas até mesmo em nossas apresentações mostramos como fazer. Para nossos alunos, demonstramos como mudar a solução de rede no cluster Kubernetes. Basicamente, você pode tentar fazer isso de modo que não haja downtime no cluster de produção. Mas provavelmente você não conseguirá.
E o problema, na verdade, é resolvido de forma muito simples. No cluster, existem certificados, e você sabe que os certificados vão expirar em um ano. Normalmente, a solução padrão para os certificados em um cluster é a seguinte: por que nos preocuparmos? Vamos levantar um novo cluster ao lado, o antigo pode expirar, e fazemos tudo de novo. É verdade que, quando ele expirar, teremos um dia que ficará inativo, mas ao menos teremos um novo cluster.
Quando você for levantar o novo cluster, aproveite e insira o Calico no lugar do flannel.
O que fazer se você tiver certificados emitidos para cem anos e não pretende reprovisionar o cluster? Existe uma ferramenta chamada Kube-RBAC-Proxy. É uma excelente solução que permite ser integrada como um container sidecar a qualquer pod no cluster Kubernetes. E, na prática, ela adiciona autenticação via RBAC do próprio Kubernetes a esse pod.
Há um problema. Anteriormente, a solução Kube-RBAC-Proxy estava integrada no operador do Prometheus. Mas isso não existe mais. As versões modernas agora pressupõem que você tenha uma política de rede e a utilize para restringir o acesso. Portanto, será necessário reescrever um pouco o chart. Na verdade, se você acessar , lá você encontrará exemplos de como usá-lo como sidecars, e os charts precisarão ser reescritos no mínimo.
Há mais um pequeno problema. Não apenas o Prometheus expõe suas métricas indiscriminadamente. Todos os componentes do cluster Kubernetes também podem expor suas próprias métricas.
Mas, como já mencionei, se você não consegue acessar o cluster e coletar informações, pelo menos pode causar algum dano.
Então, vou rapidamente mostrar duas maneiras de como você pode prejudicar a saúde de um cluster Kubernetes.
Vocês vão rir quando eu contar, são dois casos da vida real.
Primeiro método. Esgotamento de recursos.
Vamos iniciar mais um pod especial. Ele terá esta seção.
resources:
    requests:
        cpu: 4
        memory: 4Gi
Como você sabe, requests são a quantidade de CPU e memória que são reservadas no host para pods específicos com requisições. Se temos um host quad-core no cluster Kubernetes, e chega um pod com requisições de quatro CPUs, isso significa que nenhum outro pod com requisições conseguirá ser alocado nesse host.
Se eu iniciar esse pod e depois executar o comando:
$ kubectl scale special-pod --replicas=...Então, ninguém mais conseguirá ser implantado no cluster Kubernetes. Porque todos os nós ficarão sem requisições. Dessa forma, eu poderei parar o seu cluster Kubernetes. Se eu fizer isso à noite, os deployments poderão ficar interrompidos por um bom tempo.
Se olharmos mais uma vez para a documentação do Kubernetes, veremos algo chamado Limit Range. Ele estabelece recursos para objetos do cluster. Você pode escrever um objeto Limit Range em YAML, aplicá-lo a namespaces específicos — e assim, nesse namespace, você pode especificar que possui recursos padrão, máximos e mínimos para os pods.
Com essa ferramenta, podemos restringir os usuários em namespaces de produtos específicos das equipes em suas capacidades de indicar coisas indesejadas em seus pods. Mas, infelizmente, mesmo que você avise um usuário para não lançar pods com requisições superiores a um CPU, existe um comando maravilhoso chamado scale, ou através do painel eles podem realizar o scale.
E a partir daí surge o segundo método. Lançamos 11 111 111 111 111 pods. Isso é onze bilhões. Não é porque eu inventei esse número, mas porque eu mesmo presenciei isso.
Uma história real. No final da noite, eu já estava prestes a sair do escritório. Olhei, e em um canto havia um grupo de desenvolvedores fazendo algo freneticamente com seus laptops. Fui até os caras e perguntei: "O que aconteceu com vocês?"
Um pouco antes, por volta das nove da noite, um dos desenvolvedores estava se preparando para ir para casa. E decidiu: "Agora eu vou escalar meu aplicativo para um". Ele pressionou um, mas a internet estava um pouco lenta. Ele pressionou mais uma vez, apertou o um, clicou no Enter. Tentou tudo que podia. Então a internet respondeu — e tudo começou a escalar para esse número.
Na verdade, essa história não aconteceu no Kubernetes, na época era o Nomad. Isso terminou após uma hora de tentativas de impedir que o Nomad de insistentes tentativas de escalar; o Nomad respondeu que não pararia de escalar e não faria mais nada. "Estou cansado, vou embora". E encerrou.
Naturalmente, eu tentei fazer o mesmo no Kubernetes. Onze bilhões de pods não agradaram o Kubernetes, ele disse: "Não posso. Excede os limites internos". Mas 1 000 000 000 de pods funcionaram.
Em resposta a um bilhão de Pods, ele realmente começou a escalar. Quanto mais o processo avançava, mais tempo levava para criar novos Pods. Mas o processo continuava. O único problema é que, se eu posso lançar Pods ilimitadamente em meu namespace, mesmo sem solicitações e limites, posso criar tantos Pods com algumas tarefas que, com essas tarefas, os nós começam a ficar sobrecarregados em termos de memória e CPU. Quando eu lanço tantos Pods, as informações delas precisam ser armazenadas, ou seja, no etcd. E quando informações demais chegam lá, o armazenamento começa a ficar muito lento — e o Kubernetes começa a enfrentar latências.
E há outro problema... Como vocês sabem, os componentes de controle do Kubernetes não são uma única peça central, mas sim vários componentes. Ali, em particular, há o controlador de gerência, o scheduler e assim por diante. Todos esses caras começam a realizar simultaneamente um trabalho desnecessário que, com o tempo, vai demandar cada vez mais tempo. O controlador de gerência vai criar novos Pods. O scheduler tentará encontrar um novo nó para eles. É provável que os novos nós em seu cluster acabem logo. O cluster do Kubernetes começará a funcionar cada vez mais devagar.
Mas eu decidi ir ainda mais longe. Como você sabe, no Kubernetes há algo que se chama serviço. E, por padrão, em seus clusters, o serviço provavelmente funciona com tabelas IP.
Se eu lançar bilhões de Pods, por exemplo, e depois usar um script para fazer o Kubernetes criar novos serviços:
for i in {1..1111111}; do
    kubectl expose deployment test --port 80
        --overrides="{"apiVersion": "v1",
           "metadata": {"name": "nginx$i"}}";
done
Em todos os nós do cluster, aproximadamente ao mesmo tempo, novas regras de iptables estarão sendo geradas. E para cada serviço, serão geradas um bilhão de regras de iptables.
Eu testei tudo isso com alguns milhares, até uma dezena. E o problema é que, já nessa quantidade, conectar via ssh a um nó se torna bastante problemático. Porque os pacotes, ao passar por tantas cadeias, começam a ter um desempenho ruim.
E isso também é resolvido com o Kubernetes. Existe um objeto chamado Resource quota. Ele estabelece a quantidade de recursos e objetos disponíveis para um namespace no cluster. Podemos criar um objeto YAML em cada namespace do cluster Kubernetes. Com esse objeto, podemos dizer que para este namespace foram alocados uma certa quantidade de requisições, limites, e depois podemos dizer que neste namespace é possível criar 10 serviços e 10 pods. E o desenvolvedor pode ficar à vontade à noite. O Kubernetes dirá a ele: "Não é possível escalar seus pods para tal quantidade, porque excede a cota de recursos." Pronto, problema resolvido. .
Um problema surge a partir disso. Você sente como se fosse difícil criar um namespace no Kubernetes. Para criá-lo, precisamos considerar uma série de fatores.
Resource quota + Limit Range + RBAC
• Criamos um namespace
• Criamos um limitrange dentro dele
• Criamos um resourcequota dentro dele
• Criamos um serviceaccount para CI
• Criamos um rolebinding para CI e usuários
• Opcionalmente, iniciamos os pods de serviço necessários
Portanto, aproveitando a oportunidade, gostaria de compartilhar meus desenvolvimentos. Existe uma ferramenta chamada operador SDK. Esse é um modo de escrever operadores para o cluster Kubernetes. Você pode escrever operadores com o Ansible.
Primeiro nós escrevemos em Ansible, e depois eu percebi que existe o operador SDK e reescrevi a função do Ansible como um operador. Esse operador permite criar um objeto no cluster Kubernetes que é chamado de comando. Dentro do comando, permite descrever em YAML o ambiente para esse comando, e dentro do ambiente do comando permite descrever que estamos alocando certos recursos.
Pequeno .
E em conclusão. O que fazer com tudo isso?
Primeiro. Pod Security Policy — isso é bom. E apesar de nenhum dos instaladores do Kubernetes usar isso até hoje, ainda assim é necessário utilizá-los em seus clusters.
Network Policy — isso não é mais uma funcionalidade desnecessária. É algo realmente necessário no cluster.
LimitRange/ResourceQuota — já está na hora de usá-los. Já estamos utilizando isso há um bom tempo, e eu estava convencido de que todo mundo aplicava isso. Acontece que é uma raridade.
Além do que mencionei durante a apresentação, existem recursos não documentados que permitem atacar o cluster. Recentemente foi divulgado .
Algumas coisas são tão tristes e frustrantes. Como, por exemplo, em certas condições, os kubelets no cluster do Kubernetes podem revelar o conteúdo do diretório de warlocks, e isso para um usuário não autorizado.
existem instruções sobre como reproduzir tudo o que falei. Há arquivos com exemplos de produção, como ResourceQuota e Pod Security Policy. E tudo isso pode ser testado.
Obrigado a todos.
Fonte: habr.com
