

Resumo: O JSONB pode simplificar significativamente o desenvolvimento de esquemas de banco de dados sem comprometer o desempenho das consultas.
Introdução
Vamos apresentar um exemplo clássico, talvez um dos mais antigos usos em bancos de dados relacionais: temos uma entidade e precisamos armazenar certas propriedades (atributos) dessa entidade. No entanto, nem todas as instâncias podem ter o mesmo conjunto de propriedades, além disso, no futuro, pode haver a necessidade de adicionar mais propriedades.
A maneira mais simples de resolver esse problema é criar uma coluna na tabela do banco de dados para cada valor de propriedade e preencher apenas aquelas que são necessárias para uma determinada instância da entidade. Ótimo! Problema resolvido… até o momento em que sua tabela contém milhões de registros e você precisa adicionar uma nova entrada.
Vamos considerar o padrão EAV (), que aparece com bastante frequência. Uma tabela contém as entidades (registros), outra tabela contém os nomes das propriedades (atributos) e a terceira tabela conecta as entidades aos seus atributos e armazena os valores desses atributos para a entidade atual. Isso permite ter diferentes conjuntos de propriedades para diferentes objetos, bem como adicionar propriedades “em tempo real”, sem alterar a estrutura do banco de dados.
No entanto, eu não escreveria esta nota se não houvesse desvantagens na abordagem usando EAV. Por exemplo, para recuperar uma ou mais entidades que têm um atributo é necessário realizar 2 joins na consulta: o primeiro - junção com a tabela de atributos, o segundo - junção com a tabela de valores. Se a entidade tiver 2 atributos, então já são necessários 4 joins! Além disso, todos os atributos são geralmente armazenados como strings, o que leva a conversões de tipos, tanto para o resultado quanto para a condição WHERE. Se você escreve muitas consultas, isso é bastante dispendioso do ponto de vista do uso de recursos.
Apesar dessas desvantagens óbvias, o EAV é utilizado há muito tempo para resolver esse tipo de problema. Essas desvantagens eram inevitáveis, e não havia uma alternativa melhor.
Mas então surgiu uma nova "tecnologia" no PostgreSQL...
A partir do PostgreSQL 9.4, foi adicionado o tipo de dado JSONB para armazenamento de dados JSON em formato binário. Embora armazenar JSON nesse formato geralmente ocupe um pouco mais de espaço e tempo do que o JSON simples em texto, a execução de operações com ele ocorre de maneira muito mais rápida. Além disso, o JSONB suporta indexação, o que torna as consultas ainda mais rápidas.
O tipo de dado JSONB nos permite substituir o padrão EAV complexo ao adicionar apenas uma coluna JSONB à nossa tabela de entidades, simplificando significativamente o design do banco de dados. No entanto, muitos afirmam que isso deve ser acompanhado por uma redução no desempenho… É por isso que este artigo surgiu.
Configuração do banco de dados de teste
Para esta comparação, criei um banco de dados em uma nova instalação do PostgreSQL 9.5 em uma configuração de 80 dólares Ubuntu 14.04. Depois de ajustar algumas configurações no postgresql.conf, executei um script usando psql. Para representar os dados no formato EAV, as seguintes tabelas foram criadas:
CREATE TABLE entity (
  id           SERIAL PRIMARY KEY,
  name         TEXT,
  description  TEXT
);
CREATE TABLE entity_attribute (
  id          SERIAL PRIMARY KEY,
  name        TEXT
);
CREATE TABLE entity_attribute_value (
  id                  SERIAL PRIMARY KEY,
  entity_id           INT    REFERENCES entity(id),
  entity_attribute_id INT    REFERENCES entity_attribute(id),
  value               TEXT
);
Abaixo está a tabela onde os mesmos dados serão armazenados, mas com atributos na coluna do tipo JSONB – properties.
CREATE TABLE entity_jsonb (
  id          SERIAL PRIMARY KEY,
  name        TEXT,
  description TEXT,
  properties  JSONB
);
Parece muito mais simples, não é? Em seguida, foram adicionados 10 milhões de registros às tabelas de entidades (entity & entity_jsonb) e, consequentemente, as tabelas que utilizam o padrão EAV e a abordagem com a coluna JSONB foram preenchidas com os mesmos dados – entity_jsonb.properties. Assim, obtivemos vários tipos diferentes de dados entre todo o conjunto de propriedades. Exemplo de dados:
{
  id:          1
  name:        "Entity1"
  description: "Entidade de teste nº 1"
  properties:  {
    color:        "red"
    length:       120
    width:        3.1882420
    hasSomething: true
    country:      "Belgium"
  }
}
Então, agora temos dados idênticos para duas opções. Vamos começar a comparar as implementações em ação!
Simplificação do design
Já foi mencionado que o design do banco de dados foi significativamente simplificado: uma tabela, devido ao uso da coluna JSONB para propriedades, em vez de usar três tabelas para EAV. Mas como isso reflete nas consultas? A atualização de uma propriedade da entidade se parece com isto:
-- EAV
UPDATE entity_attribute_value
SET value = 'azul'
WHERE entity_attribute_id = 1
  AND entity_id = 120;

-- JSONB
UPDATE entity_jsonb
SET properties = jsonb_set(properties, '{"color"}', '"azul"')
WHERE id = 120;
Como vemos, a última consulta não parece mais simples. Para atualizar o valor de uma propriedade em um objeto JSONB, precisamos usar a função , e devemos passar nosso novo valor como um objeto JSONB. No entanto, não precisamos saber nenhum identificador com antecedência. Olhando para o exemplo com EAV, precisamos saber tanto entity_id quanto entity_attribute_id para realizar a atualização. Se você deseja atualizar uma propriedade na coluna JSONB com base no nome do objeto, isso é feito em uma única linha simples.
Agora vamos selecionar a entidade que acabamos de atualizar, com base em sua nova cor:
-- EAV
SELECT e.name
FROM entity e
  INNER JOIN entity_attribute_value eav ON e.id = eav.entity_id
  INNER JOIN entity_attribute ea ON eav.entity_attribute_id = ea.id
WHERE ea.name = 'color' AND eav.value = 'azul';

-- JSONB
SELECT name
FROM entity_jsonb
WHERE properties ->> 'color' = 'azul';
Acredito que podemos concordar que a segunda é mais curta (sem join!), e consequentemente mais legível. Aqui o JSONB vence! Estamos usando o operador JSON ->> para obter a cor como um valor de texto do objeto JSONB. Também existe uma segunda maneira de alcançar o mesmo resultado no modelo JSONB usando o operador @>:
-- JSONB
SELECT name
FROM entity_jsonb
WHERE properties @> '{"color": "azul"}';
Isso é um pouco mais complicado: verificamos se o objeto JSON na coluna de propriedades contém o objeto à direita do operador @>. Menos legível, mas mais performático (veja adiante).
Vamos simplificar ainda mais o uso de JSONB quando você precisa selecionar várias propriedades ao mesmo tempo. É aqui que a abordagem JSONB realmente se destaca: simplesmente selecionamos as propriedades como colunas adicionais no nosso conjunto de resultados sem necessidade de junções:
-- JSONB
SELECT name
  , properties ->> 'color'
  , properties ->> 'country'
FROM entity_jsonb
WHERE id = 120;
Com EAV, você precisará de 2 junções para cada propriedade que deseja consultar. Na minha opinião, as consultas acima mostram uma grande simplificação no design do banco de dados. Você pode ver mais exemplos de como escrever consultas para JSONB também em um post.
Agora é hora de falar sobre desempenho.
Desempenho
Para comparar o desempenho, eu usei nas consultas, para calcular o tempo de execução. Cada consulta foi executada pelo menos três vezes, pois na primeira vez o planejador de consultas leva mais tempo. Primeiro, executei as consultas sem nenhum índice. Obviamente, isso beneficiou o JSONB, já que os joins necessários para o EAV não podiam usar índices (os campos de chave estrangeira não eram indexados). Depois disso, criei um índice para 2 colunas de chaves estrangeiras na tabela de valores EAV, além de um índice para a coluna JSONB.
As atualizações de dados mostraram os seguintes resultados em termos de tempo (em ms). Observe que a escala é logarítmica:
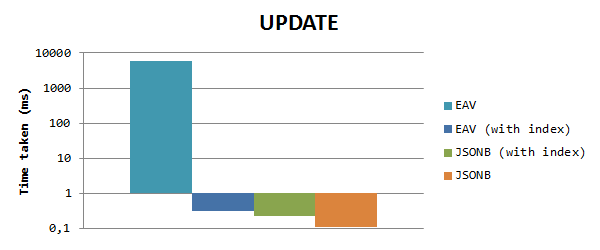
Podemos ver que o JSONB é muito (> 50000x) mais rápido que o EAV, se não usarmos índices, devido ao motivo mencionado acima. Quando indexamos colunas com chaves primárias, a diferença quase desaparece, mas o JSONB ainda é 1,3 vezes mais rápido que o EAV. Observe que o índice na coluna JSONB aqui não tem efeito, já que não estamos utilizando a coluna de propriedades nos critérios de avaliação.
Para selecionar dados com base no valor da propriedade, obtemos os seguintes resultados (escala comum):
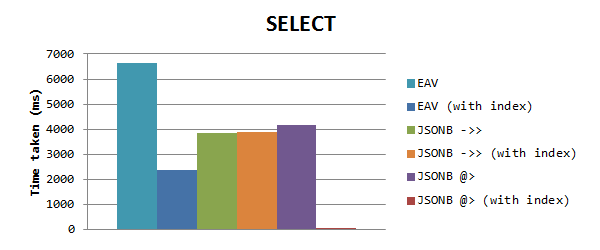
Pode-se notar que o JSONB novamente funciona mais rápido que o EAV sem índices, mas quando o EAV tem índices, ele ainda funciona mais rápido que o JSONB. Mas depois percebi que o tempo para as consultas JSONB era o mesmo, isso me levou à conclusão de que o índice GIN não estava sendo acionado. Aparentemente, quando você usa um índice GIN para uma coluna com propriedades preenchidas, ele só funciona ao usar o operador de inclusão @>. Eu usei isso em um novo teste, o que teve um impacto enorme no tempo: apenas 0,153 ms! Isso é 15000 vezes mais rápido que o EAV, e 25000 vezes mais rápido que o operador ->>.
Acho que isso foi rápido o suficiente!
Tamanhos das tabelas do banco de dados
Vamos comparar os tamanhos das tabelas com ambas as abordagens. No psql, podemos mostrar o tamanho de todas as tabelas e índices com o comando dti+
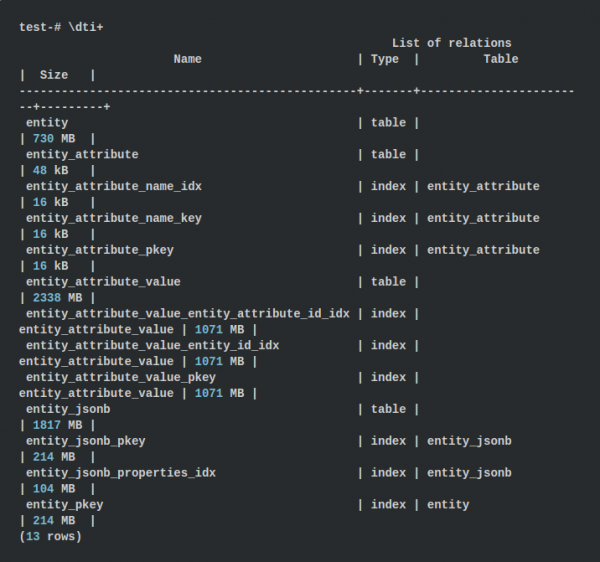
Para a abordagem EAV, os tamanhos das tabelas são cerca de 3068 MB, e os índices até 3427 MB, totalizando 6,43 GB. Ao usar a abordagem com JSONB, utiliza-se 1817 MB para a tabela e 318 MB para os índices, totalizando 2,08 GB. Isso resulta em 3 vezes menos! Este fato me surpreendeu um pouco, pois armazenamos os nomes das propriedades em cada objeto JSONB.
Mas os números falam por si: no EAV, armazenamos 2 chaves externas inteiras para o valor do atributo, resultando em 8 bytes de dados adicionais. Além disso, no EAV, todos os valores das propriedades são armazenados como texto, enquanto o JSONB usará valores numéricos e lógicos quando possível, resultando em um volume menor.
Resultados
No geral, acredito que armazenar as propriedades das entidades no formato JSONB pode simplificar significativamente o design e a manutenção do seu banco de dados. Se você realiza muitas consultas, tudo que está armazenado em uma tabela com a entidade realmente funcionará de forma mais eficiente. E o fato de que isso simplifica a interação entre os dados já é um benefício, mas o banco de dados resultante é 3 vezes menor em volume.
Além disso, com base nos testes realizados, é possível concluir que as perdas de desempenho são muito insignificantes. Em alguns casos, o JSONB pode até operar mais rápido que o EAV, o que o torna ainda melhor. No entanto, esse teste de referência, é claro, não abrange todos os aspectos (por exemplo, entidades com um número muito grande de propriedades, aumento significativo no número de propriedades dos dados existentes,...), portanto, se você tiver sugestões sobre como aprimorar isso, fique à vontade para deixar nos comentários!
Fonte: habr.com
