

Em 2010, a empresa tinha 50 servidores e um modelo de rede simples: backend, frontend e firewall. O número de servidores crescia, o modelo se tornava mais complexo: stágios, VLANs isoladas com ACL, depois VPN com VRF, VLAN com ACL no L2, VRF com ACL no L3. Ficou confuso? O que vem a seguir será ainda mais interessante.
Quando o número de servidores atingiu 16.000, ficou impossível operar sem dificuldades com tantos segmentos heterogêneos. Por isso, foi encontrada uma solução diferente. Usou-se a pilha Netfilter, adicionou-se o Consul como fonte de dados, resultando em um firewall distribuído rápido. Ele substituiu as ACL nos roteadores e foi utilizado como firewall externo e interno. Para um gerenciamento dinâmico da ferramenta, foi desenvolvida a sistema BEFW, aplicada em todos os lugares: desde o gerenciamento de acesso de usuários na rede de produtos até a isolação dos segmentos de rede entre si.
Como tudo isso funciona e por que você deve considerar esse sistema, será explicado por Ivan Agarov () — líder do grupo de segurança da infraestrutura na divisão de Manutenção do centro de desenvolvimento de Minsk da empresa. Ivan é fã do SELinux, adora Perl e escreve código. Como líder do grupo de segurança, trabalha regularmente com logs, backups e P&D para proteger a Wargaming de hackers e garantir o funcionamento de todos os servidores de jogos da empresa.
Histórico
Antes de explicar como fizemos isso, contarei como chegamos a isso e por que era necessário. Para isso, retrocedamos 9 anos: 2010, quando apenas surgiram os World of Tanks. A Wargaming tinha cerca de 50 servidores.
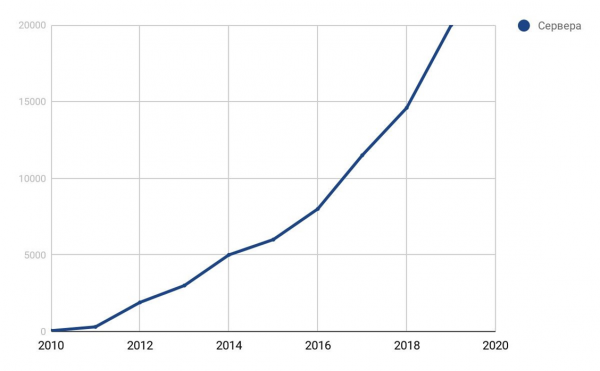
Gráfico de crescimento dos servidores da empresa.
Tínhamos um modelo de rede. Para aquela época, era o ideal.
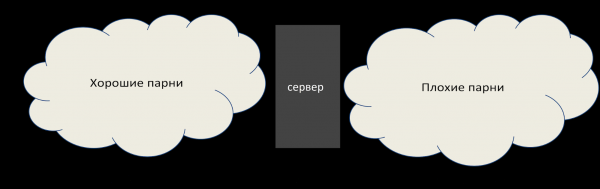
Modelo de rede em 2010.
No frontend habitam os vilões que querem nos derrubar, mas há um firewall. No backend, não há firewall, mas há 50 servidores, e conhecemos todos eles. Tudo funciona bem.
Em 4 anos, o parque de servidores cresceu 100 vezes, chegando a 5.000. Surgiram as primeiras redes isoladas — estágios: elas não podem acessar a produção, e frequentemente havia o que poderia ser perigoso.
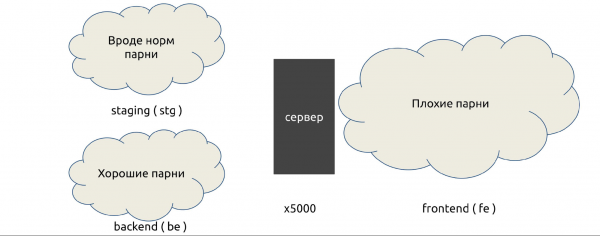
Modelo de rede em 2014.
Por inércia, continuamos a usar o mesmo hardware, e todo o trabalho era realizado em VLANs isoladas: as VLANs tinham ACLs que permitem ou proíbem alguma conexão.
Em 2016, o número de servidores atingiu 8000. A Wargaming adquiriu outros estúdios e surgiram redes de parceiros adicionais. Eles parecem nossos, mas não são bem: para os parceiros, o VLAN muitas vezes não funciona, é necessário usar VPN com VRF, as isolamentos tornam-se complicadas. A mistura de isolamentos ACL aumentou.
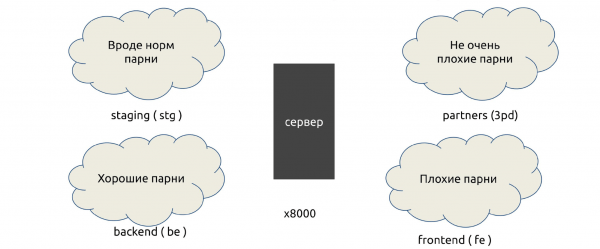
Modelo de rede em 2016.
No início de 2018, a frota de máquinas cresceu para 16.000. Havia 6 segmentos, e os demais não eram contabilizados, incluindo os fechados, onde eram armazenados dados financeiros. Surgiram redes de contêineres (Kubernetes), DevOps, redes em nuvem conectadas via VPN, por exemplo, de IVC. Havia muitas regras — era doloroso.
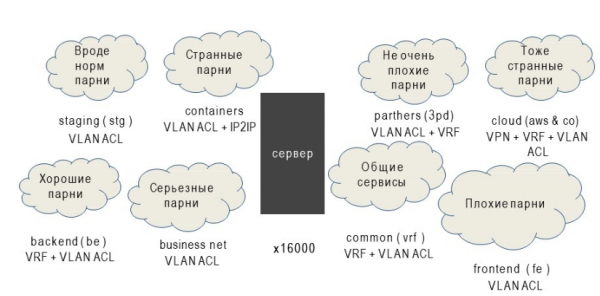
Modelo de rede e métodos de isolamento em 2018.
Para isolamento, usamos: VLAN com ACL em L2, VRF com ACL em L3, VPN e muitas outras coisas. Eram muitas.
Problemas
Todos vivem com ACL e VLAN. O que está errado? Essa pergunta será respondida por Harold, que esconde a dor.
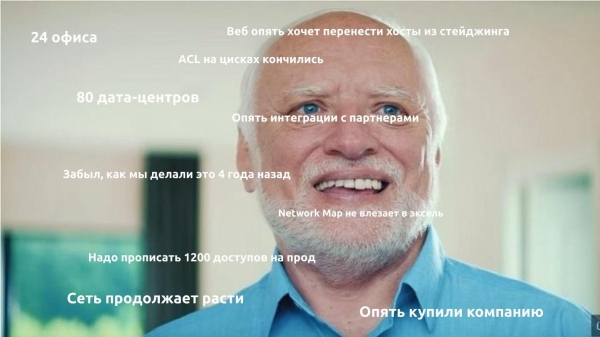
Havia muitos problemas, mas em massa — cinco.
- Crescimento geométrico do preço para novas regras.. Cada nova regra levava mais tempo para ser adicionada do que a anterior, porque era necessário primeiro verificar se já não havia uma regra semelhante.
- Não havia firewall dentro dos segmentos.. Os segmentos foram de alguma forma separados entre si, mas internamente já não havia recursos suficientes.
- As regras eram aplicadas lentamente. Um operador poderia escrever uma regra local manualmente em uma hora. A global levava alguns dias.
- Dificuldades com a auditoria de regras.. Na verdade, ela era impossível. As primeiras regras foram escritas em 2010, e a maior parte de seus autores já não trabalhava na empresa.
- Baixo nível de controle sobre a infraestrutura.. Este é o maior problema — não sabíamos bem o que estava acontecendo conosco.
Assim era o engenheiro de rede em 2018, quando ouvia: 'Precisamos de mais algumas ACL.'
Soluções
No início de 2018, foi decidido fazer algo a respeito.
O preço das integrações cresce continuamente. O ponto de partida foi que grandes data centers pararam de suportar VLAN e ACL isoladas, porque a memória dos dispositivos havia se esgotado.
Solução: eliminou-se o fator humano e automatizou-se ao máximo a concessão de acesso.
Novas regras são aplicadas lentamente. Solução: acelerar a aplicação das regras, torná-la distribuída e paralela. Para isso, é necessário um sistema distribuído, de modo que as regras sejam entregues sozinhas, sem rsync ou SFTP em mil sistemas.
Ausência de firewall dentro dos segmentos. O firewall dentro dos segmentos começou a nos impactar quando diferentes serviços surgiram dentro de uma mesma rede. Solução: usar um firewall em nível de host — firewalls baseados em host. Praticamente em todos os lugares utilizamos Linux, e em todos eles existe iptables, não é um problema.
Dificuldades com a auditoria das regras. Solução: armazenar todas as regras em um único local para revisão e gerenciamento, assim poderemos auditar tudo.
Baixo nível de controle sobre a infraestrutura. Solução: realizar um inventário de todos os serviços e acessos entre eles.
Esse é um processo mais administrativo do que técnico. Às vezes temos de 200 a 300 novos lançamentos por semana, especialmente durante promoções e feriados. Isso é apenas para uma equipe de DevOps. Com esse número de lançamentos, é impossível entender quais portas, IPs e integrações são necessárias. Portanto, precisamos de gerentes de serviço especialmente treinados que interrogam as equipes: "O que há e por que vocês levantaram isso?"
Depois de tudo que lançamos, o engenheiro de rede em 2019 já parecia assim.
Consul
Decidimos que tudo o que encontramos com a ajuda dos gerentes de serviço seria colocado no Consul e de lá escreveremos as regras iptables.
Como decidimos fazer isso?
- Reuniremos todos os serviços, redes e usuários.
- Faremos regras iptables com base neles.
- Automatizaremos o controle.
- ….
- PROFIT.
Consul não é uma API remota, ele pode funcionar em cada nó e escrever em iptables. Resta apenas criar meios automáticos de controle que irão eliminar o que não é necessário, e assim a maior parte dos problemas será resolvida! O restante será ajustado no processo.
Por que Consul?
Tem se mostrado eficaz. Nos anos de 2014-15, o utilizamos como backend para o Vault, onde armazenamos senhas.
Não perde dados. Durante o uso do Consul, não houve perda de dados em nenhum acidente. Isso é um grande ponto positivo para o sistema de gerenciamento de firewall.
Conexões P2P aceleram a disseminação das mudanças. Com P2P, todas as mudanças são rápidas, não é necessário esperar horas.
API REST conveniente. Consideramos também o Apache ZooKeeper, mas ele não tem API REST, será necessário construir gambiarras.
Funciona tanto como armazenamento de chaves (KV) quanto como catálogo (Serviço de Descoberta). É possível armazenar serviços, diretórios e data centers ao mesmo tempo. Isso é conveniente não apenas para nós, mas também para equipes vizinhas, pois ao construir um serviço global, pensamos em grande.
Escrito em Go, que faz parte da stack da Wargaming. Amamos esta linguagem, temos muitos desenvolvedores Go.
Sistema de ACL poderoso. Com o Consul, a ACL permite gerenciar quem pode escrever e o que pode ser escrito. Garantimos que as regras do firewall não se sobreponham a mais nada e não teremos problemas com isso.
Mas o Consul também tem desvantagens.
- Não se escala dentro do data center, a menos que você tenha a versão empresarial. Ele se escala apenas através de federação.
- Muito dependente da qualidade da rede e da carga dos servidores. O Consul não funcionará adequadamente como servidor em um servidor sobrecarregado se houver lag na rede, por exemplo, velocidade irregular. Isso está relacionado às conexões P2P e aos modelos de distribuição de atualizações.
- Dificuldades com a monitorização da disponibilidade. O status do Consul pode indicar que tudo está bem, mas ele já está fora do ar há muito tempo.
A maior parte desses problemas resolvemos durante a operação do Consul, por isso decidimos por ele. A empresa tem planos para um backend alternativo, mas aprendemos a lidar com os problemas e por enquanto estamos vivendo com o Consul.
Como o Consul funciona
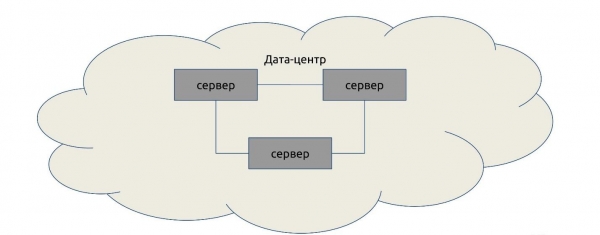
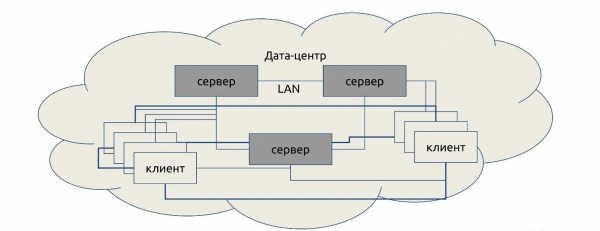
Vamos instalar servidores em um data center hipotético — entre três e cinco. Um ou dois servidores não servem: eles não conseguirão estabelecer um quórum e decidir quem está certo, quem está errado quando os dados não coincidem. Mais de cinco não faz sentido, a performance cairá.
Os clientes se conectam aos servidores em qualquer ordem: são os mesmos agentes, apenas com a flag server = false.
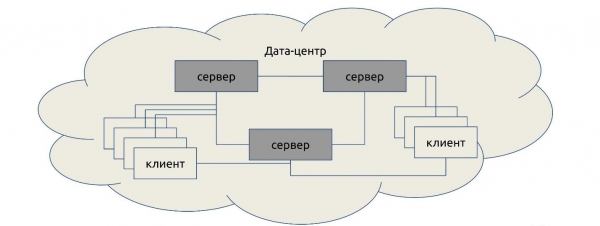
Depois disso, os clientes recebem uma lista de conexões P2P e estabelecem vínculos entre si.
Em nível global, conectamos vários data centers entre si. Eles também se conectam P2P e se comunicam.
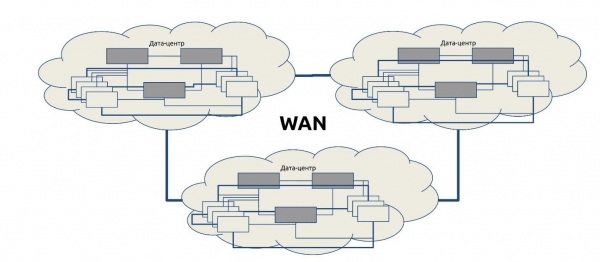
Quando queremos obter dados de outro data center, a solicitação vai de servidor para servidor. Esse modelo é chamado de protocolo Serf. O protocolo Serf, assim como o Consul, é uma criação da HashiCorp.
Alguns fatos importantes sobre o Consul
O Consul possui documentação descrevendo seu funcionamento. Vou listar apenas alguns fatos selecionados que vale a pena saber.
Os servidores Consul escolhem um mestre entre os votantes. O Consul seleciona um mestre da lista de servidores para cada data center, e todas as solicitações vão apenas para ele, independentemente do número de servidores. A falha do mestre não resulta em novas eleições. Se um mestre não for escolhido, as solicitações não são atendidas.
Você queria escalabilidade horizontal? Desculpe, não.
A solicitação de um data center diferente vai de mestre a mestre, independentemente do servidor em que chegou. O mestre escolhido recebe 100% da carga, exceto a carga de encaminhamento de solicitações. A cópia atual dos dados está disponível em todos os servidores do data center, mas apenas um responde.
A única forma de escalar é ativar o modo stale no cliente.
No modo stale, é possível responder sem quórum. Este é um modo em que abrimos mão da consistência dos dados, mas lemos um pouco mais rápido do que o normal, e qualquer servidor pode responder. Naturalmente, a gravação deve ser feita apenas através do mestre.
O Consul não copia dados entre data centers.Ao coletar a federação, cada servidor terá apenas seus próprios dados. Para outros, sempre consultará alguém diferente.
A atomicidade das operações não é garantida fora de uma transação.Lembre-se de que você não é o único que pode modificar algo. Se quiser fazer de outra forma, realize a transação com bloqueio.
Operações bloqueantes não garantem bloqueio.A solicitação vai de mestre a mestre, e não diretamente, portanto não há garantias de que o bloqueio funcione quando você o aplica, por exemplo, em outro data center.
ACL também não garante acesso (em muitos casos).O ACL pode não funcionar porque é armazenado em um único data center da federação — no data center ACL (DC Primário). Se o DC não responder, o ACL não funcionará.
Um mestre travado resultará na paralisação de toda a federação.Por exemplo, em uma federação com 10 data centers, se um tiver uma rede ruim e um mestre falhar. Todos que se comunicam com ele ficarão presos em um ciclo: uma solicitação é feita, não há resposta, a thread fica travada. Não é possível prever quando isso acontecerá, simplesmente em uma ou duas horas toda a federação vai falhar. Você não poderá fazer nada a respeito.
O status, o quórum e as eleições são processados por uma thread separada. Não haverá reeleições, o status não mostrará nada. Você pode pensar que seu Consul está vivo, fazer uma consulta e nada acontece — não há resposta. No entanto, o status mostra que está tudo bem.
Já encontramos esse problema, tivemos que reconstruir partes específicas dos data centers para evitá-lo.
Na versão de negócios, o Consul Enterprise não possui algumas das desvantagens mencionadas acima.Tem muitas funções úteis: seleção de votantes, distribuição, escalonamento. Há apenas um "mas" — o sistema de licenciamento para o sistema distribuído é muito caro.
Dica: rm -rf /var/lib/consul — a cura para todos os problemas do agente. Se algo não estiver funcionando, basta excluir seus dados e carregar os dados de um backup. É muito provável que o Consul volte a funcionar.
BEFW
Agora vamos falar sobre o que adicionamos ao Consul.
— é um acrônimo de BackEndFireWall. Tive que dar um nome ao produto quando criei o repositório para armazenar os primeiros commits de teste. Esse nome permaneceu.
Modelos de regras
As regras são escritas na sintaxe do iptables.
- -N BEFW
- -P INPUT DROP
- -A INPUT -m state --state RELATED,ESTABLISHED -j ACCEPT
- -A INPUT -i lo -j ACCEPT
- -A INPUT -j BEFW
Tudo o que temos vai para a cadeia BEFW, exceto ESTABELECIDO, RELATED e localhost. O modelo pode ser qualquer um, este é apenas um exemplo.
Qual é a utilidade do BEFW?
Serviços
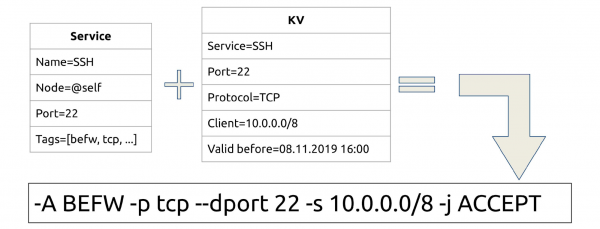
Temos um serviço, sempre há uma porta, o nó onde ele está funcionando. Podemos perguntar localmente ao agente do nosso nó e descobrir que há um serviço. Também é possível adicionar tags.
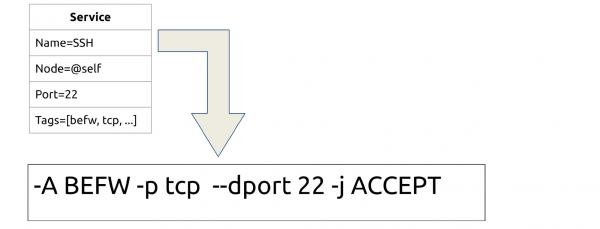
Qualquer serviço que está rodando e registrado no Consul se transforma em uma regra do iptables. Temos SSH — abrimos a porta 22. O script Bash é simples: curl e iptables, nada mais é necessário.
Clientes
Como abrir o acesso não para todos, mas de forma seletiva? Por nome do serviço, armazenar listas de IPs no armazenamento KV.
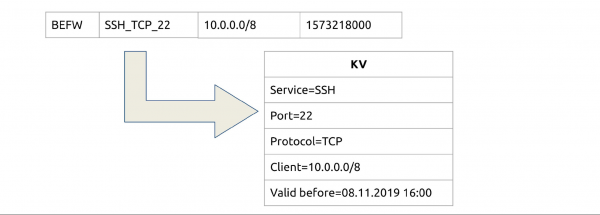
Por exemplo, queremos que todos da décima rede possam acessar o serviço SSH_TCP_22. Adicionamos um pequeno campo TTL? e agora temos permissões temporárias, por exemplo, para um dia.
Acessos
Conectamos serviços e clientes: temos um serviço, para cada um há um armazenamento KV pronto. Agora damos acesso não a todos, mas de forma seletiva.
Grupos
Se a cada vez tivermos que escrever milhares de IPs para acessos, ficaremos cansados. Vamos pensar em agrupamentos — um subconjunto separado no KV. Chamaremos de Alias (ou grupos) e armazenaremos lá grupos com o mesmo princípio.
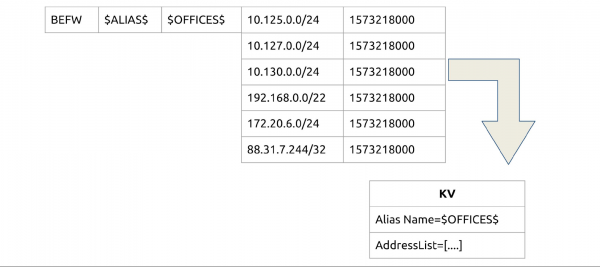
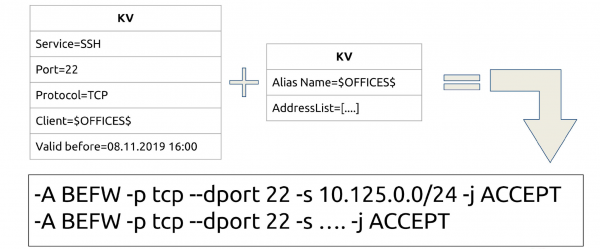
Conectamos: agora podemos abrir SSH não especificamente para P2P, mas para um grupo inteiro ou vários grupos. Da mesma forma, há TTL — podemos adicionar e remover temporariamente de um grupo.
Integração
Nosso problema é o fator humano e a automação. Por enquanto, resolvemos assim.
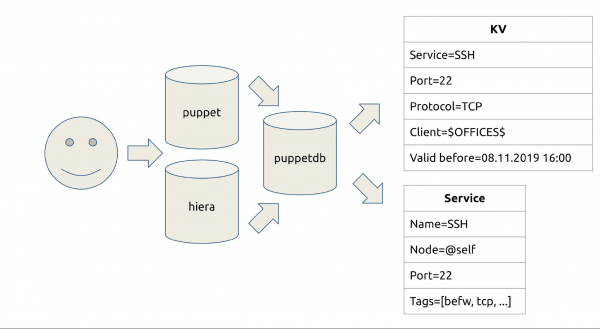
Trabalhamos com Puppet e transferimos tudo o que diz respeito ao sistema (código dos aplicativos). No puppetdb (um PostgreSQL comum) está armazenada a lista de serviços que estão em execução, que podem ser encontrados pelo tipo de recurso. Também é possível descobrir quem está acessando o quê. Além disso, temos um sistema de pull request e merge request para isso.
Criamos o befw-sync — uma solução simples que ajuda a transferir dados. Primeiro, os cookies de sincronização fazem uma chamada ao puppetdb. Lá, uma API HTTP está configurada: solicitamos quais serviços temos e o que precisa ser feito. Em seguida, fazemos uma solicitação ao Consul.
Há integração? Sim: escrevemos regras, permitimos aceitar Pull Requests. Precisa de alguma porta ou adicionar um host a algum grupo? Pull Request, revisão — nada de "Encontre 200 outras ACLs e tente fazer algo com isso".
Otimização
O ping para localhost com uma cadeia de regras vazia leva 0,075 ms.
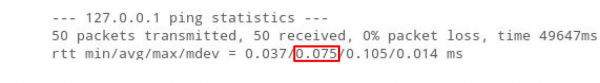
Vamos adicionar 10.000 endereços no iptables. Como resultado, o ping aumentará 5 vezes: o iptables é totalmente linear, o processamento de cada endereço leva algum tempo.
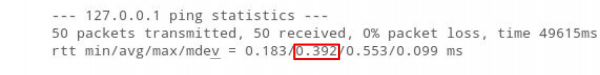
Para o firewall para o qual estamos migrando milhares de ACLs, temos muitas regras, e isso causa atraso. Para protocolos de jogos, isso é ruim.
Mas se colocarmos 10.000 endereços em ipset o ping até diminui.
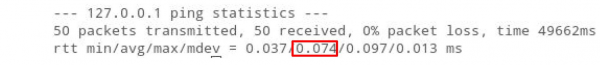
A questão é que "O" (complexidade do algoritmo) para o ipset é sempre igual a 1, não importa quantas regras existam. Na verdade, há uma limitação — não pode haver mais de 65.535 regras. Enquanto vivemos com isso: é possível combiná-las, expandir, criar dois ipsets em um.
Armazenamento
A continuação lógica do processo de iterações é armazenar informações sobre clientes para o serviço no ipset.
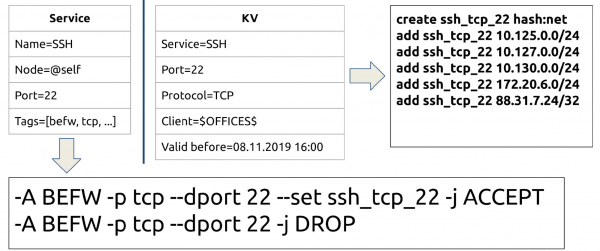
Agora temos o mesmo SSH, e não escrevemos imediatamente 100 IPs, mas informamos o nome do ipset com o qual precisamos interagir, e a próxima regra DROP. Pode ser feito como uma única regra "Quem não está aqui, é DROP", mas assim fica mais visual.
Agora temos regras e conjuntos. A principal tarefa é fazer o conjunto antes de escrever a regra, porque senão o iptables não registrará a regra.
Esquema geral
Em forma de diagrama, tudo o que falei se parece com isso.
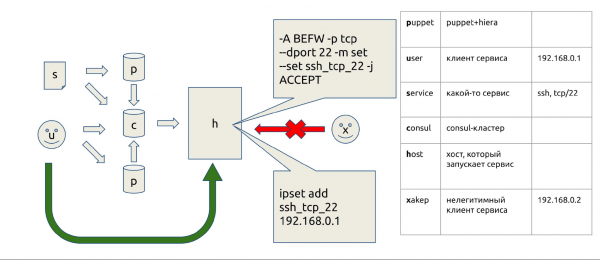
Fazemos commit no Puppet, tudo é enviado para o host, os serviços estão aqui, o ipset lá, e quem não estiver listado lá, não é admitido.
Permitir & negar
Para salvar o mundo rapidamente ou desconectar alguém rapidamente, no início de todas as cadeias, fizemos dois ipsets: rules_allow e rules_deny. Como funciona isso?
Por exemplo, alguém cria carga no nosso Web com bots. Anteriormente, era necessário encontrar o IP nos logs, enviar para os engenheiros de rede para que eles localizassem a origem do tráfego e o bloqueassem. Agora isso funciona de maneira diferente.
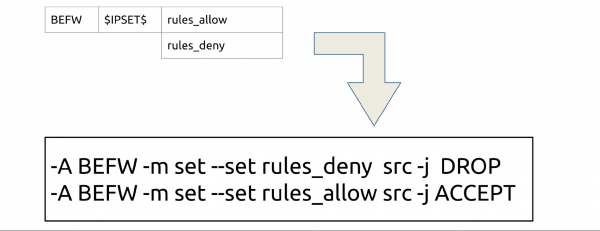
Enviamos para o Consul, aguardamos 2,5 s e está pronto. Como o Consul distribui rapidamente via P2P, funciona em qualquer lugar do mundo.
Uma vez eu parei completamente o WOT, errando na configuração do firewall. rules_allow — essa é a nossa proteção contra tais casos. Se cometemos algum erro no firewall e algo for bloqueado, sempre podemos enviar um 0.0/0, para rapidamente restaurar tudo. Depois, consertaremos tudo manualmente.
Outros conjuntos
É possível adicionar qualquer outro conjunto no espaço $IPSETS$.
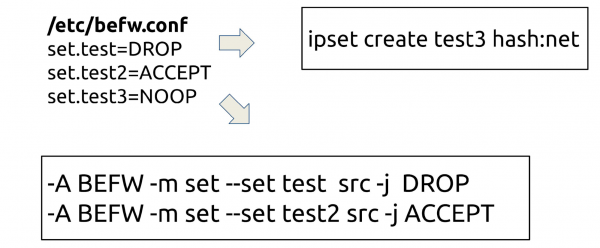
Por que? Às vezes, alguém precisa de ipset, por exemplo, para emular a desativação de alguma parte do cluster. Qualquer um pode trazer quaisquer conjuntos, nomeá-los e eles serão obtidos a partir do Consul. Além disso, os conjuntos podem participar das regras do iptables ou funcionar como um comando NOOP: a consistência será mantida pelo daemon.
Usuários
Antes era assim: o usuário se conectava à rede e recebia parâmetros através do domínio. Até o surgimento dos firewalls de nova geração, a Cisco não conseguia entender onde estava o usuário e onde estava o IP. Portanto, o acesso era concedido apenas através do hostname da máquina.
O que fizemos? Interceptamos o momento da obtenção do endereço. Normalmente, isso é dot1x, Wi-Fi ou VPN — tudo passa pelo RADIUS. Para cada usuário, criamos um grupo com o nome de usuário e colocamos nele o IP com TTL, equivalente ao seu dhcp.lease — assim que expirar, a regra desaparecerá.
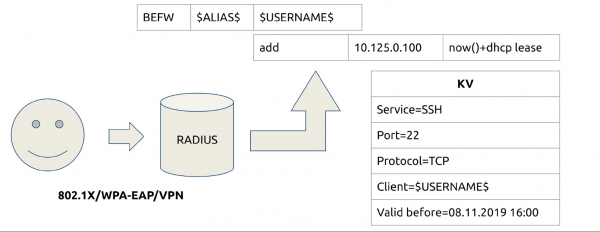
Agora podemos abrir o acesso a serviços, assim como em outros grupos, pelo nome de usuário. Eliminamos a dor com o hostname, quando eles mudam, e aliviamos a carga dos engenheiros de rede, porque eles não precisam mais da Cisco. Agora os engenheiros configuram os acessos em seus próprios servidores.
Isolamento
Paralelamente, começamos a trabalhar na isolação. Os gerentes de serviço fizeram um inventário, e nós analisamos todas as nossas redes. Vamos distribuí-las em grupos semelhantes, e nos servidores necessários adicionamos grupos, por exemplo, ao deny. Agora, a mesma isolamento de staging vai para rules_deny na produção, mas não na própria produção.
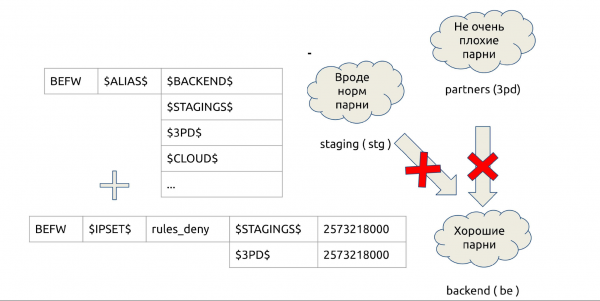
O esquema funciona de forma rápida e simples: removemos todos os ACL dos servidores, aliviamos o hardware e diminuímos a quantidade de VLANs isoladas.
Controle de integridade
Anteriormente, tínhamos um gatilho especial que avisava quando alguém mudava manualmente a regra do firewall. Eu escrevi um enorme linter para verificar as regras do firewall, foi complicado. Agora, a integridade é controlada pelo BEFW. Ele cuida com zelo para que as regras que ele cria não sejam alteradas. Se alguém mudar as regras do firewall, ele reverterá tudo. "Levantei rapidamente um proxy para trabalhar de casa" — essas opções não existem mais.
O BEFW controla o ipset dos serviços e a lista no befw.conf, as regras dos serviços na cadeia BEFW. Mas não monitora outras cadeias e regras e outros ipsets.
Proteção contra falhas
O BEFW sempre salva o último estado bem-sucedido diretamente na estrutura binária state.bin. Se algo sair errado, ele sempre reverte para esse state.bin.
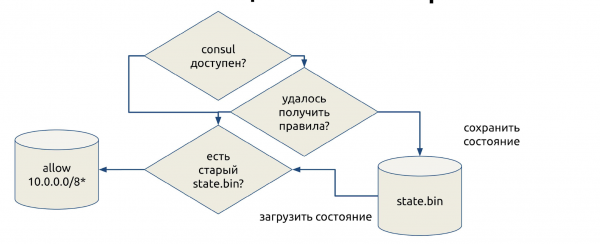
Isso é um seguro contra o funcionamento instável do Consul, quando ele não enviou os dados ou alguém cometeu um erro ao usar regras que não podem ser aplicadas. Para que não fiquemos sem firewall, o BEFW retornará ao último estado se ocorrer um erro em algum ponto.
Em situações críticas, isso é uma garantia de que permaneceremos com um firewall funcional. Abrimos todas as redes cinzas na esperança de que um administrador venha e conserte. Algum dia eu colocarei isso nas configurações, mas agora temos apenas três redes cinzas: 10/8, 172/12 e 192.168/16. Dentro do nosso Consul, essa é uma característica importante que ajuda a avançar.
Demonstração: durante a apresentação, Ivan demonstra o modo demo do BEFW. É mais fácil assistir à demonstração em . O código-fonte da demo está disponível .
Pontos críticos
Vou falar sobre os bugs que encontramos.
ipset add set 0.0.0.0/0. O que acontece se adicionarmos ao ipset 0.0.0.0/0? Todos os IPs serão adicionados? O acesso à internet será aberto?
Não, teremos um bug que nos custou duas horas de inatividade. E o bug não funciona desde 2016, está no RedHat Bugzilla sob o número #1297092, e o encontramos por acaso — a partir do relatório do desenvolvedor.
Agora no BEFW existe uma regra rígida que 0.0.0.0/0 se transforma em dois endereços: 0.0.0.0/1 e 128.0.0.0/1.
ipset restore set < file. O que o ipset faz quando você diz a ele restore? Вы думаете, он работает также, как iptables? Восстановит данные?
Nada disso — ele faz um merge, e os endereços antigos não desaparecem, você não fecha o acesso.
Encontramos o bug enquanto testávamos a isolação. Agora existe um sistema bastante complexo — em vez de restore é realizado create temp, depois restore flush temp e restore temp. No final, swap: para atomicidade, porque se primeiro fizer flush E nesse momento, se algum pacote chegar, ele será descartado e algo dará errado. Portanto, há um pouco de magia negra lá.
consul kv get -datacenter=outro. Como mencionei, achamos que estamos solicitando alguns dados, mas receberemos ou os dados ou um erro. Podemos fazer isso através do Consul localmente, mas nesse caso também travará ambos.
O cliente local do Consul é uma camada sobre a API HTTP. Mas ele simplesmente trava e não responde nem a Ctrl+C, nem a Ctrl+Z, nem a nada, apenas a kill -9 na console ao lado. Enfrentamos isso quando construímos um grande cluster. Mas ainda não temos uma solução, estamos nos preparando para corrigir esse erro no Consul.
O líder do Consul não responde. Nosso master no datacenter não está respondendo, pensamos: 'Provavelmente, agora o algoritmo de reeleição funcionará?'
Não, não funcionará, e a monitorização não mostrará nada: o Consul dirá que o índice de compromisso existe, o líder foi encontrado, tudo bem.
Como estamos lidando com isso? service consul restart no cron a cada hora. Se você tiver 50 servidores, não é um problema. Quando chegar a 16.000, você entenderá como isso funciona.
Conclusão
No final, obtivemos as seguintes vantagens:
- 100% de cobertura de todas as máquinas Linux.
- Velocidade.
- Automatização.
- Libertamos o hardware e os engenheiros de rede da escravidão.
- Surgiram oportunidades de integração que são praticamente ilimitadas: tanto com Kubernetes, quanto com Ansible, quanto com Python.
Desvantagens: Consul, com o qual agora temos que conviver, e um preço de erro muito alto. Como exemplo, uma vez, às 18h (horário nobre na Rússia), eu estava ajustando algumas listas de redes. Estávamos no meio da construção de isolamento na BEFW. Eu cometi um erro, parece que indiquei a máscara errada, mas tudo caiu em dois segundos. O monitoramento acende, o suporte corre: 'Está tudo fora do ar!' O chefe do departamento ficou grisalho ao explicar ao negócio porque isso aconteceu.
O custo do erro é tão alto que inventamos nosso próprio e complexo procedimento de prevenção. Se você for implementar isso em uma grande produção, não deve dar o token mestre do Consul a todos. Isso acabará mal.
Custo. Eu escrevi código por 400 horas sozinho. O suporte de minha equipe de 4 pessoas gasta 10 horas por mês com todos. Comparado ao custo de qualquer firewall de nova geração, isso é gratuito.
Planos. O plano de longo prazo é encontrar um transporte alternativo em vez de ou além do Consul. Talvez seja Kafka ou algo semelhante. Mas nos próximos anos, viveremos com o Consul.
Os próximos planos: integração com Fail2ban, monitoramento, nftables, e possivelmente com outras distribuições, métricas, monitoramento avançado, otimização. O suporte ao Kubernetes também está nos planos, pois atualmente temos alguns clusters e interesse.
Outros planos incluem:
- detecção de anomalias no tráfego;
- gerenciamento de mapa de rede;
- suporte ao Kubernetes;
- compilação de pacotes para todos os sistemas;
- Web-UI.
Estamos constantemente trabalhando na expansão da configuração, aumento das métricas e otimização.
Junte-se ao projeto. O projeto ficou incrível, mas, infelizmente, ainda é um projeto de uma só pessoa. Venha no e tente fazer algo: enviar um commit, testar, sugerir algo, dar sua avaliação.
Enquanto isso, estamos nos preparando para , que ocorrerá nos dias 6 e 7 de abril em São Petersburgo, e convidamos desenvolvedores de sistemas de alto desempenho . Os palestrantes experientes já sabem o que fazer, enquanto os novatos em apresentações recomendamos que pelo menos . A participação na conferência como palestrante tem várias vantagens. Para saber quais, você pode ler, por exemplo, no final .
Fonte: habr.com
