

Qualquer operação com grandes volumes de dados requer um grande poder de computação. O simples movimento de dados de um banco para o Hadoop pode demorar semanas ou custar o mesmo que uma asa de avião. Não quer esperar e gastar? Equilibre a carga em diferentes plataformas. Uma das maneiras é a otimização de pushdown.
Eu pedi ao principal treinador na Rússia em desenvolvimento e administração de produtos Informatica, Alexey Ananyev, para falar sobre a função de otimização de pushdown no Informatica Big Data Management (BDM). Você já aprendeu a trabalhar com produtos Informatica? Provavelmente, foi Alexey quem te ensinou os fundamentos do PowerCenter e explicou como construir mapeamentos.
Alexey Ananyev, chefe da área de treinamento da DIS Group
O que é pushdown?
Muitos de vocês já estão familiarizados com o Informatica Big Data Management (BDM). O produto é capaz de integrar grandes dados de diferentes fontes, movê-los entre sistemas diversos, garantir fácil acesso, permitir a profilagem e muito mais.
Em mãos habilidosas, o BDM pode fazer maravilhas: as tarefas serão executadas rapidamente e com o mínimo de recursos computacionais.
Você também quer isso? Aprenda a usar a função de pushdown no BDM para distribuir a carga computacional entre diferentes plataformas. A tecnologia de pushdown permite transformar um mapeamento em um script e escolher o ambiente onde esse script será executado. A possibilidade dessa escolha permite combinar os pontos fortes de diferentes plataformas e alcançar seu desempenho máximo.
Para configurar o ambiente de execução do script, é necessário escolher o tipo de pushdown. O script pode ser totalmente executado no Hadoop ou parcialmente distribuído entre a fonte e o receptor. Existem 4 tipos possíveis de pushdown. O mapeamento pode não ser transformado em script (native). O mapeamento pode ser executado principalmente na fonte (source) ou totalmente na fonte (full). Também pode-se transformar o mapeamento em script Hadoop (none).
Otimização de pushdown
Os 4 tipos mencionados podem ser combinados de diferentes maneiras – otimizar o pushdown para atender às necessidades específicas do sistema. Por exemplo, muitas vezes é mais razoável extrair dados de um banco de dados, aproveitando suas próprias capacidades. E transformar os dados – pelas forças do Hadoop, para não sobrecarregar o próprio banco.
Vamos considerar um caso em que tanto a fonte quanto o receptor estão no banco de dados, e a plataforma de execução das transformações pode ser escolhida: dependendo das configurações, isso será Informática, servidor de banco de dados ou Hadoop. Este exemplo permitirá entender melhor o lado técnico do funcionamento desse mecanismo. Naturalmente, na vida real, tal situação não ocorre, mas para demonstrar a funcionalidade, ela é a mais adequada.
Vamos trabalhar com o mapeamento para leitura de duas tabelas em um único banco de dados Oracle. E os resultados da leitura devem ser gravados em uma tabela no mesmo banco. O esquema do mapeamento será o seguinte:
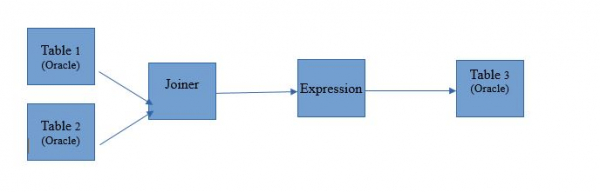
Na forma de mapeamento no Informatica BDM 10.2.1, isso se apresenta da seguinte forma:
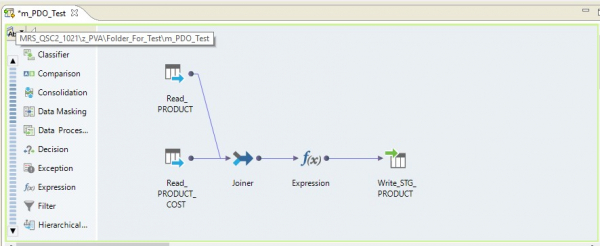
Tipo pushdown – nativo
Se escolhermos o tipo pushdown nativo, o mapeamento será executado no servidor Informatica. Os dados serão lidos do servidor Oracle, transferidos para o servidor Informatica, transformados lá e enviados para o Hadoop. Em outras palavras, teremos um processo ETL convencional.
Tipo pushdown – origem
Ao escolher o tipo origem, obtemos a possibilidade de distribuir nosso processo entre servidor bancos de dados (BD) e Hadoop. Ao executar o processo com essa configuração, as consultas de seleção de dados das tabelas serão enviadas para o banco. O restante será executado em etapas no Hadoop.
O esquema de execução será assim:
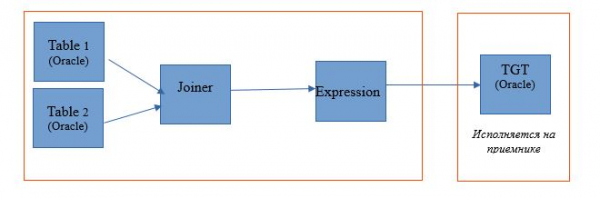
Abaixo está um exemplo de configuração do ambiente de execução.
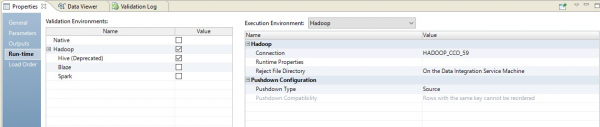
Neste caso, o mapeamento será executado em duas etapas. Em suas configurações, veremos que ele se transformou em um script que será enviado para a fonte. Além disso, a junção de tabelas e a transformação de dados será executada na forma de uma consulta redefinida na fonte.
Na imagem abaixo, vemos um mapeamento otimizado no BDM, e na fonte – uma consulta redefinida.
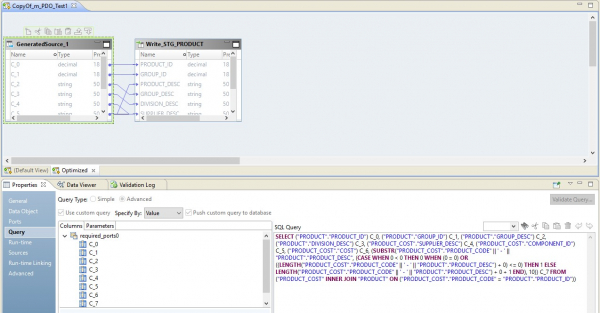
O papel do Hadoop nesta configuração será gerenciar o fluxo de dados – dirigi-los. O resultado da consulta será enviado para o Hadoop. Após a conclusão da leitura, um arquivo do Hadoop será gravado no receptor.
Tipo pushdown – completo
Ao escolher o tipo completo, o mapeamento se transforma completamente em uma consulta no banco de dados. E o resultado da consulta será enviado para o Hadoop. O esquema desse processo está apresentado abaixo.
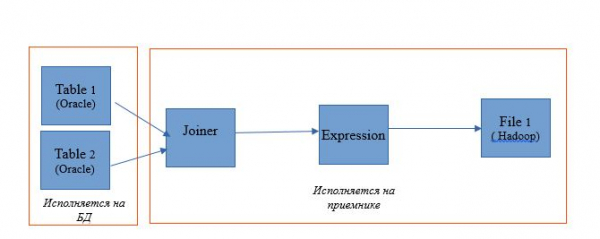
O exemplo de configuração é apresentado abaixo.
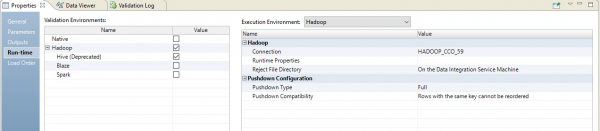
Como resultado, obteremos um mapeamento otimizado semelhante ao anterior. A única diferença é que toda a lógica é transferida para o receptor na forma de uma redefinição de sua inserção. Um exemplo de mapeamento otimizado é apresentado abaixo.
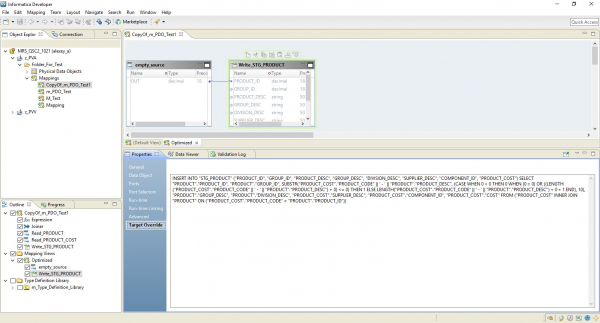
Aqui, assim como no caso anterior, o Hadoop atua como o maestro. No entanto, aqui a leitura da fonte é realizada completamente, e depois, no nível do receptor, a lógica de processamento de dados é executada.
Tipo pushdown - nulo
E a última opção é o tipo pushdown, no qual nosso mapeamento se transformará em um script no Hadoop.
O mapeamento otimizado agora ficará assim:
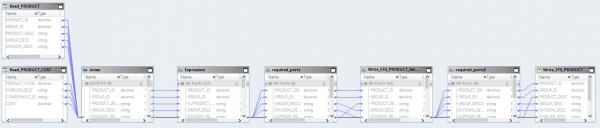
Aqui, os dados dos arquivos de origem serão primeiro lidos no Hadoop. Em seguida, utilizando os próprios recursos do Hadoop, esses dois arquivos serão combinados. Depois disso, os dados serão transformados e carregados no banco de dados.
Compreendendo os princípios da otimização pushdown, é possível organizar de maneira muito eficaz muitos processos de trabalho com grandes dados. Recentemente, uma grande empresa descarregou em apenas algumas semanas grandes dados do armazenamento no Hadoop, que anteriormente havia coletado ao longo de vários anos.
Fonte: habr.com
