

Se no início da peça você menciona que há um código C++ na parede, então ele deve necessariamente disparar contra você no final.
Bjarne Stroustrup
De 31 de outubro a 1 de novembro, aconteceu em São Petersburgo a conferência C++ Russia Piter – uma das maiores conferências de programação na Rússia, organizada pelo JUG Ru Group. Entre os palestrantes convidados estão membros do comitê de padronização C++, palestrantes do CppCon, autores de livros da editora O'Reilly, além de mantenedores de projetos como LLVM, libc++ e Boost. A conferência é voltada para desenvolvedores experientes em C++ que desejam aprofundar sua expertise e trocar experiências em um ambiente ao vivo. Estudantes, pós-graduandos e professores universitários recebem descontos muito interessantes.
A edição moscovita da conferência poderá ser visitada já em abril do próximo ano, mas enquanto isso nossos estudantes compartilharão o que de interessante aprenderam no evento passado.
Foto de
Sobre nós
Este post foi produzido por dois estudantes da HSE – São Petersburgo:
- Lisa Vasilenko – estudante do 4º ano de graduação, estudando a área de "Linguagens de Programação" dentro do programa de "Matemática Aplicada e Informática". Ao conhecer a linguagem C++ no primeiro ano da universidade, posteriormente ganhou experiência ao trabalhar com ela em estágios na indústria. Seu interesse por linguagens de programação, de modo geral, e programação funcional, em particular, influenciou sua escolha de palestras na conferência.
- Dania Smirnov – estudante do 1º ano de mestrado em "Programação e Análise de Dados". Desde o colégio, escrevia problemas olímpicos em C++, e depois, de alguma forma, a linguagem sempre apareceu em suas atividades acadêmicas e acabou se tornando sua principal ferramenta de trabalho. Ele decidiu participar da conferência para aprimorar seus conhecimentos e também para descobrir novas oportunidades.
Na newsletter, a direção do departamento frequentemente compartilha informações sobre eventos educacionais relacionados à nossa especialidade. Em setembro, vimos informações sobre o C++ Russia e decidimos nos inscrever como ouvintes. Esta é a nossa primeira experiência participando de conferências desse tipo.
Estrutura da conferência
Palestras
Durante dois dias, especialistas leram 30 relatórios, abordando muitos tópicos quentes: aplicações engenhosas das funcionalidades da linguagem para resolver problemas práticos, as próximas atualizações da linguagem com o novo padrão, compromissos no design do C++ e precauções ao lidar com suas consequências, exemplos de arquiteturas interessantes de projetos, além de alguns detalhes de infraestrutura da linguagem. Ao mesmo tempo, ocorriam três apresentações, sendo geralmente duas em russo e uma em inglês.
Zonas de discussão
Após as apresentações, todas as perguntas não respondidas e discussões inacabadas foram transferidas para zonas de interação especialmente designadas com os palestrantes, equipadas com quadros brancos. Uma boa maneira de passar o intervalo entre as apresentações com uma conversa agradável.
Lightning Talks e discussões informais
Se alguém quiser fazer uma apresentação rápida — pode se inscrever no quadro branco para o Lightning Talk da noite e terá cinco minutos para falar sobre qualquer coisa relacionada ao tema da conferência. Por exemplo, uma introdução rápida sobre sanitizers para C++ (que foi novidade para alguns) ou uma história sobre um bug na geração de senoides, que só pode ser ouvido, mas não visto.
Outro formato — painel de discussão 'Com o Comite das Almas'. No palco, alguns membros do comitê de padronização, no projetor — uma lareira (oficialmente — para criar uma atmosfera acolhedora, mas a razão 'porque TUDO ESTÁ EM CHAMAS' parece mais divertida), as perguntas são sobre o padrão e a visão geral do C++, sem intensas discussões técnicas e guerras de palavras. Ficou claro que no comitê também estão pessoas reais, que podem não ter certeza em alguns pontos ou não saber de algo.
Para os amantes de controvérsias, havia um terceiro evento — sessão BOF 'Go contra C++'. Pegamos um fã de Go, um fã de C++, e antes de começar a sessão, eles preparam juntos 100500 slides sobre o tema (como problemas com pacotes em C++ ou a falta de generics em Go), e então discutem animadamente entre si e com o público, enquanto a audiência tenta entender dois pontos de vista simultaneamente. Se uma controvérsia irrelevante começa — o moderador intervém e busca reconciliar os lados. Esse formato é envolvente: algumas horas após o início, apenas metade dos slides tinha sido coberta. O final teve que ser apressado.
Stands de parceiros
Nos halls foram apresentados os parceiros da conferência — em estandes, eles falaram sobre projetos atuais, ofereceram estágios e emprego, realizaram quizzes e pequenas competições, além de sorteios de prêmios agradáveis. Algumas empresas até ofereceram a possibilidade de passar pelas etapas iniciais de entrevistas, o que pode ser útil para aqueles que vieram não apenas para ouvir as palestras.
Detalhes técnicos das palestras
Ouvimos as palestras ao longo dos dois dias. Às vezes, era difícil escolher uma palestra entre as que aconteciam simultaneamente – decidimos nos dividir e trocar conhecimentos durante os intervalos. Mesmo assim, parece que muita coisa foi deixada de lado. Aqui, gostaríamos de relatar o conteúdo de algumas das palestras que nos pareceram mais interessantes.
Exceções em C++ através da ótica de otimizações de compilador, Roman Russeyev
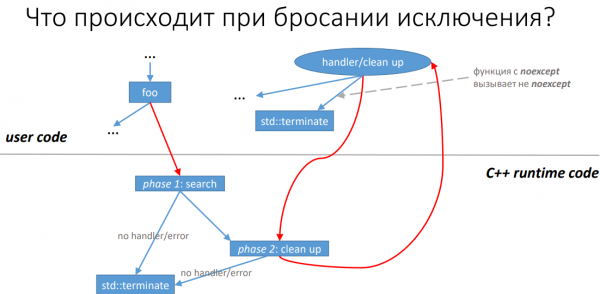
Slide da
Como é evidente pelo título, Roman analisou o trabalho com exceções usando o exemplo do LLVM. Para aqueles que não usam Clang em seu trabalho, a apresentação ainda pode fornecer uma visão sobre como o código pode potencialmente ser otimizado. Isso acontece porque os desenvolvedores de compiladores e das respectivas bibliotecas padrão se comunicam entre si e muitas soluções bem-sucedidas podem coincidir.
Assim, para lidar com uma exceção, é necessário realizar várias ações: chamar o código de manipulação (se houver) ou liberar recursos no nível atual e desdobrar a pilha acima. Tudo isso leva ao fato de que, para chamadas que potencialmente geram exceções, o compilador adiciona instruções adicionais. Portanto, se uma exceção não for realmente gerada, o programa ainda realizará ações desnecessárias. Para tentar reduzir as sobrecargas, o LLVM possui várias heurísticas para identificar situações em que a adição de código de manipulação de exceções não é necessária ou onde é possível reduzir o número de instruções "desnecessárias".
O palestrante analisa cerca de uma dezena delas e mostra como as situações nas quais elas ajudam a acelerar a execução do programa, assim como aquelas em que esses métodos não são aplicáveis.
Assim, Roman Russeyev leva os ouvintes à conclusão de que o código que envolve o trabalho com exceções nem sempre pode ser executado com custos nulos e oferece os seguintes conselhos:
- Ao desenvolver bibliotecas, é melhor evitar exceções no princípio;
- se exceções forem realmente necessárias, deve-se adicionar modificadores noexcept (e const) sempre que possível, para que o compilador possa otimizar ao máximo.
No geral, o palestrante confirmou a opinião de que as exceções devem ser usadas ao mínimo ou, de preferência, evitadas.
Os slides da apresentação estão disponíveis no link:
Geradores, corrotinas e outras maravilhas para desdobrar a mente, Adi Shavit
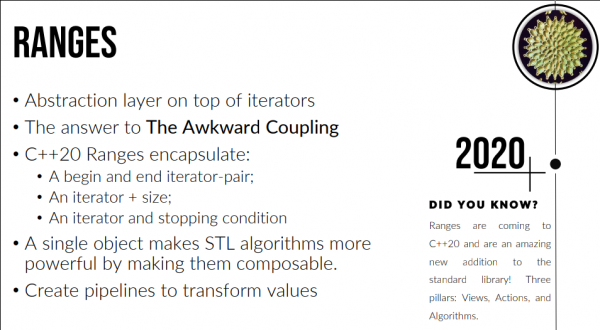
Slide da
Uma das muitas palestras desta conferência, abordando as inovações do C++20, se destacou não apenas pela apresentação visualmente atraente, mas também pela clara identificação de problemas com a lógica de manipulação de coleções (laço for, callbacks).
Adi Shavit aponta os seguintes problemas: os métodos disponíveis até o momento percorrem a coleção inteira, sem permitir acesso a um estado intermediário interno (ou permitem em casos de callbacks, mas com muitos efeitos colaterais indesejáveis, como o famoso Callback Hell). Embora existam iteradores, ainda assim a situação não é tão simples: não há um ponto comum de entrada e saída (begin → end contra rbegin → rend, etc.), e não está claro quanto tempo estaremos iterando? A partir do C++20, esses problemas são resolvidos!
A primeira opção: ranges. Com uma camada sobre os iteradores, obtemos uma interface comum para o início e o fim da iteração, além da possibilidade de composição. Tudo isso permite construir facilmente pipelines completos de processamento de dados. Mas nem tudo é tão simples: parte da lógica de computação está dentro da implementação de um iterador específico, o que pode complicar a legibilidade e a depuração do código.
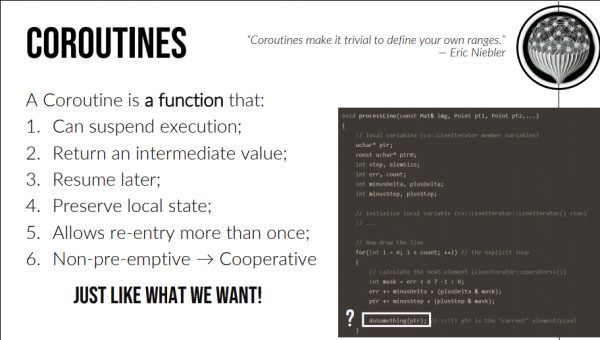
Slide da
Bem, para isso, o C++20 adicionou corrotinas (funções cujo comportamento é semelhante ao dos geradores em Python): a execução pode ser adiada, retornando um valor atual ao mesmo tempo que preserva um estado intermediário. Assim, não apenas trabalhamos com dados à medida que surgem, mas também encapsulamos toda a lógica dentro de uma corrotina específica.
Mas há uma questão: atualmente, eles são apenas parcialmente suportados pelos compiladores existentes e não foram implementados tão cuidadosamente quanto gostaríamos. Por exemplo, ainda não é recomendado usar referências e objetos temporários em corrotinas. Além disso, existem algumas limitações sobre o que pode ser corrotinas, e funções constexpr, construtores/destrutores, assim como o main não estão incluídos nesta lista.
Assim, as corrotinas resolvem uma parte significativa dos problemas com a simplicidade da lógica de processamento de dados, mas suas implementações atuais ainda precisam de melhorias.
Materiais:
- Slides do C++ Russia —
Truques em C++ do Yandex.Taxi, Anton Polukhin
Em minha atividade profissional, às vezes sou obrigado a implementar coisas puramente auxiliares: uma camada entre a interface interna e a API de uma biblioteca, registro ou parsing. Normalmente, não há necessidade de otimizações adicionais. Mas e se esses componentes forem utilizados em um dos serviços mais populares da Runet? Nessa situação, teremos que processar terabytes de logs por hora! Então, cada milissegundo conta e precisaremos recorrer a vários truques — sobre eles falou Anton Polukhin.
Talvez o exemplo mais interessante tenha sido a implementação do padrão pointer-to-implementation (pimpl).
#include <third_party/json.hpp> //PROBLEMS!
struct Value {
    Value() = default;
    Value(Value&& other) = default;
    Value& operator=(Value&& other) = default;
    ~Value() = default;

    std::size_t Size() const { return data_.size(); }

private:
    third_party::Json data_;
};
Neste exemplo, primeiramente, queremos nos livrar dos arquivos de cabeçalho de bibliotecas externas — assim a compilação será mais rápida e poderemos nos proteger contra possíveis conflitos de nomes e outros erros semelhantes.
Muito bem, movemos o #include para o arquivo .cpp: precisamos de uma forward-declaration da API envolvida e também de std::unique_ptr. Agora temos alocações dinâmicas e outras coisas desagradáveis, como dados espalhados pela heap e garantias reduzidas. Tudo isso pode ser ajudado com std::aligned_storage.
struct Value {
// ...
private:
    using JsonNative = third_party::Json;
    const JsonNative* Ptr() const noexcept;
    JsonNative* Ptr() noexcept;

    constexpr std::size_t kImplSize = 32;
    constexpr std::size_t kImplAlign = 8;
    std::aligned_storage_t data_;
};
O único problema: precisamos especificar o tamanho e o alinhamento para cada wrapper — vamos tornar nosso pimpl genérico com os parâmetros , usar alguns valores arbitrários e adicionar uma verificação no destrutor para garantir que tudo esteja correto:
~FastPimpl() noexcept {
    validate();
    Ptr()->~T();
}

template
static void validate() noexcept {
    static_assert(
        Size == ActualSize,
        "Tamanho e sizeof(T) não coincidem"
    );
    static_assert(
        Alignment == ActualAlignment,
        "Alinhamento e alignof(T) não coincidem"
    );
}
Como, ao lidar com o destrutor, T já está definido, esse código será analisado corretamente e na fase de compilação exibirá os valores necessários de tamanho e alinhamento como erros. Assim, a custo de uma execução adicional da compilação, eliminamos a alocação dinâmica de classes envoltas, ocultamos a API em um arquivo .cpp com a implementação e também obtemos uma construção mais amigável para o cache do processador.
O registro e a análise pareceram menos impressionantes, portanto, não serão mencionados nesta revisão.
Os slides da apresentação estão disponíveis no link:
Técnicas modernas para manter seu código DRY, Björn Fahller
Neste relatório, Björn Fahller mostra várias maneiras diferentes de lidar com o descuido estilístico de verificações de condições repetidas:
assert(a == IDLE || a == CONNECTED || a == DISCONNECTED);Familiar? Usando algumas poderosas técnicas de C++, que surgiram em padrões recentes, podemos implementar elegantemente a mesma funcionalidade sem a menor perda de desempenho. Compare:
assert(a == any_of(IDLE, CONNECTED, DISCONNECTED));Para lidar com um número não fixo de verificações, o uso de templates variádicos e expressões de redução se torna atraente. Suponha que queremos verificar a igualdade de várias variáveis a um elemento do enum state_type. A primeira coisa que vem à mente é escrever uma função auxiliar is_any_of:
enum state_type { IDLE, CONNECTED, DISCONNECTED };

template
bool is_any_of(state_type s, const Ts& ... ts) {
    return ((s == ts) || ...);
}
Esse resultado intermediário é decepcionante. Até agora, o código ainda não se torna mais legível:
assert(is_any_of(state, IDLE, DISCONNECTING, DISCONNECTED)); Um pouco de ajuda pode vir dos parâmetros de template não-tipo. Com eles, transferiremos os elementos enumerados do enum para a lista de parâmetros do template:
template
bool is_any_of(state_type t) {
    return ((t == states) | ...);
}

assert(is_any_of(state));
Com o uso de auto em um parâmetro não-tipo do template (C++17), a abordagem simplesmente se generaliza para comparações não apenas com elementos do state_type, mas também com tipos primitivos que podem ser usados como parâmetros de template não-tipo:
template
bool is_any_of(const T& t) {
    return ((t == alternatives) | ...);
}
Por meio de tais melhorias sequenciais, alcançamos a sintaxe fluente desejada para as verificações:
template
struct any_of : private std::tuple {
// vamos preguiçar e herdar os construtores de tuple
        using std::tuple::tuple;
        template
        bool operator ==(const T& t) const {
                return std::apply(
                    [&t](const auto& ... ts) {
                        return ((ts == t) || ...);
                    },
                    static_cast<const std::tuple&>(*this));
        }
};

template
any_of(Ts ...) -> any_of;

assert(any_of(IDLE, DISCONNECTING, DISCONNECTED) == state);
Neste exemplo, o guia de dedução serve para sugerir os parâmetros de template desejados da estrutura ao compilador, que conhece os tipos dos argumentos do construtor.
A seguir – fica mais interessante. Björn ensina a generalizar o código resultante para operadores de comparação além do ==, e depois para operações arbitrárias. Ao longo do caminho, usando exemplos, questões como o atributo no_unique_address (C++20) e parâmetros de template em funções lambda (C++20) são explicadas. (Sim, agora a sintaxe das lambdas é ainda mais fácil de lembrar – são quatro pares consecutivos de parênteses de todos os tipos.) A solução final utilizando funções como partes do construtor pessoalmente me aquece o coração, sem mencionar a expressão tuple nas melhores tradições do cálculo lambda.
No final, não esqueça de dar um acabamento:
- Lembremos que lambdas – constexpr de graça;
- Adicionaremos perfect forwarding e veremos sua sintaxe feia aplicada ao pacote de parâmetros no fechamento de lambdas;
- Daremos ao compilador mais oportunidades de otimizações com conditional noexcept;
- Cuidaremos de uma saída de erros mais clara em templates graças a valores de retorno explícitos de lambdas. Isso fará com que o compilador realize mais verificações antes da chamada da função template – na fase de verificação de tipos.
Para detalhes, consulte os materiais da palestra:
- Slides da apresentação:
Nossas impressões
A nossa primeira participação no C++ Russia foi marcada pela sua intensidade. Formou-se a impressão de que o C++ Russia é um evento acolhedor, onde a linha entre aprendizado e interação ao vivo é quase indistinta. Tudo, desde a disposição dos palestrantes até os concursos dos parceiros do evento, convida a discussões animadas. A parte substantiva da conferência, que consiste nas palestras, abrange uma gama bastante ampla de temas, incluindo inovações em C++, exemplos práticos de grandes projetos e considerações arquitetônicas ideológicas. Mas não seria justo ignorar também o aspecto social do evento, que ajuda a superar barreiras linguísticas em relação não apenas ao C++.
Agradecemos aos organizadores da conferência pela oportunidade de participar desse evento!
O post dos organizadores sobre o passado, presente e futuro do C++ Russia pode ser visto .
Obrigado por ler, e esperamos que nosso resumo dos eventos tenha sido útil!
Fonte: habr.com
