

Você tem novamente a tarefa de detecção de objetos. A prioridade é a velocidade de operação com uma precisão aceitável. Você utiliza a arquitetura YOLOv3 e a ajusta. A precisão (mAP75) é maior que 0,95. Mas a velocidade de execução ainda é baixa. Droga.
Hoje vamos evitar a quantização. E abaixo veremos Model Pruning — a remoção de partes redundantes da rede para acelerar a inferência sem perda de precisão. De forma visual — de onde, quanto e como é possível cortar. Vamos discutir como fazer isso manualmente e onde é possível automatizar. No final — repositório em keras.
Introdução
No meu antigo emprego, na Macroscop de Perm, adquiri um hábito — sempre acompanhar o tempo de execução dos algoritmos. E o tempo de execução das redes deve sempre ser verificado por meio de um filtro de adequação. Normalmente, o state-of-the-art não passa por esse filtro, o que me levou ao Pruning.
O Pruning é um tema antigo, apresentado nas em 2017. A ideia principal é reduzir o tamanho da rede treinada sem perder precisão, removendo vários nós. Parece ótimo, mas raramente ouço sobre sua aplicação. Provavelmente, faltam implementações, há escassez de artigos em russo ou simplesmente todos acham o pruning um segredo e permanecem em silêncio.
Mas vamos analisar.
Uma visão na biologia
Gosto quando ideias da biologia são incorporadas ao Deep Learning. Elas, assim como a evolução, podem ser confiáveis (e você sabia que a ReLU é bastante semelhante à ?)
O processo de Model Pruning também é similar à biologia. A reação da rede aqui pode ser comparada à plasticidade do cérebro. Há alguns exemplos interessantes no livro :
- O cérebro de uma mulher, que tinha apenas uma metade desde o nascimento, reprogramou a si mesmo para realizar as funções da metade que faltava.
- Um rapaz se atirou na cabeça e atingiu a parte do cérebro responsável pela visão. Com o tempo, outras partes do cérebro assumiram essas funções. (não estamos tentando repetir isso)
Assim, é possível cortar partes das suas convoluções fracas. No pior dos casos, as convoluções restantes ajudarão a substituir as cortadas.
Você prefere Transfer Learning ou está aprendendo do zero?
Opção número um. Você está usando Transfer Learning no Yolov3, Retina, Mask-RCNN ou U-Net. Mas, na maioria das vezes, não precisamos reconhecer 80 classes de objetos, como no COCO. Na minha experiência, tudo se limita a 1-2 classes. Pode-se supor que a arquitetura para 80 classes é excessiva aqui. Surge a ideia de que a arquitetura precisa ser reduzida, e isso deve ser feito sem perder os pesos pré-treinados existentes.
A segunda opção. Talvez você tenha muitos dados e recursos computacionais ou simplesmente precise de uma arquitetura super personalizada. Não importa. Mas você está treinando a rede do zero. A ordem comum é observar a estrutura dos dados, escolher uma arquitetura EXCESSIVA em potência e aplicar dropout para evitar overfitting. Eu já vi dropouts de 0.6, cara.
Em ambos os casos, a rede pode ser reduzida. Motivados. Agora vamos entender o que é o pruning.
Algoritmo geral
Decidimos que podemos remover as convoluções. Isso parece bastante simples:
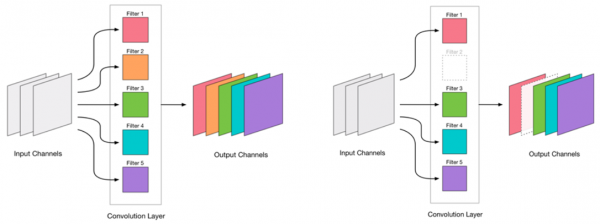
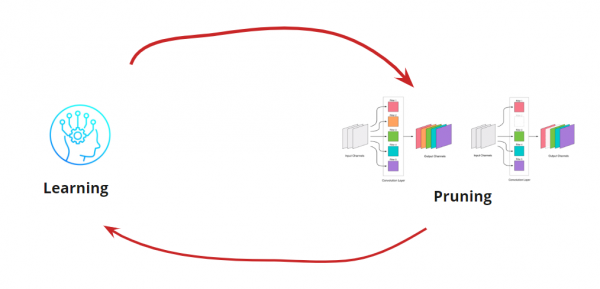
Remover qualquer convolução é um estresse para a rede, que geralmente leva a um aumento do erro. Por um lado, esse aumento de erro é um indicativo de quão corretamente estamos removendo as convoluções (por exemplo, um grande aumento indica que estamos fazendo algo errado). Mas um pequeno aumento é aceitável e muitas vezes é eliminado por um leve re-treinamento com uma baixa taxa de aprendizado. Vamos adicionar um passo de re-treinamento:
Agora precisamos entender quando queremos parar nosso ciclo de LearningPruning. Aqui podem existir opções exóticas, onde precisamos reduzir a rede a um determinado tamanho e velocidade de execução (por exemplo, para dispositivos móveis). No entanto, a opção mais comum é continuar o ciclo até que o erro se torne maior do que o permitido. Vamos adicionar uma condição:
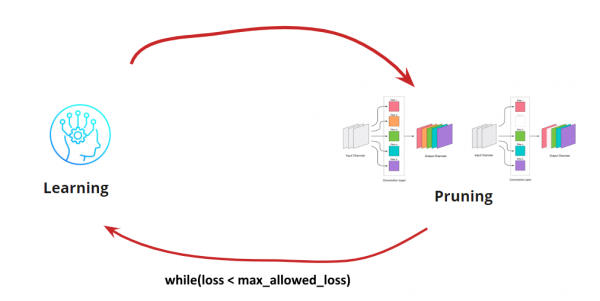
Então, o algoritmo se torna claro. Resta entender como identificar as convoluções a serem removidas.
Busca por convoluções removíveis
Precisamos remover algumas convoluções. Avançar de forma indiscriminada e 'disparar' quaisquer convoluções é uma má ideia, mesmo que funcione. Mas, uma vez que temos cabeça, podemos pensar e tentar identificar as convoluções 'fracas' para remoção. Existem várias opções:
- . A ideia é que convoluções com valores de peso baixos têm uma pequena contribuição na decisão final.
- Menor medida L1 considerando a média e o desvio padrão. Complementamos com uma avaliação do tipo de distribuição.
- . Definição mais precisa de convoluções insignificantes, mas bastante dispendiosa em termos de tempo e recursos.
- O status estável (GA) foi obtido para os seguintes recursos:
Cada uma das opções tem seu valor e suas características de implementação. Aqui, vamos considerar a opção com a menor medida L1
Processo manual para YOLOv3
A arquitetura original contém blocos residuais. Mas, por mais avançados que sejam para redes profundas, eles podem atrapalhar um pouco. O problema é que não podemos remover convoluções com índices diferentes nessas camadas:
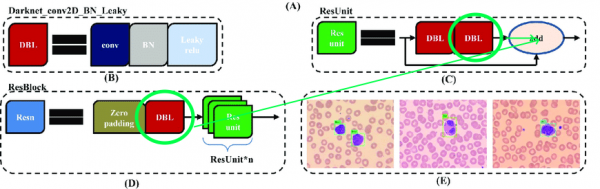
Portanto, vamos destacar as camadas das quais podemos remover as convoluções livremente:

Agora vamos construir um ciclo de trabalho:
- Exportamos as ativações
- Estimamos quanto cortar
- Cortamos
- Treinamos por 10 épocas com LR=1e-4
- Testando
Exportar convoluções é útil para avaliar qual parte podemos remover em uma determinada etapa. Exemplos de exportação:
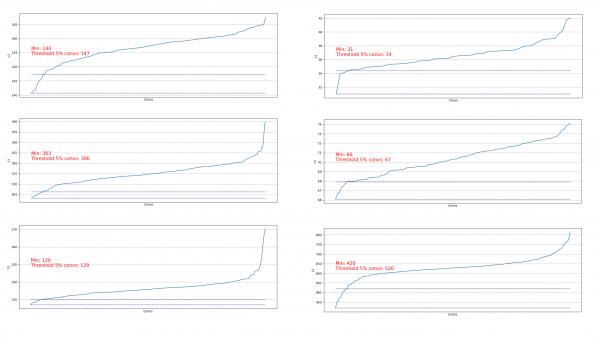
Vemos que praticamente em todos os lugares, 5% das convoluções têm uma norma L1 bastante baixa e podemos removê-las. Em cada etapa, essa exportação foi repetida e foram feitas avaliações de quais camadas e quanto poderíamos cortar.
Todo o processo se resolveu em 4 etapas (aqui e em todos os lugares, números para RTX 2060 Super):
| Passo | mAp75 | Número de parâmetros, milhões | Tamanho da rede, MB | Em relação ao original, % | Tempo de execução, ms | Condição de corte |
|---|---|---|---|---|---|---|
| 0 | 0.9656 | 60 | 241 | 100 | 180 | — |
| 1 | 0.9622 | 55 | 218 | 91 | 175 | 5% do total |
| 2 | 0.9625 | 50 | 197 | 83 | 168 | 5% do total |
| 3 | 0.9633 | 39 | 155 | 64 | 155 | 15% para camadas com 400+ convoluções |
| 4 | 0.9555 | 31 | 124 | 51 | 146 | 10% para camadas com 100+ convoluções |
No passo 2, surgiu um efeito positivo — o tamanho do lote 4 cabia na memória, o que acelerou bastante o processo de re-treinamento.
No passo 4, o processo foi interrompido, pois mesmo um longo re-treinamento não elevou o mAp75 aos valores antigos.
No final, conseguimos acelerar a inferência em 15%, reduzir o tamanho em 35% e não perder precisão.
Automatização para arquiteturas mais simples
Para arquiteturas de rede mais simples (sem blocos condicionais add, concatenate e residuais), é possível focar em processar todas as camadas convolucionais e automatizar o processo de remoção de convoluções.
Esse tipo de implementação eu realizei .
É simples: você só precisa da função de perda, otimizador e geradores de lote:
import pruning
from keras.optimizers import Adam
from keras.utils import Sequence

train_batch_generator = BatchGenerator...
score_batch_generator = BatchGenerator...

opt = Adam(lr=1e-4)
pruner = pruning.Pruner("config.json", "categorical_crossentropy", opt)

pruner.prune(train_batch, valid_batch)
Se necessário, você pode alterar as configurações dos parâmetros:
{
    "input_model_path": "model.h5",
    "output_model_path": "model_pruned.h5",
    "finetuning_epochs": 10, # o número de épocas para treinar entre as etapas de poda
    "stop_loss": 0.1, # perda para interromper o processo
    "pruning_percent_step": 0.05, # parte das convoluções a serem eliminadas a cada etapa de poda
    "pruning_standart_deviation_part": 0.2 # deslocamento para limitar a parte de poda
}
Adicionalmente, foi implementada uma limitação com base no desvio padrão. O objetivo é limitar a parte removida, excluindo convoluções com medidas L1 já 'suficientes':
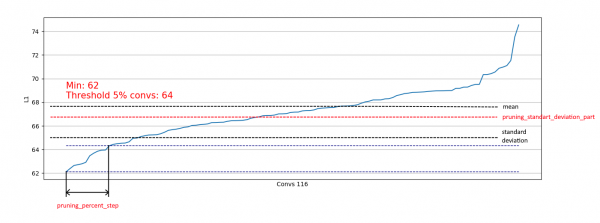
Com isso, permitimos a remoção apenas de convoluções fracas de distribuições semelhantes à direita e não influenciamos a remoção de distribuições semelhantes à esquerda:
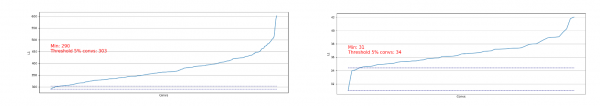
À medida que a distribuição se aproxima da normal, o coeficiente pruning_standart_deviation_part pode ser escolhido a partir de:
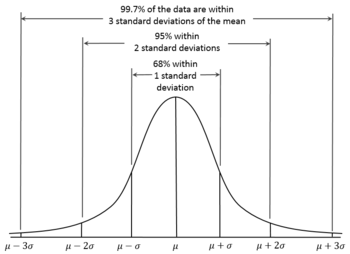
Recomendo uma margem de 2 sigmas. Ou pode-se não se basear nessa particularidade, deixando o valor < 1.0.
O resultado é um gráfico do tamanho da rede, perda e tempo de execução da rede em todo o teste, normalizados para 1.0. Por exemplo, aqui o tamanho da rede foi reduzido quase pela metade sem perda de qualidade (uma pequena rede convolucional com 100k pesos):
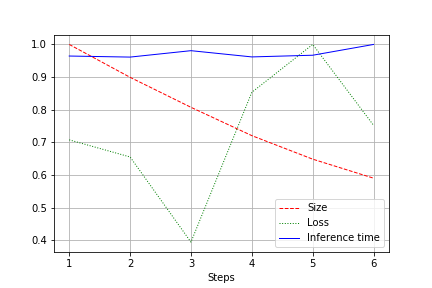
A velocidade de execução está sujeita a flutuações normais e praticamente não mudou. Existe uma explicação para isso:
- O número de convoluções muda de formatos convenientes (32, 64, 128) para opções menos convenientes para placas gráficas — 27, 51 etc. Posso estar errado, mas provavelmente isso influencia.
- A arquitetura não é ampla, mas sequencial. Ao reduzir a largura, não alteramos a profundidade. Assim, reduzimos a carga, mas não mudamos a velocidade.
Portanto, a melhoria se traduz em uma redução na carga do CUDA durante a execução em 20-30%, mas não na redução do tempo de execução.
Resultados
Vamos refletir. Consideramos 2 variantes de poda — para YOLOv3 (quando é necessário trabalhar manualmente) e para redes com arquiteturas mais simples. É evidente que em ambos os casos é possível alcançar a redução do tamanho da rede e aceleração sem perda de precisão. Resultados:
- Redução de tamanho
- Aceleração da execução
- Redução da carga do CUDA
- Como consequência, sustentabilidade (Estamos otimizando o futuro uso de recursos computacionais. Em algum lugar, alguém fica feliz )
Apêndice
- Após o passo de poda, pode-se ajustar também a quantização (por exemplo, com TensorRT)
- O Tensorflow oferece recursos para . Funciona.
- Quero desenvolver e ficarei feliz com a ajuda
Fonte: habr.com
