

A Google apresentou um novo codec de áudio, o Lyra, otimizado para alcançar a máxima qualidade na transmissão de voz, mesmo em canais de comunicação muito lentos. O código de implementação do Lyra é escrito em C++ e é de código aberto sob a licença Apache 2.0, mas entre as dependências necessárias para seu funcionamento está a biblioteca proprietária libsparse_inference.so, que implementa o núcleo para cálculos matemáticos. É observado que a biblioteca proprietária é temporária — futuramente, o Google promete desenvolver uma substituição de código aberto e garantir suporte para diversas plataformas.
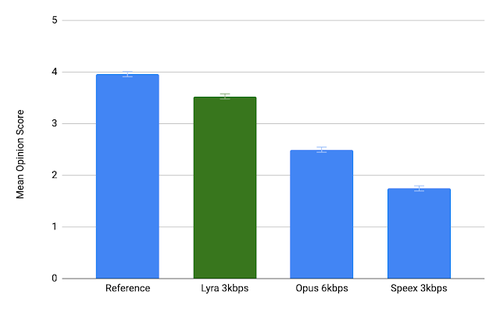
Em termos de qualidade dos dados de voz transmitidos em baixas velocidades, o Lyra supera significativamente os codecs tradicionais que utilizam métodos de processamento digital de sinais. Para alcançar alta qualidade na transmissão de voz em condições de volume limitado de informações transmitidas, além dos métodos convencionais de compressão de som e conversão de sinais, o Lyra utiliza um modelo de fala baseado em um sistema de aprendizado de máquina, que permite recriar as informações ausentes com base em características típicas da fala. O modelo utilizado para a geração de som foi treinado com várias milhares de horas de gravações de vozes em mais de 70 idiomas.
O codec inclui um codificador e um decodificador. O algoritmo de funcionamento do codificador resume-se à extração de parâmetros de dados de voz a cada 40 milissegundos, sua compressão e transmissão ao destinatário pela rede. Para a transmissão de dados, é suficiente uma conexão com uma velocidade de 3 kilobits por segundo. Os parâmetros sonoros extraídos incluem espectrogramas mel logarítmicos, que levam em conta as características da energia da fala em diferentes faixas de frequência e são preparados considerando o modelo de percepção auditiva humana.
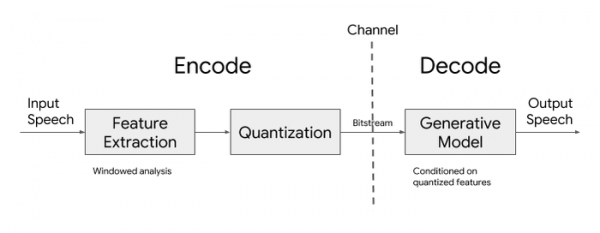
O decodificador utiliza um modelo generativo que, com base nos parâmetros sonoros fornecidos, recria o sinal de voz. Para reduzir a complexidade dos cálculos, foi aplicada uma leve modelagem baseada em uma rede neural recorrente, que é uma variante do modelo de síntese de voz WaveRNN, utilizando uma frequência de amostragem mais baixa, mas gerando simultaneamente múltiplos sinais em diferentes faixas de frequência. Os sinais obtidos são então sobrepostos para gerar um único sinal de saída correspondente à frequência de discretização especificada.
Para acelerar ainda mais, foram aplicadas instruções de processador especializadas, disponíveis em processadores ARM de 64 bits. Como resultado, apesar do uso de aprendizado de máquina, o codec Lyra pode ser utilizado para codificação e decodificação de voz em tempo real em smartphones de médio preço, demonstrando um atraso de transmissão de sinal de 90 milissegundos.
Fonte: opennet.ru
