

A empresa Google anunciou a abertura do código do projeto Magika, que é destinado a identificar o tipo de conteúdo com base na análise dos dados contidos em um arquivo. O Magika pode identificar com precisão as linguagens de programação utilizadas no conteúdo, métodos de compressão, pacotes de instalação, código executável, tipos de marcação, formatos de áudio, vídeo, documentos e imagens. A caixa de ferramentas relacionada ao projeto e o modelo de aprendizado de máquina prontos foram publicados sob a licença Apache 2.0.
Em comparação com projetos semelhantes que determinam o tipo MIME com base no conteúdo, o Magika se destaca pelo uso de métodos de aprendizado de máquina, alta performance e qualidade excepcional de identificação. O modelo foi treinado usando o framework Keras em 25 milhões de exemplos de arquivos e suporta o reconhecimento de 116 tipos de dados com uma precisão de pelo menos 99%. O modelo está empacotado no formato ONNX e possui apenas 1 MB de tamanho. O uso de métodos de aprendizado de máquina profundo permitiu aumentar a precisão da identificação em 50% em relação ao sistema anteriormente aplicado pela Google, baseado em regras definidas manualmente.
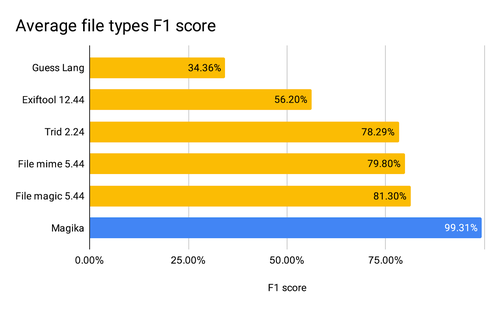
Na Google, o sistema é utilizado para classificar arquivos nos serviços Gmail, Drive, Code Insight e Safe Browsing durante a realização de verificações de segurança e conformidade com as regras dos serviços. Há esforços em andamento para integrar o Magika na plataforma VirusTotal como uma etapa para a filtragem inicial de arquivos antes da execução de analisadores específicos. A configuração implementada na infraestrutura da Google proporciona a varredura de vários milhões de arquivos por segundo e várias centenas de bilhões de arquivos por semana. Após o carregamento do modelo, o tempo de geração de saída é de 5-6 ms durante testes em um núcleo de CPU. O tempo de identificação quase não depende do tamanho do arquivo.
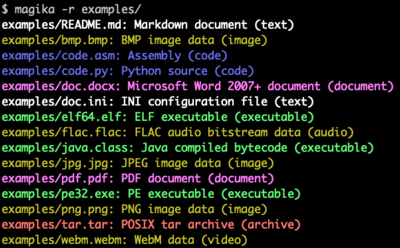
Para usar o Magika em seus projetos, foram preparadas uma ferramenta de linha de comando, um pacote para Python e uma biblioteca JavaScript que pode operar em navegadores ou em projetos baseados em Node.js. A interface de linha de comando e a API suportam a execução de operações em modo batch, ou seja, permitem verificar vários arquivos em uma única solicitação. Há um modo de varredura recursiva de todo o conteúdo de um diretório e três modos de previsão para ajustar a resistência a erros (alta confiança, média confiança e melhor palpite).
Fonte: opennet.ru
