

Um grupo de pesquisadores da Universidade de Tel Aviv apresentou o HyperStyle, uma variante invertida do sistema de aprendizado de máquina StyleGAN2, desenvolvido pela NVIDIA, que foi adaptado para recriar partes ausentes ao editar imagens reais. O código é escrito em Python utilizando o framework PyTorch e é distribuído sob a licença MIT.
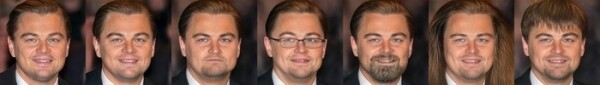
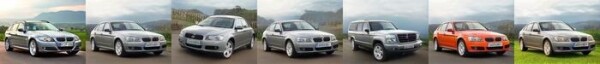
Enquanto o StyleGAN permite sintetizar rostos humanos que parecem realistas, ajustando parâmetros como idade, gênero, comprimento do cabelo, características do sorriso, formato do nariz, cor da pele, óculos e ângulo da fotografia, o HyperStyle proporciona a capacidade de alterar parâmetros semelhantes em fotografias já existentes, sem modificar suas características distintivas e mantendo o reconhecimento do rosto original. Por exemplo, com o HyperStyle, é possível simular a mudança de idade de uma pessoa na fotografia, trocar o penteado, adicionar óculos, barba ou bigode, transformar a imagem em um personagem de desenho animado ou em uma pintura, ou ainda alterar a expressão do rosto para triste ou alegre. Além disso, o sistema pode ser treinado não apenas para alterar rostos humanos, mas também para qualquer objeto, como a edição de imagens de carros.
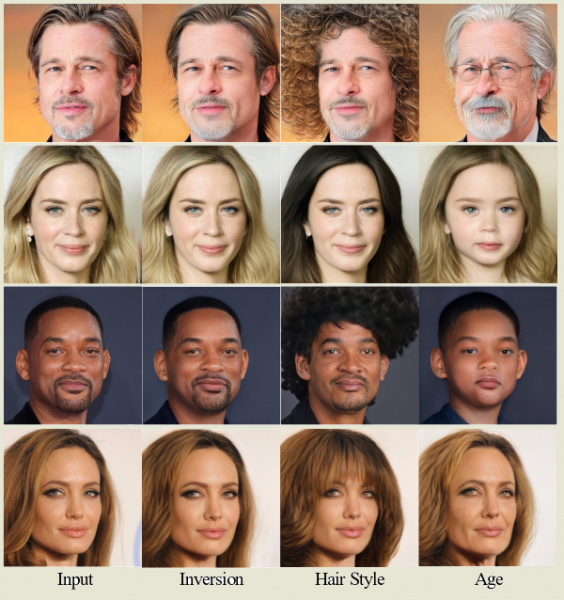
O método proposto visa resolver o problema da reconstrução de partes ausentes de uma imagem durante a edição. Nos métodos anteriormente sugeridos, o compromisso entre reconstrução e editabilidade era abordado através do ajuste fino do gerador de imagens para inserir partes da imagem-alvo ao recriar áreas editáveis que estavam originalmente ausentes. A desvantagem desses abordagens é a necessidade de um treinamento prolongado da rede neural para cada imagem.
O método baseado no algoritmo StyleGAN permite a utilização de um modelo padrão, previamente treinado em coleções gerais de imagens, para gerar elementos característicos da imagem original com um nível de veracidade comparável aos algoritmos que requerem treinamento individual do modelo para cada imagem. Entre as vantagens do novo método também se destaca a capacidade de modificar imagens com desempenho próximo ao tempo real.
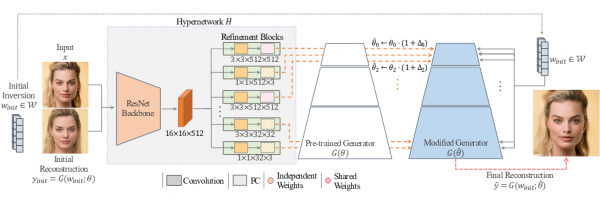
Modelos pré-treinados prontos foram preparados para rostos humanos, máquinas e animais com base nas coleções Flickr-Faces-HQ (FFHQ, 70 mil imagens PNG de rostos humanos de alta qualidade), Stanford Cars (16 mil imagens de carros) e AFHQ (fotos de animais). Além disso, uma ferramenta para treinar seus próprios modelos foi fornecida, assim como modelos pré-treinados prontos para uso com codificadores e geradores típicos. Por exemplo, geradores estão disponíveis para criar imagens no estilo Toonify, personagens da Pixar, formação de esboços e até estilização de princesas de filmes da Disney.
Fonte: opennet.ru
