

O artigo da equipe Stitch Fix sugere usar a abordagem de estudos clínicos de eficácia não inferior (non-inferiority trials) em testes A/B de marketing e produtos. Essa abordagem é realmente aplicável quando testamos uma nova solução que possui vantagens não mensuráveis pelos testes.
Um exemplo simples é a redução de custos. Por exemplo, automatizamos o processo de agendamento da primeira aula, mas não queremos diminuir muito a conversão geral. Ou testamos alterações direcionadas a um segmento de usuários, enquanto monitoramos para que as conversões de outros segmentos não caiam drasticamente (ao testar múltiplas hipóteses, não devemos esquecer as correções).
Escolher o limite correto de não inferioridade acrescenta desafios adicionais na fase de design do teste. A questão de como escolher Δ não é muito bem abordada no artigo. Parece que essa escolha não é completamente transparente e acontece também em ensaios clínicos. Publicações médicas sobre não inferioridade indicam que apenas em metade dos estudos a escolha do limite é justificável, e frequentemente essas justificativas são ambíguas ou não detalhadas.
De qualquer forma, essa abordagem parece interessante, pois a redução do tamanho da amostra necessária pode aumentar a velocidade de teste e, portanto, a velocidade de tomada de decisão. — Darya Mukhina, analista de produtos do aplicativo móvel Skyeng.
A equipe Stitch Fix gosta de testar diferentes coisas. Toda a comunidade tecnológica, em geral, adora realizar testes. Qual versão do site atrai mais usuários – A ou B? A versão A do modelo de recomendação gera mais receita do que a versão B? Quase sempre, para verificar as hipóteses, usamos a abordagem mais simples do curso básico de estatística:
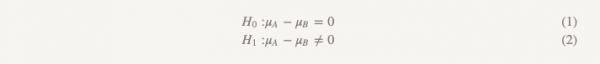
Embora raramente usemos esse termo, essa forma de teste é chamada de "teste de hipótese de superioridade". Com essa abordagem, assumimos que não há diferença entre as duas opções. Mantemos essa ideia e a descartamos apenas se os dados obtidos forem suficientemente convincentes para isso – ou seja, demonstram que uma das opções (A ou B) é melhor do que a outra.
A verificação da hipótese sobre a superioridade é adequada para resolver diversos problemas. Lançamos a versão B do modelo de recomendação apenas se ela for claramente melhor que a versão A utilizada atualmente. No entanto, em alguns casos, essa abordagem não funciona tão bem. Vejamos alguns exemplos.
1) Usamos um serviço de terceiros, que ajuda a identificar cartões bancários falsificados. Encontramos outro serviço que é significativamente mais barato. Se o serviço mais barato funcionar tão bem quanto o que estamos usando agora, optaremos por ele. Não é necessário que ele seja melhor do que o serviço atualmente utilizado.
2) Queremos nos afastar da fonte de dados A e substituí-la pela fonte de dados B. Poderíamos adiar a descontinuação de A se B apresentar resultados muito ruins, mas continuar usando A não é uma opção.
3) Gostaríamos de mudar da abordagem de modelagemA para a abordagem B, não porque esperamos melhores resultados de B, mas porque isso nos dá maior flexibilidade operacional. Não temos motivos para acreditar que B será pior, mas não faremos a transição se for o caso.
4) Fizemos algumas mudanças qualitativas no design do site (versão B) e acreditamos que esta versão supera a versão A. Não esperamos mudanças na conversão ou em quaisquer indicadores-chave de desempenho pelos quais geralmente avaliamos o site. Mas acreditamos que há benefícios em métricas que são ou imensuráveis ou para as quais não temos tecnologia suficiente para medir.
Em todos esses casos, a pesquisa sobre superioridade não é a abordagem mais adequada. No entanto, a maioria dos especialistas em tais situações a utiliza por padrão. Realizamos rigorosamente um experimento para determinar corretamente a magnitude do efeito. Se fosse verdade que as versões A e B funcionam de maneira muito semelhante, haveria uma probabilidade de não conseguirmos rejeitar a hipótese nula. Concluímos que A e B funcionam de forma semelhante? Não! A impossibilidade de rejeitar a hipótese nula e a aceitação da hipótese nula não são a mesma coisa.
Os cálculos do volume da amostra (que você, é claro, realizou) geralmente são feitos com limites mais rigorosos para o erro do primeiro tipo (a probabilidade de rejeitar incorretamente a hipótese nula, frequentemente chamada de alfa) do que para o erro do segundo tipo (a probabilidade de não rejeitar a hipótese nula, dado que a hipótese nula está errada, frequentemente chamada de beta). O valor típico para alfa é 0,05, enquanto que o valor típico para beta é 0,20, o que corresponde a uma potência estatística de 0,80. Isso significa que podemos não detectar o verdadeiro efeito do tamanho que indicamos em nossos cálculos de potência com uma probabilidade de 20%, o que é uma lacuna de informação bastante séria. Como exemplo, vamos considerar as seguintes hipóteses:
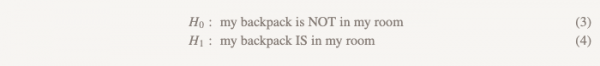
H0: minha mochila NÃO está no meu quarto (3)
H1: minha mochila está no meu quarto (4)
Se eu vasculhei meu quarto e encontrei minha mochila — ótimo, posso rejeitar a hipótese nula. Mas se eu olhei o quarto e não consegui encontrar minha mochila (figura 1), que conclusão devo tirar? Estou certo de que ela não está lá? Procurei com atenção suficiente? E se eu procurei apenas 80% do quarto? Chegar à conclusão de que a mochila não está definitivamente no quarto seria uma decisão precipitada. Não é surpreendente que não podemos "aceitar a hipótese nula".
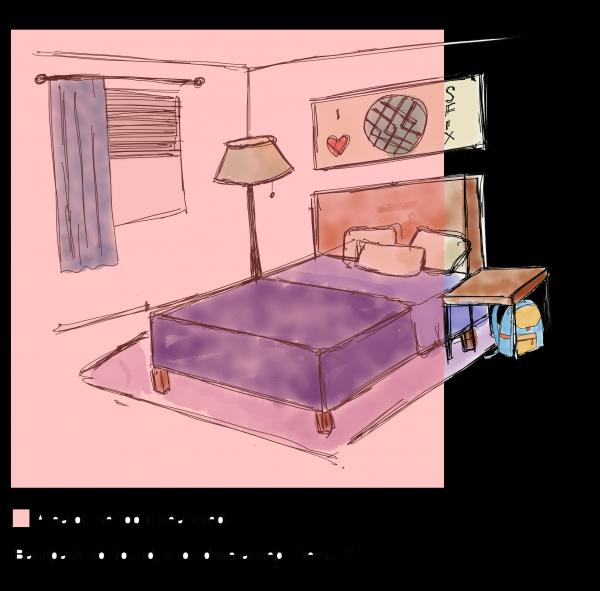
A área que vasculhamos
Não encontramos a mochila — devemos aceitar a hipótese nula?
Figura 1. Vasculhar 80% do quarto é aproximadamente o mesmo que realizar um estudo com potência de 80%. Se você não encontrou a mochila ao inspecionar 80% do quarto, é possível concluir que ela não está lá?
Então, o que deve fazer um especialista em dados nessa situação? Você pode aumentar bastante a potência do estudo, mas para isso precisará de uma amostra muito maior, e o resultado ainda será insatisfatório.
Felizmente, problemas como este têm sido amplamente estudados no mundo das pesquisas clínicas. O medicamento B é mais barato que o medicamento A; espera-se que o medicamento B cause menos efeitos colaterais do que o medicamento A; o medicamento B é mais fácil de transportar, pois não precisa ser mantido em refrigerado, enquanto o medicamento A precisa. Vamos verificar a hipótese de não menor eficácia. Isso é necessário para mostrar que a versão B é tão boa quanto a versão A — pelo menos dentro de um limite previamente definido de “não menor eficácia”, Δ. Mais adiante, falaremos mais sobre como estabelecer esse limite. Mas agora, vamos supor que essa seja a diferença mínima que é praticamente significativa (no contexto de ensaios clínicos, isso é geralmente chamado de significância clínica).
Hipóteses de não menor eficácia viram tudo de cabeça para baixo:
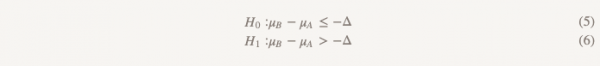
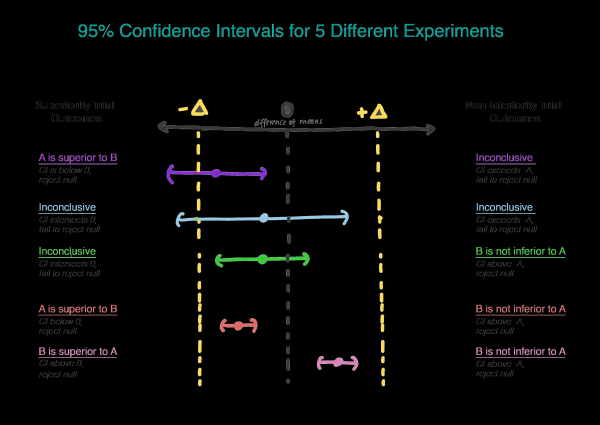
Agora, em vez de supor que não há diferença, supomos que a versão B é pior que a versão A e mantemos essa suposição até que possamos demonstrar o contrário. Este é exatamente o momento em que faz sentido usar o teste de hipótese unilateral! Na prática, isso pode ser feito construindo um intervalo de confiança e determinando se o intervalo é realmente maior que Δ (Figura 2).
Escolhendo Δ
Como escolher corretamente Δ? O processo de escolha de Δ envolve justificativa estatística e avaliação de conteúdo. No mundo das pesquisas clínicas, existem diretrizes normativas que indicam que a delta deve representar a menor diferença clinicamente significativa — aquela que terá importância na prática. Aqui está uma citação da diretriz europeia que pode servir como referência: “Se a diferença foi escolhida corretamente, o intervalo de confiança que está completamente entre –∆ e 0…, ainda é suficiente para demonstrar não menor eficácia. Se esse resultado não parece aceitável, isso significa que ∆ não foi escolhido corretamente.”
A delta não deve, de forma alguma, ultrapassar o efeito da versão A em relação ao controle verdadeiro (placebo / ausência de tratamento), pois isso nos leva a concluir que a versão B é pior que o controle verdadeiro, enquanto demonstra 'não menor eficácia'. Suponhamos que, quando a versão A foi apresentada, existia a versão 0 ou a função não existia de modo algum (veja a Figura 3).
Com os resultados da verificação da hipótese de superioridade, foi identificado um efeito E (ou seja, supostamente μ^A−μ^0=E). Agora A é nosso novo padrão, e queremos garantir que B não é inferior a A. Outra forma de escrever μB−μA≤−Δ (a hipótese nula) é μB≤μA−Δ. Se admitirmos que o que fazemos é igual ou superior a E, então μB ≤ μA−E ≤ placebo. Agora vemos que nossa estimativa para μB supera completamente μA−E, o que assim refuta totalmente a hipótese nula e permite concluir que B não é inferior a A, mas ao mesmo tempo μB pode ser ≤ μ placebo, o que não é o que precisamos. (Figura 3).
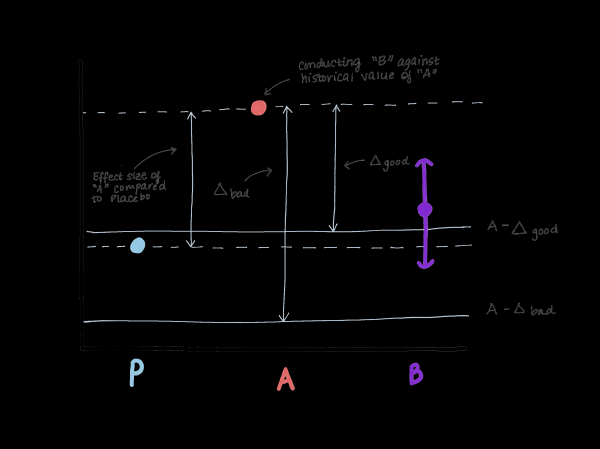
Figura 3. Demonstração dos riscos da escolha de um limite de não menor eficácia. Se o limite for muito grande, pode-se concluir que B não é inferior a A, mas ao mesmo tempo é indistinguível do placebo. Não iremos substituir um medicamento que é claramente mais eficaz que o placebo (A) por um que tem a mesma eficácia que o placebo.
Escolha de α
Vamos passar para a escolha de α. Pode-se usar o valor padrão α = 0,05, mas isso não é exatamente justo. Por exemplo, quando você compra algo na internet e usa vários códigos de desconto ao mesmo tempo, embora eles não devam se acumular — foi apenas um erro do desenvolvedor, e você se beneficiou disso. De acordo com as regras, o valor de α deve ser igual à metade do valor de α que é usado na verificação da hipótese de superioridade, ou seja, 0,05 / 2 = 0,025.
Tamanho da amostra
Como avaliar o tamanho da amostra? Se você acredita que a verdadeira diferença média entre A e B é 0, então o cálculo do tamanho da amostra será o mesmo que ao verificar a hipótese de superioridade, exceto que você substituirá o tamanho do efeito pelo limite de não menor eficácia, desde que você use αnão menor eficácia = 1/2αsuperioridade (αnão inferioridade=1/2αsuperioridade). Se você tem razões para acreditar que a opção B pode ser um pouco pior que a opção A, mas deseja provar que não é pior do que Δ, então você teve sorte! Na verdade, isso reduz o tamanho da sua amostra, pois é mais fácil demonstrar que B é pior que A se você realmente acredita que é um pouco pior e não equivalente.
Exemplo de decisão
Suponha que você deseja mudar para a versão B sob a condição de que ela seja pior que a versão A não mais do que 0,1 pontos em uma escala de satisfação do cliente de 5 pontos… Vamos abordar essa tarefa usando a hipótese de superioridade.
Para testar a hipótese de superioridade, calcularíamos o tamanho da amostra da seguinte forma:
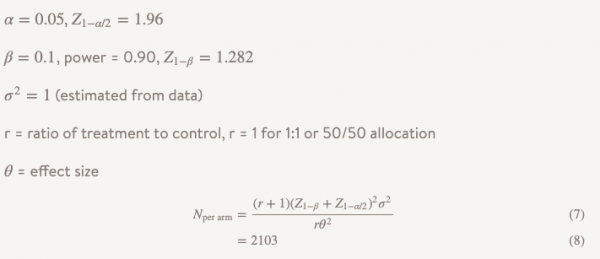
Ou seja, se você tiver 2103 observações em seu grupo, poderá ter 90% de confiança de que detectará um efeito de tamanho 0,10 ou mais. Mas se 0,10 for muito grande para você, talvez não valha a pena testar a hipótese de superioridade nesse caso. Pode ser que, para mais confiabilidade, você decida realizar um estudo para um tamanho de efeito menor, por exemplo, 0,05. Nesse caso, você precisaria de 8407 observações, o que implica um aumento quase quatro vezes no tamanho da amostra. Mas e se decidirmos manter nosso tamanho de amostra original, mas aumentar o poder para 0,99, para que não tenhamos dúvidas se obtermos um resultado positivo? Nesse caso n para um grupo será 3676, o que já é melhor, mas aumenta o tamanho da amostra em mais de 50%. E, no final, ainda assim não conseguiremos refutar a hipótese nula, em vez de obter uma resposta para nossa pergunta.
E se, em vez disso, testássemos a hipótese de não menor eficácia?
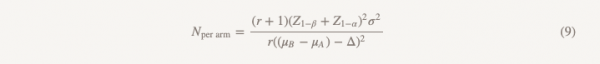
O tamanho da amostra será calculado pela mesma fórmula, exceto pelo denominador.
As diferenças da fórmula usada ao testar a hipótese de superioridade são as seguintes:
— Z1−α/2 é substituído por Z1−α, mas se você fizer tudo certinho, você substitui α = 0,05 por α = 0,025, ou seja, é o mesmo número (1,96)
— no denominador aparece (μB−μA)
— θ (tamanho do efeito) é substituído por Δ (limite de não menor eficácia)
Se assumirmos que µB = µA, então (µB − µA) = 0 e o cálculo do tamanho da amostra para o limite de não inferioridade é exatamente o que obteríamos ao calcular a superioridade para um tamanho de efeito de 0,1, ótimo! Podemos realizar um estudo da mesma escala com diferentes hipóteses e uma abordagem diferente para as conclusões, e obteremos a resposta para a pergunta que realmente queremos responder.
Agora, suponhamos que na verdade não acreditamos que µB = µA e
pensamos que µB é um pouco pior, talvez em 0,01 unidades. Isso aumenta nosso denominador, reduzindo o tamanho da amostra do grupo para 1737.
O que acontece se a versão B for realmente melhor do que a versão A? Estamos rejeitando a hipótese nula de que B é pior que A em mais de Δ e aceitaremos a hipótese alternativa de que B, se pior, não é pior do que Δ, e pode ser melhor. Tente incluir essa conclusão em uma apresentação multifuncional e veja o que acontece (sério, tente). Em uma situação onde é necessário navegar por perspectivas, ninguém quer concordar que "não é pior do que Δ e, possivelmente, é melhor".
Nesse caso, podemos realizar um estudo que se chama de forma muito breve "teste da hipótese de que uma das opções supera a outra ou é inferior a ela". Nele são utilizados dois conjuntos de hipóteses:
O primeiro conjunto (o mesmo da verificação da hipótese de não inferioridade):
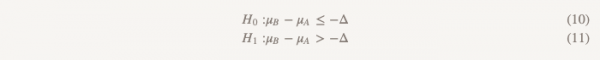
O segundo conjunto (o mesmo da verificação da hipótese de superioridade):
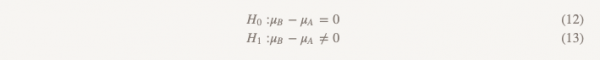
Testamos a segunda hipótese somente se a primeira for rejeitada. Em testes sequenciais, mantemos o nível geral de erro do primeiro tipo (α). Na prática, isso pode ser alcançado criando um intervalo de confiança de 95% para a diferença entre as médias e verificando se todo o intervalo excede -Δ. Se o intervalo não exceder -Δ, não podemos rejeitar o valor nulo e paramos. Se todo o intervalo realmente exceder −Δ, continuaremos e veremos se o intervalo inclui 0.
Há outro tipo de pesquisa que não discutimos – pesquisas de equivalência.
Pesquisas desse tipo podem ser substituídas por estudos para testar a hipótese de não menor eficácia e vice-versa, mas elas têm uma diferença importante. O teste para validar a hipótese de não menor eficácia tem o objetivo de demonstrar que a variante B é pelo menos tão boa quanto a A. Já um estudo de equivalência visa mostrar que a variante B é pelo menos tão boa quanto a A, e que a variante A é tão boa quanto a B, o que é mais complicado. Essencialmente, estamos tentando determinar se todo o intervalo de confiança para a diferença de médias está entre −Δ e Δ. Esses estudos requerem um tamanho de amostra maior e são realizados com menor frequência. Portanto, da próxima vez que você realizar uma pesquisa em que seu objetivo principal é garantir que a nova versão não seja pior, não aceite a "impossibilidade de refutar a hipótese nula". Se você deseja testar uma hipótese realmente importante, considere diferentes opções.
Fonte: habr.com
