

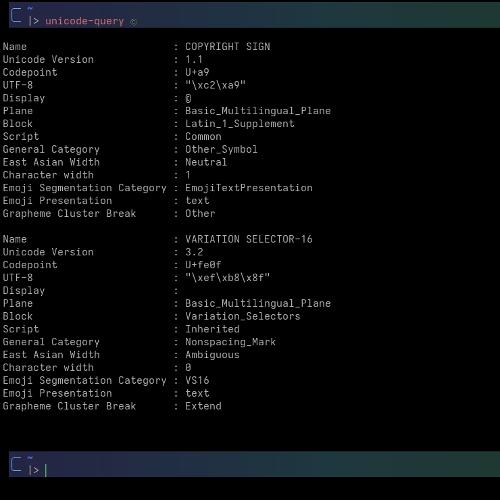
Foi lançado a versão 0.9.0 da biblioteca para a linguagem C++ (padrão C++20) libunicode. O projeto está sendo desenvolvido por uma equipe de desenvolvedores de emulador de terminal Contour e interface Endo (em desenvolvimento ativo), e é distribuído sob a licença Apache 2.0.
- suporte a padrões Unicode 17.0:
- API para obter propriedades Unicode;
- otimização SIMD de algumas funções (usando std::simd ou std::experimental::simd quando disponíveis);
- conversão otimizada entre UTF-8 UTF-16/UTF-32;
- equivalente da função wcwidth (int unicode::width(char32_t));
- segmentação de texto por grafemas, caracteres, emojis e scripts;
- conversão de caixa e comparação de strings;
- API de alto nível para segmentação de texto, adequada para implementação de formatação de texto.
- cobertura de testes para a maioria das funcionalidades da biblioteca (largura do caractere e segmentação).
O pacote também inclui a ferramenta de console unicode-query para obter informações detalhadas sobre strings.
Mudanças:
- adicionado API grapheme_cluster_width;
- melhorias no trabalho com versões do Unicode ('Age');
- suporte total UAX #15 Formas de Normalização Unicode com suporte a processamento em fluxo:
normalizer norm(Normalization_Form::NFC); // Alimenta decomposição de e + agudo combinado, depois um novo iniciador para disparar a emissão auto result = norm.feed(U'e'); CHECK(result.empty()); // ainda armazenando result = norm.feed(U'u0301′); CHECK(result.empty()); // ainda armazenando (marcador combinando) result = norm.feed(U'x'); // iniciador dispara a emissão do segmento anterior REQUIRE_FALSE(result.empty()); CHECK(result == U"u00E9"); // e + agudo composto para e-agudo result = norm.flush(); CHECK(result == U"x"); // segmento final
- a função script_extensions agora retorna std::optional<std::span>;
- implementada a regra GB9c de divisão de grupos de grafemas para combinações de caracteres em idiomas do grupo Indic;
- em grapheme_segmenter as regras para GB11 e GB4/GB5 foram corrigidas; API obsoleta removida;
- implementada a conversão otimizada com SIMD de UTF-8 para UTF-16/UTF-32;
- a largura dos caracteres de junção Hangul V/T agora é zero;
- implementada segmentação por limites de palavras;
- correções na API C;
- refatoração do sistema de construção e do gerador auxiliar de tabelas C++;
- testes complexos adicionados para conversão de UTF-16/UTF-32;
- nova construção estática da ferramenta unicode-query adicionada no CI.
Fonte: linux.org.ru
