

Recentemente foi lançada , que mostra bem a tendência do aprendizado de máquina nos últimos anos. Em resumo: o número de startups na área de aprendizado de máquina caiu drasticamente nos últimos dois anos.
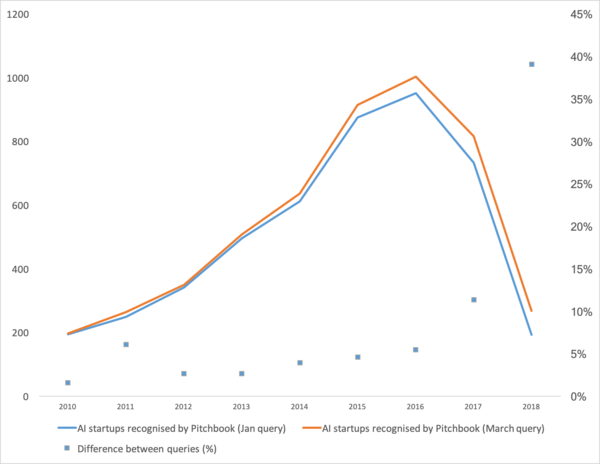
Então, vamos analisar se a "bolha estourou", como viver a partir de agora e discutir de onde veio essa situação.
Para começar, vamos falar sobre o que foi o impulsionador dessa curva. De onde ela surgiu. Provavelmente todos vão se lembrar do aprendizado de máquina em 2012 no concurso ImageNet. Afinal, esse foi o primeiro evento global! Mas, na realidade, não é bem assim. E o crescimento da curva começa um pouco antes. Eu dividiria em vários momentos.
- O ano de 2008 marcou a aparição do termo “big data”. Produtos reais começaram a partir de 2010. Big data está diretamente relacionado ao aprendizado de máquina. Sem big data, não é possível o funcionamento estável de algoritmos que existiam na época. E não se tratava de redes neurais. Até 2012, as redes neurais eram um campo para uma minoria marginal. No entanto, foi nessa época que começaram a funcionar algoritmos completamente diferentes, que já existiam há anos, ou até décadas: (1963, 1993), (1995), (2003),… As startups daquela época estavam principalmente ligadas ao processamento automático de dados estruturados: caixas registradoras, usuários, publicidade, entre outros.
A derivada dessa primeira onda é um conjunto de frameworks, como XGBoost, CatBoost, LightGBM, etc.
- Entre 2011 e 2012 ganharam uma série de competições de reconhecimento de imagem. O uso real delas demorou um pouco. Eu diria que as startups e soluções com real significado começaram a surgir em 2014. Foram necessários dois anos para entender que as redes neurais realmente funcionam, criar frameworks que pudessem ser instalados e executados em um tempo razoável, desenvolver métodos que estabilizassem e acelerassem o tempo de convergência.
As redes convolucionais permitiram resolver tarefas de visão computacional: classificação de imagens e objetos em imagens, detecção de objetos, reconhecimento de objetos e pessoas, melhoria de imagens, entre outros.
- 2015-2017. O auge dos algoritmos e projetos baseados em redes recorrentes ou seus análogos (LSTM, GRU, TransformerNet etc.). Apareceram algoritmos que funcionam bem para “fala-para-texto” e sistemas de tradução automática. Parte deles é baseada em redes convolucionais para extrair recursos básicos. Outra parte é resultado do aprendizado em reunir realmente grandes e bons conjuntos de dados.
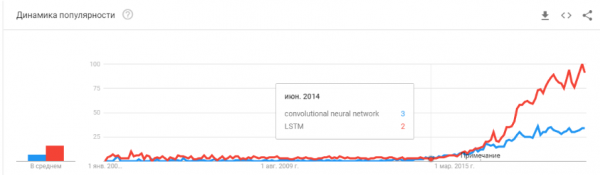
“A bolha estourou? O hype está superaquecido? Eles morreram como o blockchain?”
Vai por mim! Amanhã, o Siri do seu telefone vai parar de funcionar, e depois de amanhã, um Tesla não vai diferenciar uma curva de um canguru.
As redes neurais já estão funcionando. Elas estão em dezenas de dispositivos. Elas realmente permitem ganhar dinheiro, mudam o mercado e o mundo ao seu redor. O hype parece um pouco diferente:
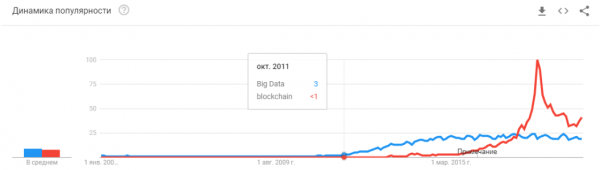
Simplesmente, as redes neurais deixaram de ser algo novo. É verdade que muitas pessoas têm expectativas exageradas. Mas um grande número de empresas aprendeu a aplicar redes neurais e a criar produtos com base nelas. Redes neurais oferecem nova funcionalidade, permitem reduzir postos de trabalho e diminuir o custo dos serviços:
- Empresas de manufatura integram algoritmos para analisar defeitos na linha de montagem.
- Fazendas de gado compram sistemas para monitorar as vacas.
- Colheitadeiras automáticas.
- Centros de atendimento automatizados.
- Filtros no SnapChat. (pelo menos algo útil!)
Mas o principal, e não tão óbvio: “Não há mais novas ideias, ou elas não trarão capital imediato”. Redes neurais resolveram dezenas de problemas. E resolverão ainda mais. Todas as ideias óbvias que existiam geraram uma série de startups. Mas tudo o que estava à superfície já foi explorado. Nos últimos dois anos, não encontrei nenhuma nova ideia para aplicar redes neurais. Nenhuma nova abordagem (bem, ok, tem algumas complicações com GANs).
E cada nova startup está se tornando mais complexa. Ela já não requer apenas duas pessoas treinando uma rede neural com dados abertos. Ela exige programadores, servidores, uma equipe de anotadores, suporte complexo, etc.
Como resultado, o número de startups está diminuindo. Mas a produção está aumentando. Precisa implementar reconhecimento de placas de veículos? No mercado, há centenas de especialistas com experiência relevante. Você pode contratar alguém e, em alguns meses, seu empregado fará o sistema. Ou comprar um pronto. Mas criar uma nova startup?.. É uma loucura!
É necessário criar um sistema de rastreamento de visitantes — por que pagar por várias licenças, quando se pode desenvolver o seu próprio em 3-4 meses, adaptado para o seu negócio?
Atualmente, as redes neurais estão passando pelo mesmo caminho que outras tecnologias já percorreram.
Lembra como o conceito de "desenvolvedor de sites" mudou desde 1995? Enquanto o mercado não está saturado de especialistas. Existem muito poucos profissionais. Mas eu posso garantir que, em 5-10 anos, não haverá muita diferença entre um programador Java e um desenvolvedor de redes neurais. Especialistas em ambas as áreas serão suficientes no mercado.
Simplesmente haverá categorias de tarefas para as quais as redes neurais podem ser usadas. Surgiu uma tarefa — você contrata um especialista.
“E o que vem depois? Onde está a inteligência artificial prometida?”
Aqui há uma pequena, mas interessante confusão :)
A pilha de tecnologias que temos hoje, aparentemente, não nos levará à inteligência artificial. As ideias e sua novidade se esgotaram em grande parte. Vamos falar sobre o que mantém o atual nível de desenvolvimento.
Restrições
Vamos começar com carros autônomos. Parece claro que criar carros totalmente autônomos com as tecnologias atuais é possível. Mas em quantos anos isso acontecerá — não está claro. A Tesla acredita que será em alguns anos —
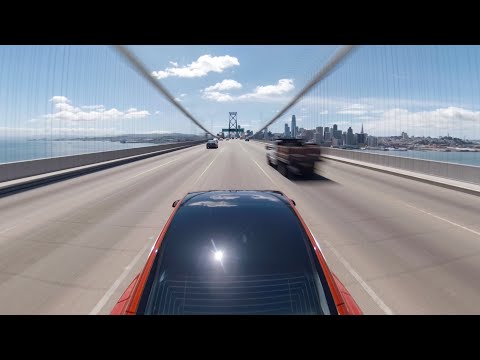
Há muitos outros , que avaliam isso como 5-10 anos.
Provavelmente, na minha opinião, em cerca de 15 anos a infraestrutura das cidades mudará de tal forma que a presença de carros autônomos se tornará inevitável, tornando-se uma extensão dela. Mas isso não pode ser considerado inteligência. A Tesla moderna é uma esteira de produção muito complexa de filtragem de dados, busca e reeducação. São regras-regras-regras, coleta de dados e filtros sobre eles (aqui escrevi um pouco mais sobre isso, ou veja com a marcação).
O primeiro problema
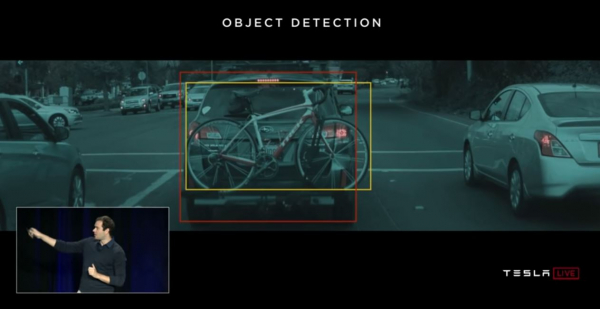
E é exatamente aqui que vemos o primeiro problema fundamental. Big Data. Isso é exatamente o que gerou a atual onda de redes neurais e aprendizado de máquina. Agora, para fazer algo complexo e automático, precisamos de muitos dados. Não apenas uma quantidade razoável, mas uma quantidade imensa. Precisamos de algoritmos automatizados para coletá-los, rotulá-los e utilizá-los. Queremos fazer com que a máquina veja caminhões contra a luz do sol - primeiro, precisamos coletar um número suficiente deles. Queremos que a máquina não fique maluca com uma bicicleta presa ao bagageiro - mais amostras.
E simplesmente um exemplo não é suficiente. Centenas? Milhares?
O segundo problema
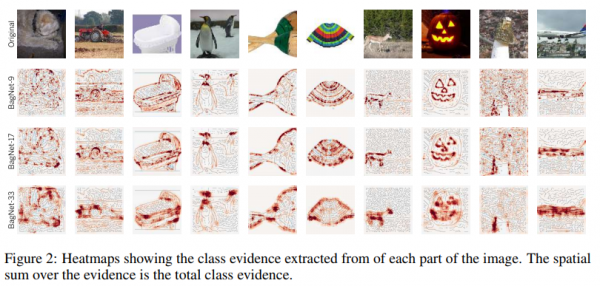
O segundo problema — é a visualização do que nossa rede neural compreendeu. Esta é uma tarefa bastante não trivial. Até agora, poucos conseguem entender como visualizá-la. Estes artigos são bastante recentes, são apenas alguns exemplos, ainda que distantes:
focalização em texturas. Mostra bem em que a neural tende a se fixar + o que ela percebe como informação inicial.
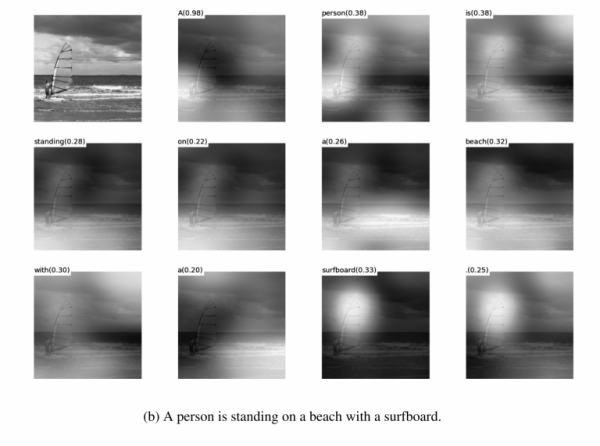
atenção em . Na verdade, a atenção pode ser frequentemente usada precisamente para mostrar o que causou essa reação na rede. Eu vi tais coisas tanto para depuração quanto para soluções de produtos. Há muitos artigos sobre isso. Mas quanto mais complexos os dados, mais difícil é entender como alcançar uma visualização estável.
E sim, o velho e bom conjunto de "veja o que há dentro da rede em ". Essas imagens eram populares há cerca de 3-4 anos, mas todos logo perceberam que as imagens são bonitas, mas sem muito sentido.
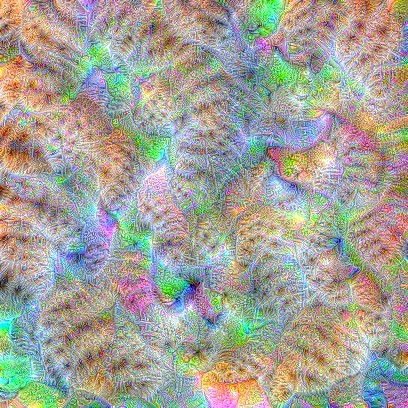
Eu não citei dezenas de outros truques, métodos, hacks, estudos sobre como exibir as interioridades da rede. Esses instrumentos funcionam? Eles ajudam a entender rapidamente qual é o problema e a depurar a rede? .. Extrair os últimos porcentuais? Bem, aproximadamente assim:
Você pode olhar qualquer competição no Kaggle. E a descrição de como o pessoal faz as soluções finais. Nós montamos de 100-500-800 milhões de modelos e funcionou!
Claro, eu estou exagerando. Mas esses métodos não trazem respostas rápidas e diretas.
Com experiência suficiente, tentando várias opções, pode-se emitir um veredicto sobre o porquê de sua sistema ter tomado tal decisão. Mas corrigir o comportamento do sistema será difícil. Colocar um remendo, mover um limiar, adicionar um dataset, usar uma outra rede backend.
O terceiro problema
O terceiro problema fundamental As redes neurais ensinam não lógica, mas estatística. Estatisticamente, isso :
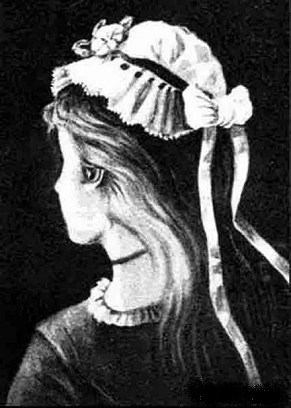
Logicamente, não parece muito. Redes neurais não aprendem algo complexo, a menos que sejam forçadas. Elas sempre aprendem recursos o mais simples possível. Existem olhos, nariz, cabeça? Então é um rosto! Ou traga um exemplo em que os olhos não devam significar um rosto. E novamente — milhões de exemplos.
Há Muito Espaço em Baixo
Eu diria que exatamente esses três problemas globais, atualmente, limitam o desenvolvimento de redes neurais e aprendizado de máquina. Onde esses problemas não limitavam — já está sendo utilizado ativamente.
É o fim? As redes neurais pararam?
Desconhecido. Mas, é claro, todos esperam que não.
Existem muitos abordagens e direções para resolver os problemas fundamentais que destaquei acima. Mas até agora, nenhuma dessas abordagens conseguiu criar algo fundamentalmente novo, resolver algo que até agora não foi resolvido. Até agora, todos os projetos fundamentais são feitos com base em abordagens estáveis (Tesla), ou permanecem como projetos de teste de instituições ou corporações (Google Brain, OpenAI).
Falando grosso modo, a principal direção é a criação de uma certa representação de alto nível dos dados de entrada. De certa forma, uma 'memória'. O exemplo mais simples de memória são as várias 'Embeddings' — representações de imagens. Por exemplo, todos os sistemas de reconhecimento facial. A rede aprende a obter de um rosto uma representação estável que não depende da rotação, iluminação, resolução. Essencialmente, a rede minimiza a métrica 'rostos diferentes - longe' e 'iguais - perto'.
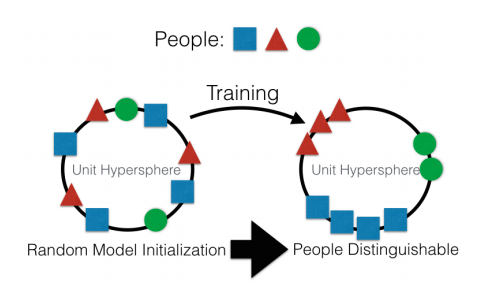
Para esse tipo de aprendizagem, são necessárias dezenas e centenas de milhares de exemplos. Mas o resultado carrega alguns germes de 'One-shot Learning'. Agora não precisamos de centenas de rostos para lembrar uma pessoa. Apenas um rosto, e pronto — nós !
Só que tem um problema... A rede pode aprender apenas objetos suficientemente simples. Ao tentar distinguir não rostos, mas, por exemplo, 'pessoas pela roupa' (tarefa ) — a qualidade cai em muitas ordens de grandeza. E a rede já não consegue aprender mudanças de ângulo suficientemente óbvias.
E aprender com milhões de exemplos — não é exatamente um entretenimento divertido.
Existem trabalhos sobre a redução significativa de escolhas. Por exemplo, um dos primeiros trabalhos sobre OneShot Learning :
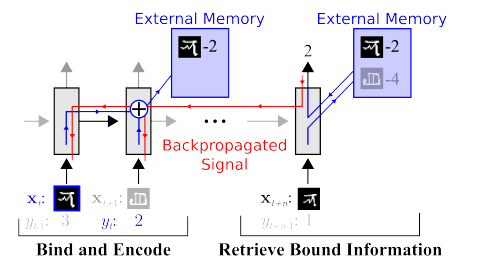
Existem muitos trabalhos como este, por exemplo ou ou .
Um ponto negativo é que, geralmente, o treinamento funciona bem em exemplos simples, como os do ‘MNIST’. Ao passar para tarefas mais complexas, é necessária uma base maior, um modelo de objetos, ou alguma mágica.
Na verdade, o trabalho com aprendizado One-Shot é um tema muito interessante. Muitas ideias podem ser encontradas. Mas, em sua maior parte, os dois problemas que mencionei (pré-treinamento em um grande conjunto de dados / instabilidade em dados complexos) dificultam bastante o aprendizado.
Por outro lado, a abordagem de Embedding é compatível com GAN — redes geradoras adversariais. Você provavelmente já leu muitos artigos sobre isso no Habr., ,)
A característica do GAN é a formação de um espaço interno de estados (basicamente o mesmo Embedding), que permite gerar uma imagem. Podem ser , podem ser .
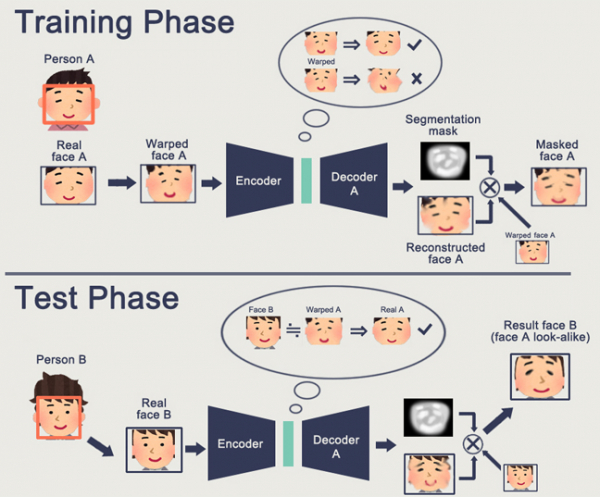
O problema do GAN é que quanto mais complexo for o objeto gerado, mais difícil é descrevê-lo na lógica “gerador-discriminador”. Como resultado, das aplicações reais de GAN que estão na boca do povo, apenas o DeepFake se destaca, que, novamente, manipula representações faciais (para as quais existe uma enorme base).
Encontrei muito poucas outras aplicações úteis. Normalmente, são apenas truques com retoques em imagens.
E, novamente, ninguém tem clareza de como isso nos permitirá avançar para um futuro brilhante. A representação da lógica/espaço em uma rede neural é boa. Mas é necessário um enorme número de exemplos, não entendemos como a neural representa isso internamente, não sabemos como fazer a rede neural memorizá-lo como uma representação realmente complexa.
O aprendizado por reforço é uma abordagem completamente diferente. Você deve se lembrar de como o Google derrotou todos no Go. As vitórias recentes no Starcraft e no Dota. Mas aqui as coisas estão longe de ser tão otimistas e promissoras. O melhor sobre RL e suas complexidades é abordado por .
Resumindo brevemente o que o autor escreveu:
- Modelos prontos não são adequados / funcionam mal na maioria dos casos.
- Problemas práticos são mais fáceis de resolver de outras maneiras. A Boston Dynamics não usa RL devido a sua complexidade / imprevisibilidade / dificuldade de cálculo.
- Para o RL funcionar, é necessária uma função complexa. Muitas vezes, essa função é difícil de criar/escrever.
- É difícil treinar modelos. É preciso gastar muito tempo para ajustar e sair de ótimos locais.
- Como consequência, é difícil reproduzir o modelo, e a instabilidade do modelo com pequenas mudanças.
- Frequentemente, se ajusta excessivamente a padrões aleatórios, até mesmo a geradores de números aleatórios.
O ponto chave é que RL ainda não funciona na produção. O Google tem alguns experimentos ( , ). Mas eu não vi nenhum sistema de produto.
Memória. A desvantagem de tudo o que foi descrito acima é a falta de estrutura. Uma das abordagens que tentam organizar tudo isso é fornecer à rede neural acesso a uma memória separada. Para que ela possa gravar e regravar os resultados de suas etapas. Assim, a rede neural pode ser definida pelo estado atual da memória. Isso se assemelha muito aos processadores e computadores clássicos.
O mais conhecido e popular — da DeepMind:
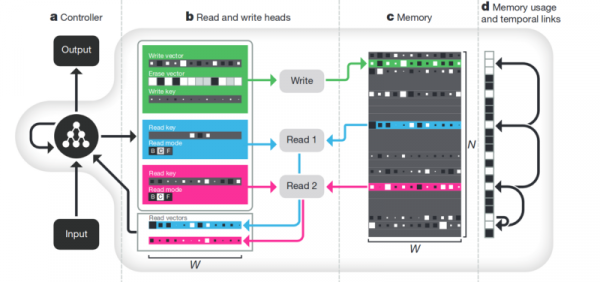
Parece que aqui está a chave para entender a inteligência? Mas provavelmente não. O sistema ainda precisa de um enorme conjunto de dados para treinamento. E ele funciona principalmente com dados tabulares estruturados. Ao mesmo tempo, quando o Facebook um problema semelhante, eles optaram pelo caminho de "esqueça a memória, vamos apenas tornar a rede neural mais complexa, além de mais exemplos — e ela aprenderá sozinha".
Desentrelaçamento. Outra forma de criar memória significativa é pegar as mesmas embeddings, mas durante o treinamento, introduzir critérios adicionais que permitam destacar nelas "significados". Por exemplo, queremos treinar uma rede neural para distinguir o comportamento de uma pessoa na loja. Se fôssemos seguir o caminho padrão — teríamos que criar dezenas de redes. Uma procura pela pessoa, a segunda determina o que ela está fazendo, a terceira a idade, a quarta — o gênero. Uma lógica separada analisa a parte da loja onde ela está fazendo/aprendendo sobre isso. A terceira determina sua trajetória, e assim por diante.
Ou, se houvesse uma quantidade infinita de dados, poderia-se treinar uma única rede em todos os possíveis resultados (é evidente que tal conjunto de dados não pode ser coletado).
O abordagem de desentrelaçamento nos diz — vamos treinar a rede para que ela mesma consiga distinguir conceitos. Para que ela, por meio do vídeo, crie uma embedding onde uma área determinaria a ação, uma — a posição no chão ao longo do tempo, uma — a altura da pessoa, e outra — seu gênero. Durante o treinamento, gostaríamos de quase não orientar a rede em conceitos-chave, mas sim que ela destacasse e agrupasse áreas por conta própria. Há poucos artigos assim (alguns deles , , ) e, em geral, eles são bastante teóricos.
Mas essa direção, pelo menos em teoria, deve resolver os problemas mencionados no início.
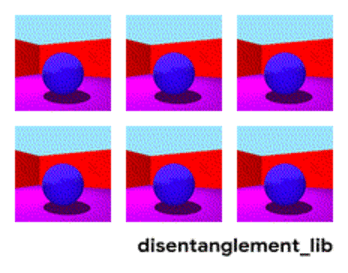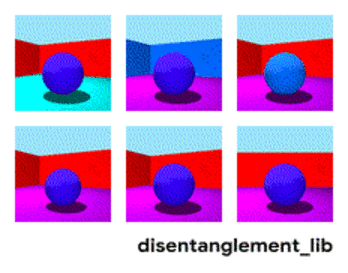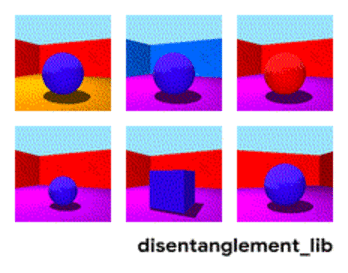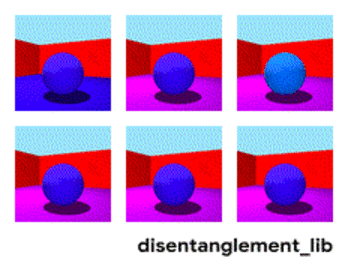
Decomposição da imagem em parâmetros "cor da parede/cor do chão/formato do objeto/cor do objeto/etc."
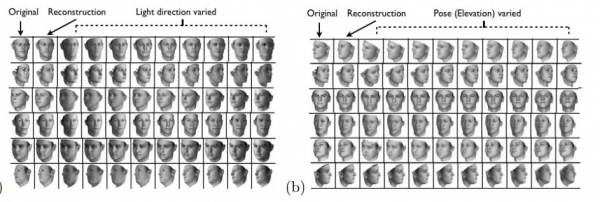
Decomposição do rosto em parâmetros "tamanho, sobrancelhas, orientação, cor da pele, etc."
Outros
Existem muitas outras direções não tão globais que permitem de alguma forma reduzir os bancos de dados, trabalhar com dados mais heterogêneos, etc.
Atenção. Provavelmente não faz sentido destacar isso como um método separado. Apenas uma abordagem que fortalece outras. Há muitos artigos dedicados a isso (,,). O sentido da Atenção é amplificar a reação da rede a objetos significativos durante o treinamento. Muitas vezes, com alguma indicação externa de alvo ou uma pequena rede externa.
Simulação 3D. Se fizer um bom motor 3D, pode-se geralmente cobrir 90% dos dados de treinamento (eu até vi um exemplo em que quase 99% dos dados eram cobertos por um bom motor). Existem muitas ideias e hacks sobre como fazer uma rede treinada em um motor 3D funcionar com dados reais (ajuste fino, transferência de estilo, etc.). Mas, geralmente, fazer um bom motor é várias ordens de magnitude mais difícil do que coletar dados. Exemplos onde foram feitos motores:
Treinamento de robôs (, )
Treinamento de produtos em lojas (mas em dois projetos que realizamos — conseguimos contornar isso sem problema).
Treinamento na Tesla (novamente, o vídeo mencionado acima).
Como resultado, obtemos um serviço de "monitoramento como serviço", automatizado na linha de produção de integração contínua. O desenvolvedor ou testador precisa apenas definir a lista de métricas em um arquivo JSON, e tudo o mais acontece automaticamente. Obtemos um controle de qualidade transparente dos lançamentos: todas as notificações sobre desempenho, consumo de recursos ou regressões arquitetônicas.
Todo o artigo são, de certa forma, conclusões. Provavelmente, a mensagem principal que eu queria passar é: "a festa acabou, as redes neurais não oferecem mais soluções simples". Agora é preciso trabalhar duro, construindo soluções complexas. Ou se esforçar fazendo pesquisas científicas complicadas.
Na verdade, o tema é discutível. Talvez os leitores tenham exemplos mais interessantes?
Fonte: habr.com
