

Os sistemas de informação modernos são bastante complexos. Sua complexidade é, em grande parte, devida à complexidade dos dados processados neles. A complexidade dos dados muitas vezes se traduz na diversidade dos modelos de dados utilizados. Por exemplo, quando os dados se tornam "grandes", uma das características que causam desconforto não é apenas seu volume ("volume"), mas também sua diversidade ("variedade").
Se você ainda não encontra falhas na argumentação, continue lendo.
Conteúdo
Persistência poliglota
O que foi dito acima leva a situações em que, mesmo dentro de um único sistema, é necessário usar vários SGBDs diferentes para armazenar dados e resolver várias tarefas de processamento, cada um suportando seu próprio modelo de dados. A expressão foi popularizada por M. Fowler, uma série de livros conhecidos e um dos do Manifesto Ágil, essa situação recebeu o nome de armazenamento múltiplo ("polyglot persistence").
Fowler também apresenta o seguinte exemplo de organização de armazenamento de dados em uma aplicação de comércio eletrônico totalmente funcional e de alta carga.
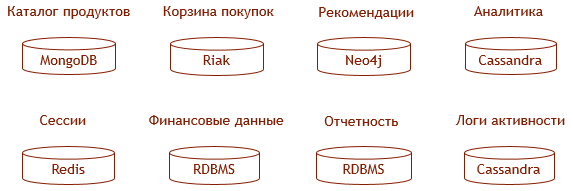
Esse exemplo é, evidentemente, algo exagerado, mas algumas considerações favoráveis à escolha de um SGBD para o respectivo objetivo podem ser encontradas, por exemplo, .
É claro que ser o responsável em tal zoológico não é fácil.
- O volume de código que realiza a persistência dos dados cresce proporcionalmente ao número de SGBDs utilizados; o volume de código que sincroniza os dados cresce em um ritmo quadrático desse número.
- Os custos para garantir as características empresariais (escalabilidade, resiliência, alta disponibilidade) de cada SGBD utilizado aumentam proporcionalmente ao número de SGBDs empregados.
- Não é possível garantir características empresariais para todo o subsistema de armazenamento — especialmente a transacionalidade.
Do ponto de vista do diretor do zoológico, tudo se apresenta da seguinte forma:
- Aumento exponencial dos custos de licenciamento e suporte técnico por parte do fornecedor do SGBD.
- Expansão da equipe e aumento dos prazos.
- Perdas financeiras diretas ou penalidades devido à inconsistência dos dados.
Há um aumento significativo no custo total de propriedade do sistema (TCO). Existe uma saída da situação de "armazenamento multimodal"?
Multimodalidade
O termo "armazenamento multimodal" se tornou comum em 2011. A conscientização sobre os problemas dessa abordagem e a busca por uma solução levaram alguns anos, e, em 2015, por meio de analistas da Gartner, a resposta foi formulada:
- De “»:
O futuro dos SGBDs, suas arquiteturas e formas de uso é a multimodalidade.
- De “»:
Os principais SGBDs operacionais oferecerão vários modelos — relacional e não-relacional — como parte de uma única plataforma.
Parece que desta vez os analistas da Gartner não erraram na previsão. Se você acessar a página com o de SGBDs no DB-Engines, poderá ver que amaiormaioria dos seus líderes se posiciona exatamente como SGBDs multimodais. O mesmo pode ser observado na página de qualquer ranking específico.
Na tabela abaixo, estão os SGBDs líderes em cada uma das classificações específicas, que afirmam ser multimodais. Para cada SGBD, indica-se o modelo inicial suportado (que outrora era o único) e, juntamente com ele, os modelos que são suportados atualmente. Também são listados os SGBDs que se posicionam como "inicialmente multimodais", sem qualquer modelo herdado inicial segundo as declarações dos criadores.
| SGBD | Modelo inicial | Modelos adicionais |
|---|---|---|
| Oracle | Relacional | Gráfico, documental |
| MS SQL | Relacional | Gráfico, documental |
| PostgreSQL | Relacional | Gráfico*, documental |
| MarkLogic | Documental | Gráfico, relacional |
| MongoDB | Documental | Chave-valor, gráfico* |
| DataStax | Wide-column | Documental, gráfico |
| Redis | Chave-valor | Documental, gráfico* |
| ArangoDB | — | Gráfico, documental |
| OrientDB | — | Gráfico, documental, relacional |
| Azure CosmosDB | — | Gráfico, documental, relacional |
Notas sobre a tabela
Os asteriscos na tabela indicam afirmações que exigem qualificações:
- O SGBD PostgreSQL não suporta o modelo de dados gráfico, no entanto, um produto , como, por exemplo, o AgensGraph.
- No que diz respeito ao MongoDB, é mais correto falar sobre a presença de operadores gráficos na linguagem de consulta (, ), do que sobre o suporte ao modelo gráfico, embora, certamente, sua introdução tenha exigido algumas otimizações no nível de armazenamento físico para suportar o modelo gráfico.
- No que diz respeito ao Redis, refere-se à extensão .
A seguir, para cada uma das classes, mostraremos como implementar o suporte a múltiplos modelos em SGBDs dessa classe. Consideraremos as modelos relacional, documental e de grafos como os mais importantes e demonstraremos, através de exemplos de SGBDs específicos, como os 'faltantes' são implementados.
SGBDs multimodais baseados no modelo relacional
Atualmente, os principais SGBDs são relacionais; a previsão da Gartner não poderia ser considerada realizada se os SGBDs relacionais não demonstrassem avanços em direção à multimodalidade. E eles estão demonstrando. Agora, considerações de que um SGBD multimodal é como uma canivete suíço, que não faz nada bem, podem ser direcionadas diretamente a Larry Ellison.
No entanto, o autor prefere a implementação da multimodalidade no Microsoft SQL Server, no qual o suporte aos modelos documentais e de grafos será descrito.
Modelo de documento no MS SQL Server
Sobre como o suporte ao modelo documental é implementado no MS SQL Server, já houve dois excelentes artigos no Habr, e me limitarei a um breve resumo e comentário:
A forma de suporte ao modelo documental no MS SQL Server é bastante típica para SGBDs relacionais: recomenda-se armazenar documentos JSON em campos de texto comuns. O suporte ao modelo documental consiste na oferta de operadores especiais para a análise desse JSON:
- para extrair valores escalares de atributos,
- para extrair subdocumentos.
O segundo argumento de ambos os operadores é uma expressão em uma sintaxe semelhante ao JSONPath.
De maneira abstrata, pode-se dizer que documentos armazenados dessa forma não são 'entidades de primeira classe' em um SGBD relacional, ao contrário de tuplas. Especificamente no MS SQL Server, atualmente não há índices em campos de documentos JSON, o que dificulta operações de junção de tabelas por valores desses campos e até mesmo a seleção de documentos por esses valores. No entanto, é possível criar uma coluna calculada com base em tal campo e um índice sobre ela.
Além disso, o MS SQL Server oferece a possibilidade de construir convenientemente um documento JSON a partir do conteúdo das tabelas com o operador — uma possibilidade, de certa forma oposta ao armazenamento convencional. É claro que, não importa quão rápida seja a SGBD, essa abordagem contraria a ideologia das SGBDs documentais, que, essencialmente, armazenam respostas prontas para consultas populares, e só pode resolver problemas de conveniência de desenvolvimento, mas não de desempenho.
Finalmente, o MS SQL Server permite resolver a tarefa oposta à construção de documentos: é possível decompor JSON em tabelas usando . Se o documento não for completamente plano, será necessário usar PIVOT.
Modelo gráfico no MS SQL Server
O suporte ao modelo de grafos (LPG) também está implementado no Microsoft SQL Server de forma : oferece tabelas especiais para armazenar os nós e para armazenar as arestas do grafo. Essas tabelas são criadas usando as expressões CREATE TABLE AS NODE e CREATE TABLE AS EDGE respectivamente.
As tabelas do primeiro tipo são semelhantes às tabelas comuns para armazenar registros, com a única diferença externa de que a tabela contém um campo de sistema $node_id — um identificador único dentro do banco de dados para o nó do grafo.
Da mesma forma, as tabelas do segundo tipo possuem campos de sistema $from_id e $to_id, e os registros nessas tabelas definem claramente as conexões entre os nós. Para armazenar conexões de cada tipo, é utilizada uma tabela separada.
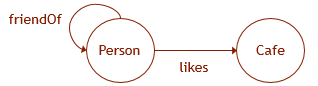 Ilustremos o que foi dito com um exemplo. Suponha que os dados do grafo tenham um esquema como o apresentado na figura. Então, para criar a estrutura correspondente no banco de dados, é necessário executar as seguintes consultas DDL:
CREATE TABLE Person (
  ID INTEGER NOT NULL,
  name VARCHAR(100)
) AS NODE;

CREATE TABLE Cafe (
  ID INTEGER NOT NULL,
  name VARCHAR(100),
) AS NODE;

CREATE TABLE likes (
  rating INTEGER
) AS EDGE;

CREATE TABLE friendOf
  AS EDGE;

ALTER TABLE likes
  ADD CONSTRAINT EC_LIKES CONNECTION (Person TO Cafe);
A principal especificidade dessas tabelas reside no fato de que em consultas a elas é possível usar padrões de grafo com uma sintaxe semelhante ao Cypher (embora ‘*’ e outros ainda não sejam suportados). Com base nas medições de desempenho, também se pode supor que a forma de armazenamento de dados nessas tabelas é diferente do mecanismo de armazenamento de dados em tabelas comuns e é otimizada para a execução de tais consultas gráficas.
SELECT Cafe.name
  FROM Person, likes, Cafe
  WHERE MATCH (Person-(friendOf)-(likes)->Cafe)
  AND Person.name = 'John';
Além disso, é bastante difícil não usar esses padrões de grafo ao trabalhar com tais tabelas, uma vez que em consultas SQL normais para resolver tarefas semelhantes, serão necessários esforços adicionais para obter os identificadores de nós "gráficos" do sistema ($node_id, $from_id, $to_id; por essa mesma razão, as consultas para inserção de dados não estão incluídas aqui como excessivamente volumosas).
Ao resumir a descrição das implementações dos modelos documentais e de grafo no MS SQL Server, eu destacaria que tais implementações de um modelo sobre o outro não parecem ser bem-sucedidas, principalmente do ponto de vista do design da linguagem. É necessário expandir uma linguagem com a outra, as linguagens não são totalmente "ortogonais", e as regras de compatibilidade podem ser bastante peculiares.
SGBDs multimodais baseados no modelo de documento
Nesta seção, gostaria de ilustrar a implementação da multimodalidade em bancos de dados documentais, utilizando como exemplo uma das menos populares, a MongoDB (como mencionado, ela possui apenas operadores gráficos condicionais $lookup e $graphLookup, que não funcionam em coleções shardadas), mas sim com um banco de dados mais maduro e "empresarial". .
Assim, suponha que a coleção contenha um conjunto de documentos XML do seguinte formato (o MarkLogic também permite armazenar documentos JSON):
John
  Smith
Modelo relacional no MarkLogic
A representação relacional da coleção de documentos pode ser criada com o auxílio de (o conteúdo dos elementos valor no exemplo abaixo pode ser qualquer XPath):
/Person


      Person


          SSN
          @SSN
          string


          name
          name


          surname
          surname
O modelo criado pode ser acessado por uma consulta SQL (por exemplo, via ODBC):
SELECT name, surname FROM Person WHERE name="John"Infelizmente, a representação relacional criada com o modelo de mapeamento é somente leitura. Ao processar uma consulta a ele, o MarkLogic tentará usar . Anteriormente, o MarkLogic tinha representações relacionais limitadas, inteiramente e disponíveis para gravação, mas agora são consideradas obsoletas.
Modelo gráfico no MarkLogic
Com suporte ao modelo gráfico (RDF), tudo funciona mais ou menos da mesma forma. Novamente, com a ajuda de é possível criar uma representação RDF da coleção de documentos do exemplo acima:
/Person
PREFIX
"http://example.org/example#"
sem:iri( $PREFIX || @SSN )
sem:iri( $PREFIX || surname )
sem:iri( $PREFIX || @SSN )
sem:iri( $PREFIX || name )
A consulta SPARQL pode ser endereçada ao gráfico RDF resultante:
PREFIX :
SELECT ?name ?surname {
  :631803299804 :name ?name ; :surname ?surname .
}
Diferente do modelo relacional, o MarkLogic suporta o modelo gráfico de duas outras maneiras:
- O SGBD pode ser um repositório RDF completo (os tripletos nele serão chamados de em contraste com os descritos acima ).
- O RDF em uma serialização especial pode ser simplesmente inserido em documentos XML ou JSON (e os tripletos serão então chamados de ). Provavelmente, esta é uma alternativa aos mecanismos de
idrefetc.
Uma boa representação de como "realmente" tudo funciona no MarkLogic é dada por , nesse sentido é de baixo nível, embora seu propósito seja na verdade o oposto — tentar abstrair do modelo de dados utilizado, garantir um funcionamento consistente com dados em diferentes modelos, transacionalidade, etc.
SGBDs multimodais "sem modelo principal"
No mercado também existem SGBDs que se posicionam como inicialmente multimodais, sem nenhum modelo base herdado. Entre eles estão , (desde 2018 a empresa desenvolvedora pertence à SAP) e (serviço como parte da plataforma em nuvem Microsoft Azure).
Na verdade, existem "modelos principais" no ArangoDB e no OrientDB. Em ambos os casos, são modelos de dados próprios, que são generalizações do modelo documental. As generalizações consistem principalmente em facilitar a possibilidade de realizar consultas de natureza gráfica e relacional.
Esses modelos são os únicos disponíveis para uso nas SGBDs indicadas, e suas linguagens de consulta foram projetadas especificamente para trabalhar com eles. Sem dúvida, esses modelos e SGBDs são promissores, mas a falta de compatibilidade com modelos e linguagens padrão torna impossível o uso desses SGBDs em sistemas legados — sua substituição pelos SGBDs já utilizados lá.
Sobre ArangoDB e OrientDB, já houve um excelente artigo no Habr: .
ArangoDB
A ArangoDB afirma suportar o modelo de dados em grafos.
Os nós do grafo na ArangoDB são documentos comuns, enquanto arestas são documentos de um tipo especial, contendo campos sistêmicos comuns (_key, _id, _rev) e campos sistêmicos _from e _to. Documentos em SGBDs documentais tradicionalmente se agrupam em coleções. Coleções de documentos que representam arestas são chamadas de coleções de arestas na ArangoDB. Vale notar que os documentos das coleções de arestas também são documentos, então as arestas na ArangoDB podem funcionar também como nós.
Dados de origem
Suponha que temos uma coleção persons, cujos documentos se parecem com isto:
[
  {
    "_id"  : "people/alice" ,
    "_key" : "alice" ,
    "name" : "Alice"
  },
  {
    "_id"  : "people/bob" ,
    "_key" : "bob" ,
    "name" : "Bob"
  }
]
Suponha também que existe uma coleção cafes:
[
  {
    "_id" : "cafes/jd" ,
    "_key" : "jd" ,
    "name" : "John Donne"
  },
  {
    "_id" : "cafes/jj" ,
    "_key" : "jj" ,
    "name" : "Jean-Jacques"
  }
]
Então a coleção likes pode ter a seguinte aparência:
[
  {
    "_id" : "likes/1" ,
    "_key" : "1" ,
    "_from" : "persons/alice" ,
    "_to" : "cafes/jd",
    "since" : 2010
  },
  {
    "_id" : "likes/2" ,
    "_key" : "2" ,
    "_from" : "persons/alice" ,
    "_to" : "cafes/jj",
    "since" : 2011
  } ,
  {
    "_id" : "likes/3" ,
    "_key" : "3" ,
    "_from" : "persons/bob" ,
    "_to" : "cafes/jd",
    "since" : 2012
  }
]
Consultas e resultados
Uma consulta em estilo de grafo na linguagem AQL usada na ArangoDB, que retorna de forma legível as informações sobre qual café agrada a quem, é assim:
FOR p IN persons
  FOR c IN OUTBOUND p likes
  RETURN { person : p.name , likes : c.name }
Em estilo relacional, quando na verdade 'calculamos' as relações, em vez de armazená-las, essa consulta pode ser reescrita assim (vale mencionar que sem a coleção likes poderíamos nos livrar dela):
FOR p IN persons
  FOR l IN likes
  FILTER p._key == l._from
    FOR c IN cafes
    FILTER l._to == c._key
    RETURN { person : p.name , likes : c.name }
O resultado em ambos os casos será o mesmo:
[
  { "person" : "Alice" , likes : "Jean-Jacques" } ,
  { "person" : "Alice" , likes : "John Donne" } ,
  { "person" : "Bob" , likes : "John Donne" }
]
Mais consultas e resultados
Se parecer que o formato do resultado acima é mais característico de um SGBD relacional do que de um documento, você pode tentar esta consulta (ou utilizar ):
FOR p IN persons
  RETURN {
    person : p.name,
    likes : (
      FOR c IN OUTBOUND p likes
      RETURN c.name
    )
}
O resultado terá a seguinte aparência:
[
  { "person" : "Alice" , likes : ["Jean-Jacques" , "John Donne"]  } ,
  { "person" : "Bob" , likes : ["John Donne"] }
]
OrientDB
A implementação do modelo gráfico sobre o documento no OrientDB é baseada em campos de documentos que, além de valores escalares mais ou menos padrão, podem ter também valores de tipos como LINK, LINKLIST, LINKSET, LINKMAP e LINKBAG. Os valores desses tipos são referências ou coleções de referências a documentos.
O identificador de documento atribuído pelo sistema tem um "sentido físico", indicando a posição do registro na base, e se parece com isso: @rid : #3:16. Assim, os valores de propriedades de referência são realmente mais como ponteiros (como no modelo gráfico), e não critérios de seleção (como no relacional).
Assim como no ArangoDB, no OrientDB as arestas são representadas como documentos separados (embora, se uma aresta não tiver suas próprias propriedades, ela pode ser , e não corresponderá a um documento separado).
Dados de origem
No formato aproximado de da base OrientDB, os dados do exemplo anterior para o ArangoDB teriam aparência aproximada a esta:
[
     {
      "@type": "document",
      "@rid": "#11:0",
      "@class": "Person",
      "name": "Alice",
      "out_likes": [
        "#30:1",
        "#30:2"
      ],
      "@fieldTypes": "out_likes=LINKBAG"
    },
    {
      "@type": "document",
      "@rid": "#12:0",
      "@class": "Person",
      "name": "Bob",
      "out_likes": [
        "#30:3"
      ],
      "@fieldTypes": "out_likes=LINKBAG"
    },
    {
      "@type": "document",
      "@rid": "#21:0",
      "@class": "Cafe",
      "name": "Jean-Jacques",
      "in_likes": [
        "#30:2",
        "#30:3"
      ],
      "@fieldTypes": "in_likes=LINKBAG"
    },
    {
      "@type": "document",
      "@rid": "#22:0",
      "@class": "Cafe",
      "name": "John Donne",
      "in_likes": [
        "#30:1"
      ],
      "@fieldTypes": "in_likes=LINKBAG"
    },
    {
      "@type": "document",
      "@rid": "#30:1",
      "@class": "likes",
      "in": "#22:0",
      "out": "#11:0",
      "since": 1262286000000,
      "@fieldTypes": "in=LINK,out=LINK,since=date"
    },
    {
      "@type": "document",
      "@rid": "#30:2",
      "@class": "likes",
      "in": "#21:0",
      "out": "#11:0",
      "since": 1293822000000,
      "@fieldTypes": "in=LINK,out=LINK,since=date"
    },
    {
      "@type": "document",
      "@rid": "#30:3",
      "@class": "likes",
      "in": "#21:0",
      "out": "#12:0",
      "since": 1325354400000,
      "@fieldTypes": "in=LINK,out=LINK,since=date"
    }
  ]
Como vemos, os vértices também armazenam informações sobre arestas de entrada e saída. Durante O Document API para garantir a integridade referencial precisa ser monitorado manualmente, enquanto o Graph API cuida desse trabalho. Mas vamos ver como as chamadas para o OrientDB aparecem em linguagens de consulta "limpas", não integradas nas linguagens de programação.
Consultas e resultados
Uma consulta semelhante à da ArangoDB no exemplo para o OrientDB aparece assim:
SELECT name AS person_name, OUT('likes').name AS cafe_name
   FROM Person
   UNWIND cafe_name
O resultado será obtido da seguinte forma:
[
  { "person_name": "Alice", "cafe_name": "John Donne" },
  { "person_name": "Alice", "cafe_name": "Jean-Jacques" },
  { "person_name": "Bob",  "cafe_name": "Jean-Jacques" }
]
Se o formato do resultado parecer excessivamente "relacional" novamente, é necessário remover a linha com :
[
  { "person_name": "Alice", "cafe_name": [ "John Donne", "Jean-Jacques" ] },
  { "person_name": "Bob",  "cafe_name": [ "Jean-Jacques" ] }
]
A linguagem de consulta do OrientDB pode ser caracterizada como SQL com inserções semelhantes ao Gremlin. Na versão 2.2, uma forma semelhante ao Cypher foi introduzida, :
MATCH {CLASS: Person, AS: person}-likes-> {CLASS: Cafe, AS: cafe}
RETURN person.name AS person_name, LIST(cafe.name) AS cafe_name
GROUP BY person_name
O formato do resultado será o mesmo que na consulta anterior. Pense no que precisa ser removido para torná-lo mais "relacional", assim como na primeira consulta.
Azure CosmosDB
A afirmação acima sobre ArangoDB e OrientDB se aplica em menor grau ao Azure CosmosDB. O CosmosDB oferece os seguintes APIs de acesso a dados: SQL, MongoDB, Gremlin e Cassandra.
As APIs SQL e MongoDB são usadas para acessar dados no modelo de documento. As APIs Gremlin e Cassandra são usadas para acessar dados, respectivamente, em modelo gráfico e coluna. ("atom-record-sequence"), que também é semelhante ao de documento.
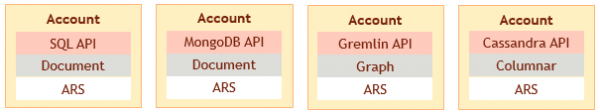
Mas o modelo de dados escolhido pelo usuário e a API utilizada são fixados no momento da criação da conta no serviço. Não é possível acessar dados carregados em um modelo no formato de outro modelo, o que poderia ser ilustrado aproximadamente assim:
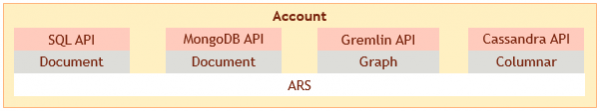
Dessa forma, a multimodalidade no Azure CosmosDB atualmente representa apenas a possibilidade de usar vários bancos de dados que suportam diferentes modelos, todos de um único fornecedor, o que não soluciona todos os problemas de armazenamento multimodal.
SGBDs multimodais baseados no modelo gráfico?
É notável que o mercado ainda não possui bancos de dados multimodais com base em um modelo gráfico (exceto se considerarmos multimodalidade o suporte simultâneo a dois modelos gráficos: RDF e LPG; veja sobre isso em ). Os maiores desafios estão na implementação sobre o modelo gráfico de documentos, e não relacional.
A questão de como implementar um modelo relacional sobre o modelo gráfico foi discutida desde os primórdios deste último. Como , por exemplo, :
Não há nada inerente à abordagem gráfica que impeça a criação de uma camada (por exemplo, por meio de indexação adequada) em um banco de dados gráfico que permita uma visão relacional com (1) recuperação de tuplas a partir dos pares de chave-valor habituais e (2) agrupamento de tuplas por tipo de relação.
Ao implementar um modelo de documentos sobre um gráfico, é preciso ter em mente, por exemplo, o seguinte:
- Os elementos do array JSON são considerados ordenados, enquanto os que emergem do vértice da aresta do gráfico não são;
- Os dados no modelo de documentos são geralmente desnormalizados, e ter várias cópias do mesmo documento aninhado não é desejável, além de que, em geral, subdocumentos não têm identificadores;
- Por outro lado, a ideologia dos bancos de dados documentais é que os documentos são agregados prontos que não precisam ser construídos novamente a cada vez. É necessário garantir na modelo gráfico a possibilidade de obter rapidamente um subgráfico correspondente ao documento pronto.
Um pouco de publicidade
O autor do artigo está envolvido no desenvolvimento do banco de dados NitrosBase, cujo modelo interno é gráfico, enquanto os modelos externos — relacional e documental — são representações dele. Todos os modelos são igualmente válidos: praticamente quaisquer dados estão acessíveis em qualquer um deles usando sua linguagem de consulta natural. Além disso, em qualquer representação, os dados podem ser alterados. As alterações serão refletidas no modelo interno e, consequentemente, nas outras representações.
Como se dá a correspondência entre os modelos no NitrosBase — descreverei, espero, em um dos próximos artigos.
Conclusão
Espero que os contornos gerais do que se chama multimodalidade tenham se tornado mais ou menos claros para o leitor. Chamamos de multimodais bancos de dados bastante distintos, e o "suporte a vários modelos" pode parecer diferente. Para entender o que se entende por "multimodalidade" em cada caso específico, é útil responder às seguintes perguntas:
- Estamos falando sobre o suporte a modelos tradicionais ou sobre algum tipo de modelo "híbrido"?
- Os modelos são "igualmente válidos", ou um deles é subordinado aos outros?
- As modelos são "indiferentes" umas às outras? Os dados gravados em um modelo podem ser lidos em outro ou até mesmo sobrescritos?
Acredito que já podemos dar uma resposta positiva à pergunta sobre a relevância das DBMS multimodelo, mas o que me intriga é quais tipos serão mais procurados em breve. Parece que os DBMS multimodelo que suportam modelos tradicionais, principalmente o relacional, terão maior demanda; a popularidade dos DBMS multimodelo que oferecem novos modelos, combinando as vantagens de vários modelos tradicionais, ficará para um futuro mais distante.
Apenas usuários registrados podem participar da pesquisa. , por favor.
Você utiliza DBMS multimodelo?
Não utilizamos, armazenamos tudo em um único DBMS e em um único modelo.
Utilizamos as capacidades multimodelo de DBMS tradicionais.
Praticamos armazenamento poliglota (polyglot persistence).
Estamos utilizando novos DBMS multimodelo (Arango, Orient, CosmosDB).
19 usuários votaram. 4 usuários se abstiveram.
Fonte: habr.com
