

O artigo consiste em duas partes:
- Uma breve descrição de algumas arquiteturas de redes para detecção de objetos em imagens e segmentação de imagens, com referências mais compreensíveis para mim. Procurei selecionar vídeos explicativos, preferencialmente em russo.
- A segunda parte consiste em uma tentativa de compreender a direção do desenvolvimento das arquiteturas de redes neurais. E as tecnologias com base nelas.
Figura 1 - Compreender as arquiteturas de redes neurais não é fácil.
Tudo começou quando desenvolvi dois aplicativos demonstrativos para classificação e detecção de objetos em um telefone Android:
- , onde os dados são processados no servidor e transmitidos para o telefone. Classificação de imagens (image classification) de três tipos de ursos: pardo, negro e de pelúcia.
- , onde os dados são processados no próprio telefone. Detecção de objetos (object detection) de três tipos: avelã, figo e tâmara.
Há uma diferença entre as tarefas de classificação de imagens, detecção de objetos em imagens e . Portanto, surgiu a necessidade de saber quais arquiteturas de redes neurais detectam objetos em imagens e quais podem segmentar. Encontrei os seguintes exemplos de arquiteturas com referências mais compreensíveis para mim:
- Série de arquiteturas baseadas em R-CNN (Regions with Convolution Neural Networks features): R-CNN, Fast R-CNN, , . Para a detecção de objetos em uma imagem, o mecanismo Region Proposal Network (RPN) destaca regiões delimitadas (bounding boxes). Inicialmente, em vez do RPN, utilizava-se um mecanismo mais lento chamado Selective Search. Depois, as regiões delimitadas destacadas são fornecidas à rede neural comum para classificação. Na arquitetura R-CNN, há ciclos explícitos "for" percorrendo as regiões delimitadas, totalizando até 2000 passagens pela rede interna AlexNet. Devido aos ciclos explícitos "for", a velocidade de processamento de imagens é reduzida. O número de ciclos explícitos, de passagens pela rede neural interna, diminui a cada nova versão da arquitetura, além de serem realizadas dezenas de outras alterações para aumentar a velocidade e para substituir a tarefa de detecção de objetos pela segmentação de objetos no Mask R-CNN.
- (You Only Look Once) – a primeira rede neural que reconheceu objetos em tempo real em dispositivos móveis. A característica distintiva: a distinção de objetos em uma única execução (bastando olhar uma vez). Ou seja, na arquitetura YOLO não há ciclos explícitos de 'for', o que torna a rede rápida. Por exemplo, uma analogia: no NumPy, ao trabalhar com matrizes, também não existem ciclos 'for' explícitos, que são implementados a níveis mais baixos da arquitetura através da linguagem de programação C. O YOLO utiliza uma grade de janelas predefinidas. Para que o mesmo objeto não seja identificado repetidamente, é utilizado o coeficiente de sobreposição de janelas (IoU, Iinterseção osuperior Uunião). Essa arquitetura opera em uma ampla faixa e possui alta : o modelo pode ser treinado em fotografias, mas ainda assim funciona bem em pinturas desenhadas.
- (Ssingle Sshot MultiBox Ddetector) – são usadas as 'hacks' mais eficazes da arquitetura YOLO (por exemplo, supressão de não-máximos) e novas são adicionadas para que a rede neural funcione de forma mais rápida e precisa. A característica distintiva: a distinção de objetos em uma única execução usando uma grade de janelas (default box) em uma pirâmide de imagens. A pirâmide de imagens é codificada em tensores convolucionais durante operações sequenciais de convolução e agrupamento (na operação de max-pooling, a dimensão espacial diminui). Assim, tanto objetos grandes quanto pequenos são determinados em uma única execução da rede.
- MobileSSD (MobileNetV2 + SSD) – uma combinação de duas arquiteturas de redes neurais. A primeira rede opera rapidamente e aumenta a precisão do reconhecimento. O MobileNetV2 é usado em vez do VGG-16, que foi inicialmente utilizado em . A segunda rede SSD determina a localização dos objetos na imagem.
- – uma rede neural muito pequena, mas precisa. Sozinha, não resolve a tarefa de detecção de objetos. No entanto, pode ser usada em combinação com várias arquiteturas. E utilizada em dispositivos móveis. A característica distintiva é que inicialmente os dados são comprimidos para quatro filtros convolucionais 1×1, e depois expandidos para quatro filtros 1×1 e quatro filtros 3×3. Uma iteração de compressão-expansão de dados é chamada de 'Fire Module'.
- (Segmentação de Imagem Semântica com Redes Neurais Convolucionais Profundas) – segmentação de objetos em uma imagem. A principal característica da arquitetura é a convolução esparsa (dilated convolution), que preserva a resolução espacial. Em seguida, ocorre uma etapa de pós-processamento dos resultados utilizando um modelo probabilístico gráfico (conditional random field), o que permite remover pequenos ruídos na segmentação e melhorar a qualidade da imagem segmentada. Por trás do assustador nome 'modelo probabilístico gráfico' esconde-se um simples filtro Gaussiano, que é aproximado por cinco pontos.
- Tentei entender o funcionamento (Single-Shot Refinement Neural Network for Object Detecção), mas pouco consegui compreender.
- Também vi como funciona a tecnologia 'atenção' (attention): , , . A característica distintiva da arquitetura 'atenção' é a identificação automática de regiões de maior atenção na imagem (RoI, Regions of Interest) por meio de uma rede neural chamada Unidade de Atenção. As regiões de maior atenção se assemelham a caixas delimitadoras (bounding boxes), mas ao contrário destas, não estão fixas na imagem e podem ter bordas borradas. A partir das regiões de maior atenção, são extraídos características (features), que são 'alimentadas' a redes neurais recorrentes com arquiteturas . Redes neurais recorrentes conseguem analisar as inter-relações das características em uma sequência. Originalmente, redes neurais recorrentes eram aplicadas para traduções de texto para outros idiomas, e agora também para a tradução e .
Conforme fui estudando essas arquiteturas compreendi que não entendia nada. E não é que minha rede neural tenha problemas com o mecanismo de atenção. A criação de todas essas arquiteturas parece um enorme hackathon, onde os autores competem em hacks. Hack – uma solução rápida para um problema de programação complicado. Ou seja, não há uma conexão lógica visível e compreensível entre todas essas arquiteturas. Tudo o que as une é um conjunto dos hacks mais bem-sucedidos que eles tomam uns dos outros, além da operação comum a todas (retropropagação do erro, backpropagation). Não há ! Não está claro o que mudar e como otimizar os progressos existentes.
Como resultado da falta de conexão lógica entre os hacks, é extremamente difícil lembrá-los e aplicá-los na prática. Trata-se de um conhecimento fragmentado. No melhor dos casos, algumas informações interessantes e inesperadas são memorizadas, mas a maior parte do que foi compreendido e não compreendido desaparece da memória em poucos dias. Será positivo se, após uma semana, ao menos o nome da arquitetura for lembrado. E olhe que foram gastos algumas horas e até dias de trabalho na leitura de artigos e na visualização de vídeos resumidos!
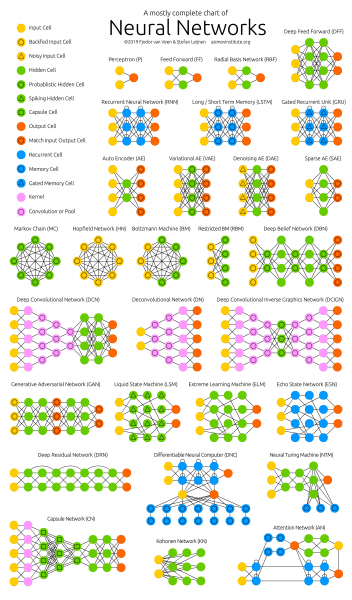
Figura 2 –
Na minha opinião pessoal, a maioria dos autores de artigos científicos faz o possível para que até mesmo esses conhecimentos fragmentados não sejam compreendidos pelo leitor. Mas as construções com gerúndios em frases de dez linhas com fórmulas tiradas "do nada" – esse é um tema para um artigo à parte (problema ).
Por essa razão, surgiu a necessidade de sistematizar informações sobre redes neurais e, assim, aumentar a qualidade da compreensão e memorização. Portanto, o tema principal da análise de tecnologias e arquiteturas específicas de redes neurais artificiais foi a seguinte tarefa: descobrir para onde tudo isso está se dirigindo, e não o funcionamento de uma rede neural específica isoladamente.
Para onde tudo isso está se dirigindo. Principais resultados:
- O número de startups na área de aprendizado de máquina nos últimos dois anos . Possível motivo: "as redes neurais deixaram de ser algo novo".
- Qualquer um pode criar uma rede neural funcional para resolver uma tarefa simples. Para isso, pode pegar um modelo pronto do "zoológico de modelos" (model zoo) e treinar a última camada da rede neural () com dados já prontos de ou de no gratuito .
- Grandes produtores de redes neurais começaram a criar "zoológicos de modelos" (model zoo). Com eles, é possível rapidamente criar um aplicativo comercial: para TensorFlow, para PyTorch, para Caffe2, para Chainer e .
- Redes neurais operando em tempo real para dispositivos móveis. De 10 a 50 quadros por segundo.
- A aplicação de redes neurais em telefones (TF Lite), em navegadores (TF.js) e em (IoT, Iinternet of Tdas coisas). Especialmente em telefones, que já suportam redes neurais em nível "hardware" (neuroaceleradores).
- «Cada dispositivo, roupas e, possivelmente, até mesmo alimentos terão endereço IP-v6 e se comunicarão entre si» – .
- O aumento das publicações sobre aprendizado de máquina começou (dobrando a cada dois anos) desde 2015. É evidente que precisamos de redes neurais para analisar artigos.
- As seguintes tecnologias estão ganhando popularidade:
- PyTorch – a popularidade cresce rapidamente e, aparentemente, está superando o TensorFlow.
- Ajuste automático de hiperparâmetros AutoML – a popularidade cresce de forma gradual.
- Diminuição progressiva da precisão e aumento da velocidade de cálculos: , algoritmos , cálculos imprecisos (aproximados), quantização (quando os pesos da rede neural são convertidos em inteiros e quantizados), neuroaceleradores.
- Tradução e .
- Criar , agora em tempo real.
- O principal em DL é que há muitos dados, mas coletá-los e anotá-los não é fácil. Portanto, a automação da anotação está se desenvolvendo () para redes neurais com a ajuda de redes neurais.
- Com as redes neurais, a Ciência da Computação de repente se tornou uma ciência experimental e surgiu .
- O dinheiro de TI e a popularidade das redes neurais surgiram ao mesmo tempo, quando o poder de computação se tornou valioso no mercado. A economia deixa de ser baseada em metais preciosos e se torna baseada em poder computacional.Veja meu artigo sobre e os motivos para o surgimento do dinheiro de TI.
Gradualmente, uma nova (Machine Learning & Deep Learning), que é baseada na representação do programa como um conjunto de modelos de redes neurais treinadas.
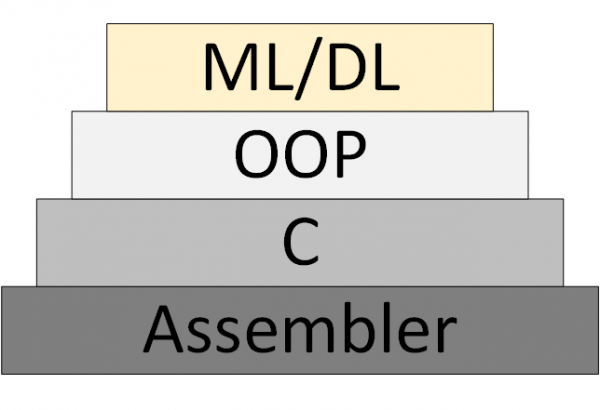
Figura 3 – ML/DL como nova metodologia de programação
No entanto, não surgiu uma «teoria das redes neurais», dentro da qual se pode pensar e trabalhar de forma sistemática. O que agora é chamado de «teoria» é, na verdade, algoritmos experimentais e heurísticos.
Links para meus e outros recursos:
- Newsletter sobre Data Science. Principalmente, sobre processamento de imagens. Quem quiser receber, pode enviar um e-mail (foobar167<áfá>gmail<ponto>com). Envio links para artigos e vídeos à medida que o material se acumula.
- Lista geral , que eu completei e que gostaria de fazer.
- , com os quais vale a pena começar a estudar redes neurais. Além disso, um folheto .
- , onde cada um encontrará algo interessante para si.
- Foram extremamente úteis os canais de vídeo sobre a análise de artigos científicos em Data Science. Encontre, inscreva-se nesses canais e compartilhe os links com seus colegas e comigo também. Exemplos:
- ou com tutoriais passo a passo e código-fonte aberto.
Obrigado pela atenção!
Fonte: habr.com
