

Para discussão na lista de correio dos desenvolvedores do núcleo do Linux, foram publicados patches implementando o sistema de arquivos BeamFS, que utiliza a codificação de Reed-Solomon para identificar e recuperar dados corrompidos em configurações com um único armazenamento. As principais áreas de aplicação do BeamFS incluem computadores embarcados em satélites, equipamentos em salas de terapia com radiação e outros sistemas operando em ambientes de alta radiação, onde a recuperação de dados corrompidos é mais crítica do que a incapacidade de ler a informação.
Por padrão, o BeamFS pode recuperar até 8 bytes perdidos em cada bloco de 255 bytes com um overhead de 7% (288 bytes de códigos de recuperação para cada 4096 bytes de dados armazenados). Os códigos de correção de erros são aplicados não apenas para dados, mas também para informações de controle no superbloco, inode, índices de diretórios e mapas de bits. A verificação de integridade e tentativas de recuperação de dados ausentes são realizadas em cada operação de leitura. Se a correção da informação não for garantida, a operação é encerrada com o erro "-EIO", o que exclui o retorno oculto de dados corrompidos.
Experimentos realizados mostraram que, ao irradiar a placa i.MX 8M Plus com Linux e o sistema de arquivos ext4 com prótons com energia de 20 a 58 MeV, 90% de todas as falhas ocorreram no nível do sistema de arquivos e dos drivers de dispositivos de armazenamento. Também foi realizada uma simulação de distorções de bits isoladas ao ler do meio: o BeamFS e o Btrfs reconheceram com sucesso a corrupção de dados e sempre retornaram um erro, enquanto o ext4 e ext3 retornaram dados corrompidos silenciosamente.
O BeamFS garante integridade e recuperação apenas na fase da leitura do meio físico até a transmissão para o cache de páginas na memória RAM. A integridade dos dados em memória pode ser mantida com chips de memória com correção de erros.
Entre as limitações do BeamFS, destaca-se a falta de suporte a journaling e ao modo Copy-on-Write (CoW) — os metadados são gravados de forma não ordenada no armazenamento, portanto, em caso de desligamento incorreto, é necessária uma verificação completa utilizando fsck.
Além do BeamFS, recentemente foram propostas mais duas sistemas de arquivos para o núcleo do Linux:
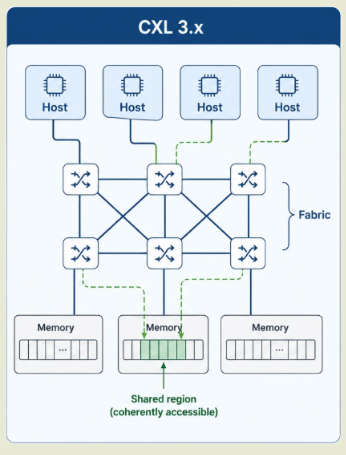
- Na conferência Linux Plumbers Conference 2026, realizada há alguns dias, um engenheiro da Huawei apresentou (vídeo, slides) o sistema de arquivos XMFS (cross-node eXpress Memory File System) para o kernel Linux, destinado ao uso em clusters com memória RAM compartilhada entre todos os nós (semelhante ao tmpfs, mas para a memória de todos os nós). O XMFS permite o uso de uma interface de sistema de arquivos POSIX padrão para interagir com a memória externa, acessível diretamente através de tecnologias como CXL 3.0 (Compute Express Link) e Huawei United Bus. O projeto está na fase de protótipo experimental, passando por testes internos, e ainda não está pronto para ser integrado ao kernel.

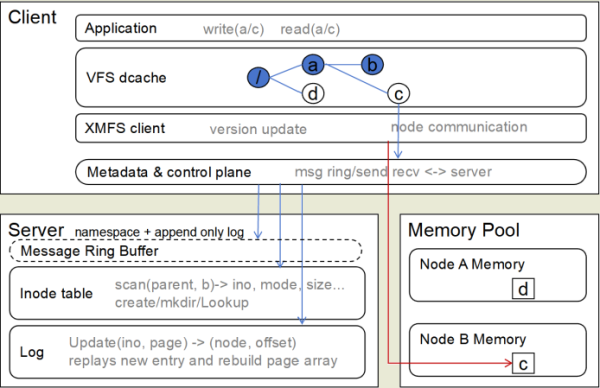
O sistema de arquivos tem uma arquitetura clássica para sistemas de arquivos distribuídos, com a designação servidor, responsável pelo registro de logs, manutenção das tabelas de inode e correspondência do conteúdo e metadados com a memória dos nós individuais.

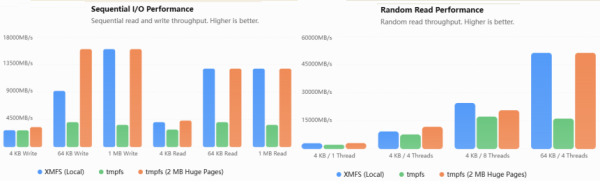
Ao testar o uso do XMFS para tarefas como compartilhamento de imagens de contêineres entre diferentes nós, a implementação mostrou desempenho próximo ao do tmpfs com a inclusão de grandes páginas de memória (2 MB huge pages).


- Com o auxílio da IA, foi desenvolvida a sistema de arquivos MeshXFS, um fork do XFS, adaptado para uso simultâneo em vários nós em um cluster. O MeshXFS permite montar um dispositivo de bloco compartilhado em modo de leitura e gravação em diferentes nós, mantendo a integridade e gerenciando bloqueios durante o acesso simultâneo aos dados. O projeto começou como uma experiência para testar a possibilidade de criar um driver Linux com sistema de arquivos, suportando bloqueios distribuídos, acesso paralelo e recuperação após falhas, utilizando modelos de IA. O trabalho principal foi realizado com o Claude Opus, mas para resolver problemas particularmente complexos, modelos como Claude Fable, GPT, Gemini e Astra foram pontualmente utilizados. O experimento foi considerado bem-sucedido e várias versões funcionais do MeshXFS já foram publicadas.
Entre os recursos adicionais implementados sobre o XFS, destacam-se dois modos de gerenciamento de bloqueios distribuídos (sincronização de rede e armazenamento de estado em um único disco compartilhado), garantindo a consistência do cache entre diferentes nós, manutenção de um registro para recuperação e adaptação do formato de disco e utilitários para as especificidades do sistema de arquivos em cluster. O suporte para armazenamento compartilhado conectado via iSCSI é mantido (testado em 16 nós), ou durante a replicação de dispositivos de bloco usando DRBD. A coordenação de bloqueios, funções de detecção de nós, verificação de disponibilidade e identificação de nós com falha estão implementadas em um único módulo central do kernel. O funcionamento foi testado no Proxmox VE 9, RHEL 9, Ubuntu 24.04/26.04 e Debian 12/13.
Fonte: opennet.ru
