

O original do artigo foi publicado no site e publicado na 3DNews com a permissão do autor. Apresentamos o texto completo do artigo, exceto por uma enorme quantidade de links — eles serão úteis para aqueles que realmente se interessaram pelo tema e gostariam de estudar os aspectos teóricos da fotografia computacional mais a fundo, mas para o público em geral, consideramos esse material excessivo.
Hoje em dia, nenhuma apresentação de smartphone deixa de lado o exame da câmera. Todo mês ouvimos sobre mais um avanço nas câmeras móveis: o Google ensina a Pixel a fotografar no escuro, a Huawei faz zoom como um binóculo, a Samsung incorpora lidar, e a Apple faz os cantos mais arredondados do mundo. Raramente vemos tantas inovações fluindo.
As câmeras DSLR parecem estar estagnadas. A Sony anualmente apresenta novos sensores, enquanto os fabricantes atualizam preguiçosamente apenas o número da versão e continuam relaxadamente à margem. Tenho uma DSLR que custa $3000 em minha mesa, mas quando viajo, levo meu iPhone. Por quê?
Como disse o clássico — eu fui à internet com essa pergunta. As pessoas discutem sobre algum 'algoritmo' e 'redes neurais', sem saber como exatamente eles afetam a fotografia. Jornalistas declaram em voz alta o número de megapixels, blogueiros fazem unboxings pagos em coro, e os estetas se lambuzam com a 'percepção sensorial da paleta de cores do sensor'. Tudo como de costume.
Tive que me sentar, gastar metade da vida e entender tudo por conta própria. Neste artigo, contarei o que aprendi.
O que é fotografia computacional?
Em todos os lugares, inclusive na Wikipédia, encontramos uma definição semelhante: fotografia computacional — qualquer técnica de captura e processamento de imagens onde, em vez de transformações ópticas, são usados cálculos digitais. Ele está correto, exceto pelo fato de que não explica nada. Até a autofoco se encaixa nisso, mas a óptica de plenitude, que já nos trouxe muitos benefícios, não se encaixa. A vaguidão das definições oficiais sugere que não temos ideia do que estamos falando.
Pioneiro da fotografia computacional, o professor da Stanford, Marc Levoy (que agora é responsável pela câmera do Google Pixel), apresenta outra definição — um conjunto de métodos de visão computacional que melhoram ou expandem as capacidades da fotografia digital, dos quais resulta uma fotografia comum que não poderia tecnicamente ser capturada por essa câmera de forma tradicional. Neste artigo, sigo precisamente essa definição.
Portanto, os culpados foram os smartphones.
Os smartphones não tiveram escolha a não ser dar vida a um novo tipo de fotografia — a computacional.
Seus pequenos sensores barulhentos e lentes minúsculas com baixa abertura deveriam, segundo todas as leis da física, causar apenas dor e sofrimento. E causaram, até que seus desenvolvedores encontraram uma maneira inteligente de usar suas forças para superar suas fraquezas — obturadores eletrônicos rápidos, processadores poderosos e software.
A maioria das pesquisas importantes na área da fotografia computacional ocorreu entre 2005 e 2015, o que na ciência é considerado literalmente ontem. Neste momento, diante de nossos olhos e em nossos bolsos, está se desenvolvendo uma nova área de conhecimento e tecnologia que nunca existiu antes.
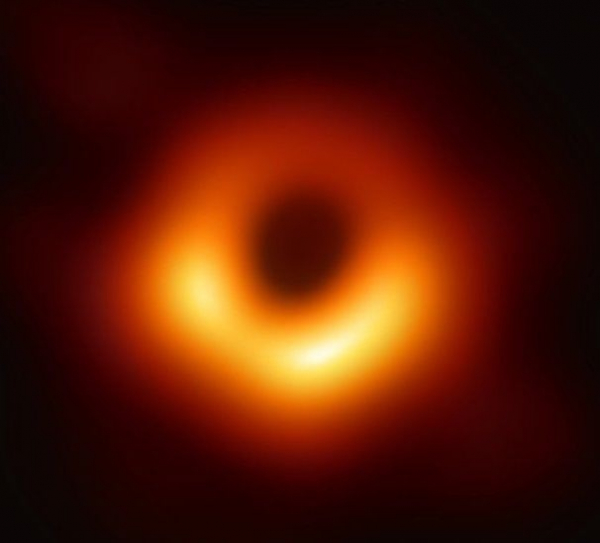
A fotografia computacional não é apenas selfies com bokeh neural. A recente fotografia de um buraco negro não teria sido possível sem métodos de fotografia computacional. Para capturar tal imagem em um telescópio comum, precisaríamos fazer um telescópio do tamanho da Terra. No entanto, ao combinar os dados de oito radiotelescópios em diferentes pontos do nosso planeta e ao escrever alguns scripts em Python, conseguimos obter a primeira fotografia do horizonte de eventos. Também vale para selfies.
Começo: processamento digital
Vamos imaginar que voltamos a 2007. Nossa mãe é a anarquia e nossas fotos são barulhentas JPEGs de 0,6 MP, tiradas em um skate. Foi mais ou menos nesse período que surgiu o primeiro desejo irresistível de aplicar presets para esconder a pobreza dos sensores móveis. Não vamos nos privar disso.
Matan e Instagram
Com o lançamento do Instagram, todos ficaram obcecados por filtros. Como alguém que, em seu tempo, reverteu o X-Pro II, Lo-Fi e Valencia, claro, para fins de pesquisa (risos), ainda me lembro de que esses filtros eram compostos por três componentes:
- Configurações de cor (Hue, Saturation, Lightness, Contrast, Levels, etc.) — coeficientes digitais simples, assim como em qualquer preset que fotógrafos usaram desde os tempos antigos.
- Mapas de mapeamento de tonalidades (Tone Mapping) — vetores de valores, cada um dizendo: "A cor vermelha com tonalidade 128 deve ser convertida para tonalidade 240".
- Sobreposições — imagens semi-transparentes com poeira, grão, vinheta, e tudo mais que pode ser aplicado em cima para obter um efeito que não seja banal de filme antigo. Não apareceu sempre.
Os filtros modernos não se distanciaram muito desse trio, apenas se tornaram um pouco mais complexos em matemática. Com o surgimento de shaders de hardware e OpenCL em smartphones, eles foram rapidamente reescritos para GPU, e isso era considerado incrível. Para 2012, claro. Hoje, qualquer estudante pode fazer algo semelhante em CSS, e ele nem receberá crédito na formatura.
No entanto, o progresso dos filtros não parou hoje. O pessoal da Dehancer, por exemplo, se dedica a filtros não lineares — em vez de um mapeamento de tonalidade proletário, eles usam transformações não lineares mais complexas, o que, segundo eles, abre muito mais possibilidades.
Transformações não lineares podem fazer muitas coisas, mas são incrivelmente complexas, e nós, humanos, somos incrivelmente limitados. Quando a ciência chega a transformações não lineares, preferimos recorrer a métodos numéricos e enfiar redes neurais em tudo para que elas criem obras-primas por nós. O mesmo aconteceu aqui.
Automatização e sonhos de um botão "obra-prima"
Quando todos se acostumaram com filtros, começamos a integrá-los diretamente nas câmeras. A história esconde quem foi o primeiro fabricante, mas só para entender há quanto tempo isso aconteceu — no iOS 5.0, lançado em 2011, já havia uma API pública para Auto Enhancing Images. Somente Jobs sabe há quanto tempo isso foi usado antes de ser aberto ao público.
A automatização fazia o mesmo que cada um de nós ao abrir uma foto no editor — recuperava detalhes nas luzes e sombras, aumentava a saturação, removia olhos vermelhos e ajustava a cor da pele. Os usuários nem suspeitavam que a "câmera dramaticamente melhorada" no novo smartphone era apenas graças a alguns shaders novos. Aguardavam-se ainda cinco anos até o lançamento do Google Pixel e o início do hype sobre fotografia computacional.
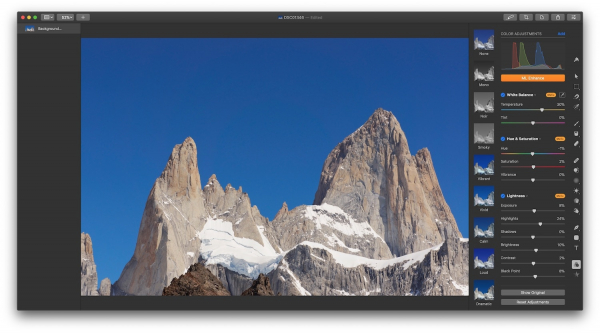
Hoje, as batalhas pelo botão "obra-prima" mudaram para o campo do aprendizado de máquina. Depois de brincar com a tonificação, todos se apressaram a treinar CNNs e GANs, ajustando os controles em vez do usuário. Em outras palavras, a partir da imagem de entrada, determinar um conjunto de parâmetros ótimos que aproximariam essa imagem de uma certa compreensão subjetiva de "boa fotografia". Isso foi implementado no Pixelmator Pro e em outros editores. Funciona, como se pode imaginar, de maneira nem muito boa nem sempre.
O empilhamento — 90% do sucesso das câmeras de celular
A verdadeira fotografia computacional começou com o empilhamento — sobreposição de várias fotos umas sobre as outras. Não é problema para um smartphone tirar uma dúzia de fotos em meio segundo. Em suas câmeras, não há peças mecânicas lentas: a abertura é fixa e, em vez de um obturador mecânico, utiliza-se um obturador eletrônico. O processador simplesmente diz ao sensor quantos microssegundos capturar os fotões aleatórios, enquanto lê o resultado.
Tecnicamente, o telefone pode tirar fotos na velocidade do vídeo e vídeos com a resolução de fotos, mas tudo depende da velocidade do barramento e do processador. Portanto, sempre existem limites programáticos.
O empilhamento está conosco há muito tempo. Nossos avós usavam plugins no Photoshop 7.0 para compor várias fotos em um HDR exuberante ou para montar uma panorâmica de 18000 × 600 pixels e... na realidade, ninguém realmente inventou o que fazer com elas depois. Eram tempos ricos, pena que selvagens.
Agora, crescemos e chamamos isso de "fotografia épsilon" — quando, alterando um dos parâmetros da câmera (exposição, foco, posição) e mesclando os quadros obtidos, conseguimos algo que não poderia ser capturado em uma única foto. Mas esse é um termo para teóricos; na prática, um outro nome — empilhamento — prevaleceu. Hoje, 90% de todas as inovações nas câmeras de celular são baseadas nisso.
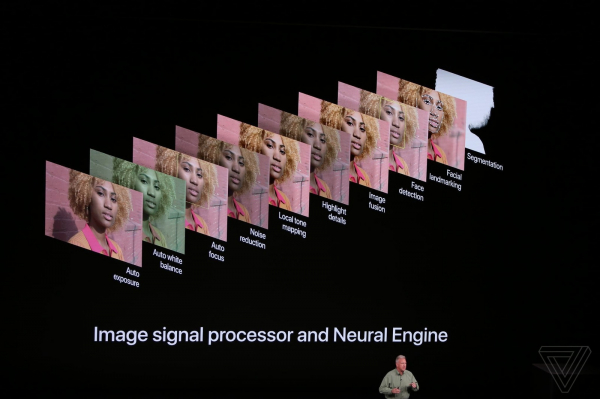
Uma coisa que muitos não pensam, mas que é importante para entender toda a fotografia móvel e computacional: a câmera no smartphone moderno começa a tirar fotos assim que você abre o aplicativo. O que faz sentido, já que ela precisa de algum modo para transmitir a imagem para a tela. No entanto, além da tela, ela armazena quadros de alta resolução em seu próprio buffer cíclico, onde os mantém por alguns segundos.
Quando você pressiona o botão "tirar foto" — a foto já foi tirada, a câmera apenas pega a última imagem do buffer.
Hoje, qualquer câmera móvel funciona assim. Pelo menos em todos os modelos topo de linha que não são de sucata. A bufferização permite realizar não apenas o tão sonhado atraso zero do obturador que os fotógrafos tanto desejavam, mas até mesmo um atraso negativo — ao pressionar o botão, o smartphone olha para o passado, extrai as 5-10 últimas fotos do buffer e começa a analisá-las fervorosamente e a colá-las. Não é mais necessário esperar que o telefone capture imagens para HDR ou modo noturno — basta pegá-las do buffer, o usuário nem perceberá.
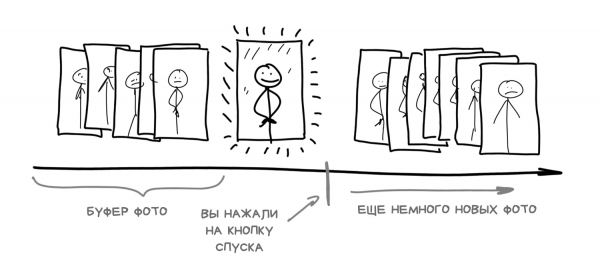
A propósito, foi justamente com o atraso negativo do obturador que as Live Photos nos iPhones foram implementadas, enquanto no HTC algo semelhante já existia em 2013 com o estranho nome de Zoe.
Empilhamento por exposição — HDR e combate a variações de brilho
A capacidade dos sensores de câmeras de registrar toda a gama de brilho disponível para nossos olhos é um antigo e polêmico tema de debates. Alguns dizem que não, uma vez que o olho pode ver até 25 f-stops, enquanto que até mesmo o melhor sensor full-frame pode extrair no máximo 14. Outros consideram a comparação incorreta, pois o cérebro ajuda o olho, ajustando automaticamente a pupila e completando a imagem com suas redes neurais; na verdade, o intervalo dinâmico instantâneo do olho é de apenas 10-14 f-stops. Vamos deixar esses debates para os melhores pensadores de sofá da internet.
O fato é: ao fotografar amigos contra um céu brilhante sem HDR com qualquer câmera móvel, você obtém ou um céu normal com rostos pretos dos amigos, ou amigos bem desenhados, mas com um céu estourado.
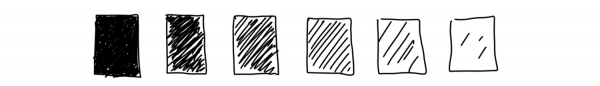
A solução já foi inventada — expandir o intervalo de brilho usando HDR (High dynamic range). É preciso tirar várias fotos com diferentes exposições e uní-las. Para que uma seja "normal", a segunda um pouco mais clara e a terceira um pouco mais escura. Pegamos as áreas escuras da imagem clara, preenchendo as superexposições com a imagem escura — lucro. Resta apenas resolver o problema da bracketing automático — o quanto deslocar a exposição de cada foto para não exagerar, mas um estudante do segundo ano de engenharia já consegue lidar com a determinação do brilho médio da imagem.
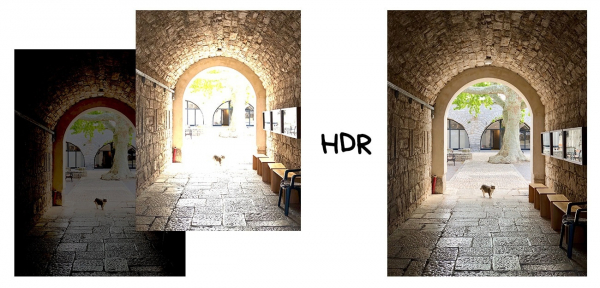
Nos últimos iPhones, Pixel e Galaxy, o modo HDR é ativado automaticamente quando um simples algoritmo dentro da câmera determina que você está fotografando algo com alto contraste em um dia ensolarado. Você pode até perceber como o telefone alterna o modo de gravação em buffer para salvar quadros expostos de forma deslocada - a câmera diminui os fps e a imagem se torna mais vibrante. O momento da mudança é bem visível no meu iPhone X, especialmente ao fotografar ao ar livre. Fique atento ao seu smartphone na próxima vez também.
A desvantagem do HDR com bracketing de exposição é sua incapacidade total em iluminação fraca. Mesmo sob a luz de uma lâmpada, os quadros ficam tão escuros que o computador não consegue alinhá-los e mesclá-los. Para resolver o problema da iluminação em 2013, o Google apresentou uma abordagem diferente ao HDR no smartphone Nexus que foi lançado naquela época. Ele utilizou o empilhamento temporal.
Empilhamento temporal - simulação de uma longa exposição e time-lapse.
O empilhamento temporal permite obter uma longa exposição utilizando uma série de exposições curtas. Os pioneiros eram os entusiastas de fotografar rastros de estrelas no céu noturno, que achavam difícil deixar o obturador aberto por duas horas. Era complicado calcular todas as configurações com antecedência, e até a menor movimentação estragava toda a foto. Eles decidiram abrir o obturador por apenas alguns minutos, mas várias vezes, e depois voltavam para casa e colavam as imagens obtidas no Photoshop.
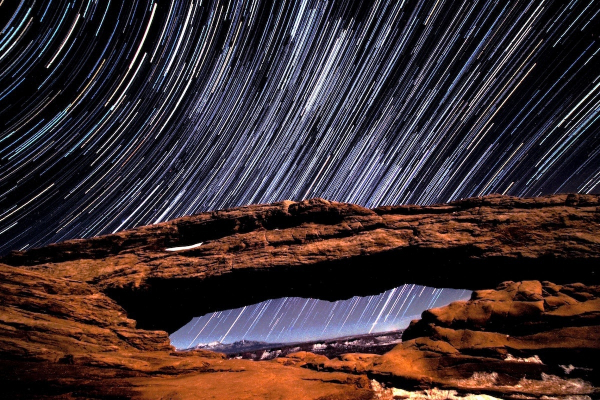
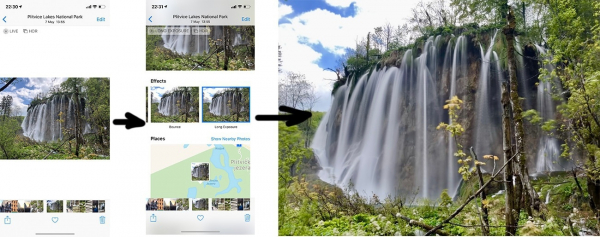
Assim, a câmera nunca realmente fez uma longa exposição, mas obtivemos o efeito da simulação, combinando várias fotos tiradas em sequência. Para smartphones, há muito tempo existem vários aplicativos que utilizam esse truque, mas todos eles se tornaram desnecessários desde que esse recurso foi adicionado à maioria das câmeras padrão. Hoje, até mesmo o iPhone pode facilmente compor uma longa exposição a partir de uma Live Photo.
Voltando ao Google com seu HDR noturno. Descobriu-se que, com o bracketing temporal, é possível realizar um bom HDR na escuridão. A tecnologia apareceu pela primeira vez no Nexus 5 e foi chamada de HDR+. Outros telefones Android a receberam quase como um presente. A tecnologia ainda é tão popular que é elogiada até mesmo nas apresentações dos últimos Pixels.
O HDR+ funciona de maneira bastante simples: ao detectar que você está fotografando em ambientes com pouca luz, a câmera carrega para a memória os últimos 8 a 15 cliques em RAW, sobrepondo-os. Assim, o algoritmo coleta mais informações sobre as áreas escuras da imagem para minimizar o ruído — pixels onde, por algum motivo, a câmera não conseguiu capturar todas as informações e falhou.
É como se você não soubesse como é uma capivara e pedisse para cinco pessoas descrevê-la — os relatos seriam aproximadamente iguais, mas cada um mencionaria algum detalhe único. Assim, você coletaria mais informações do que somente perguntando para uma pessoa. O mesmo se aplica aos pixels.
A soma de fotos tiradas de um mesmo ponto cria o mesmo efeito falso de longa exposição, como com as estrelas acima. A exposição de dezenas de fotos se soma, e os erros em uma são minimizados em outras. Imagine quantas vezes você teria que clicar no obturador de uma câmera reflex para alcançar esse efeito.
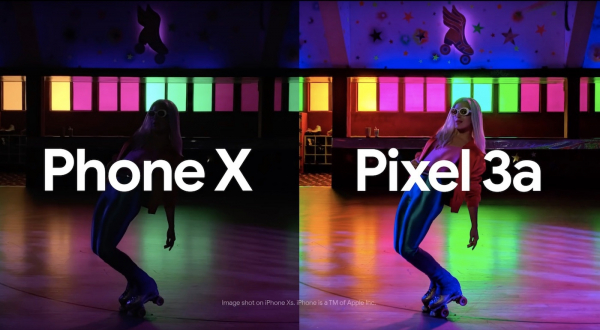
Restava apenas resolver o problema da correção automática de cores — as fotos tiradas em ambientes escuros geralmente saem com um tom amarelado ou esverdeado, enquanto queremos a vivacidade da luz do dia. Nas versões iniciais do HDR+, isso era resolvido com simples ajustes nas configurações, como em filtros estilo Instagram. Depois, as redes neurais foram convocadas para ajudar.
Assim surgiu o Night Sight — a tecnologia de "fotografia noturna" nos Pixel 2 e 3. A descrição diz claramente: "Técnicas de aprendizado de máquina construídas sobre o HDR+, que fazem o Night Sight funcionar". Na essência, isso automatiza a etapa de correção de cores. A máquina foi treinada em um conjunto de dados de fotos "antes" e "depois", para transformar conjuntos de fotos escuras em uma única imagem bonita.
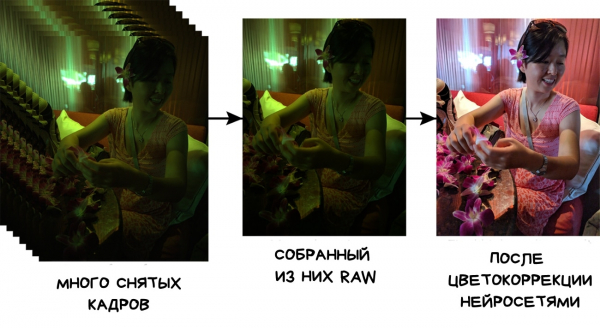
O conjunto de dados, a propósito, foi disponibilizado ao público. Quem sabe, os caras da Apple o utilizem e finalmente ensinem seus aparelhos de vidro a fotografar decentemente no escuro.
Além disso, no Night Sight é utilizado o cálculo do vetor de movimento dos objetos na imagem, para normalizar as desfocações que certamente ocorrem em longas exposições. Assim, o smartphone pode pegar partes nítidas de outras fotos e colar.
Empilhamento por movimento — panorama, superzoom e combate ao ruído.
A panorâmica é uma diversão popular entre os moradores das áreas rurais. Até agora, não há relatos de que uma foto de salsicha tenha interessado alguém além de seu autor, mas não dá para deixar de mencioná-la — para muitos, foi o início do stacking.
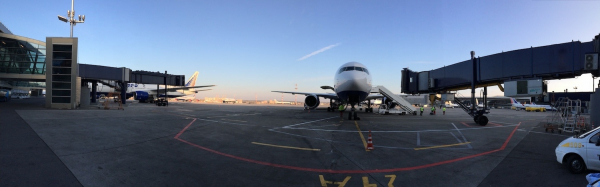
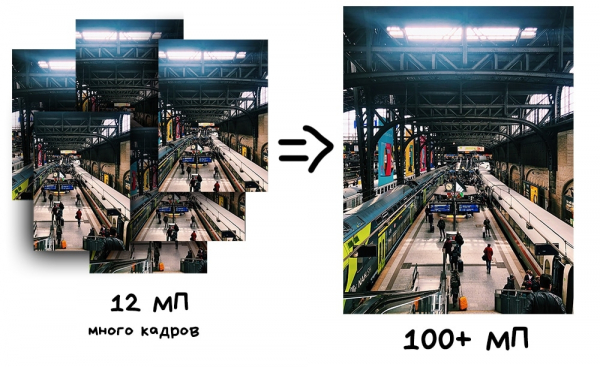
A primeira aplicação útil da panorâmica é obter uma fotografia de maior resolução do que a permitida pelo sensor da câmera, através da colagem de várias imagens. Fotógrafos já utilizam diferentes softwares para o que se chama de fotos com super-resolução — quando imagens ligeiramente deslocadas se completam entre os pixels. Assim, é possível obter imagens de até centenas de gigapixels, o que é bastante útil se você precisar imprimir em um cartaz publicitário do tamanho de uma casa.
Outra abordagem, já mais interessante, é o Pixel Shifting. Algumas câmeras sem espelho, como Sony e Olympus, começaram a suportá-lo desde 2014, mas até então o resultado ainda precisava ser colado manualmente. Inovações típicas das câmeras grandes.
Os smartphones, por outro lado, se destacaram aqui por uma razão engraçada — quando você tira uma foto, suas mãos tremem. Este problema, à primeira vista, serviu como base para a implementação da super-resolução nativa nos smartphones.
Para entender como isso funciona, é preciso lembrar como funciona o sensor de qualquer câmera fotográfica. Cada pixel (fotodiodo) só consegue capturar a intensidade da luz — ou seja, a quantidade de fótons que entram. No entanto, o pixel não consegue medir sua cor (comprimento de onda). Para obter uma imagem RGB, foi necessário criar uma solução alternativa — cobrir todo o sensor com uma grade de pequenos pedaços de vidro coloridos. A implementação mais popular é chamada de filtro Bayer e é usada hoje na maioria dos sensores. Parece como na imagem abaixo.
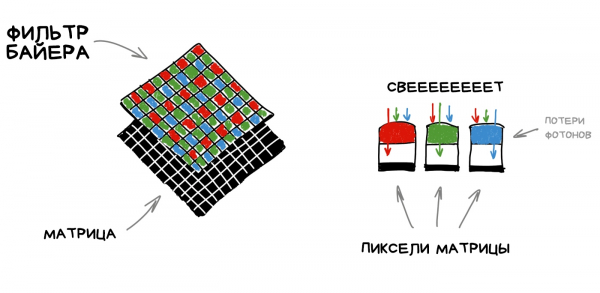
Assim, cada pixel do sensor captura apenas o componente R, G ou B, já que os outros fótons são implacavelmente refletidos pelo filtro Bayer. Os componentes faltantes são estimados por uma média simples dos valores dos pixels vizinhos.
Há mais células verdes no filtro Bayer — isso foi feito por analogia com o olho humano. Ou seja, dos 50 milhões de pixels no sensor, a cor verde será captada por 25 milhões, enquanto vermelho e azul receberão 12,5 milhões cada. O restante será suavizado — esse processo é chamado de debayerização ou demosaicing, e é uma solução improvisada bastante engraçada que sustenta todo o sistema.
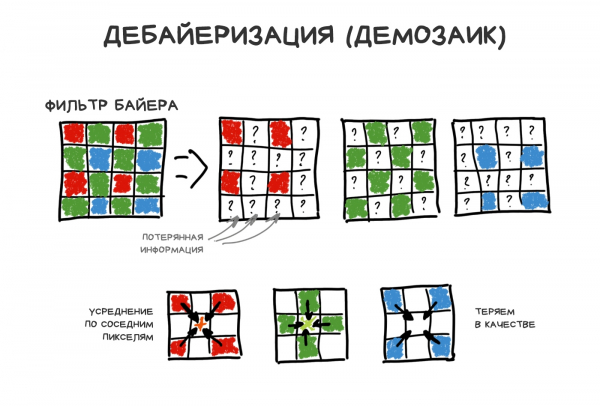
Na verdade, cada sensor possui seu próprio algoritmo de demosaicing patenteado, mas para os fins da nossa narrativa, vamos ignorar isso.
Outros tipos de sensores (como o Foveon) ainda não se popularizaram de forma significativa. Contudo, alguns fabricantes tentam usar sensores sem o filtro Bayer para melhorar a nitidez e a faixa dinâmica.
Quando a luz é escassa ou os detalhes do objeto são muito pequenos, perdemos muita informação, pois o filtro Bayer descaradamente corta fótons de comprimentos de onda indesejados. Por isso foi criado o Pixel Shifting — deslocar o sensor um pixel para cima, baixo, direita e esquerda, para capturá-los todos. A fotografia resultante não quadruplica como pode parecer; apenas o processador usa esses dados para registrar de forma mais precisa o valor de cada pixel. Ele calcula não a partir de vizinhos, mas de quatro de seus próprios valores.
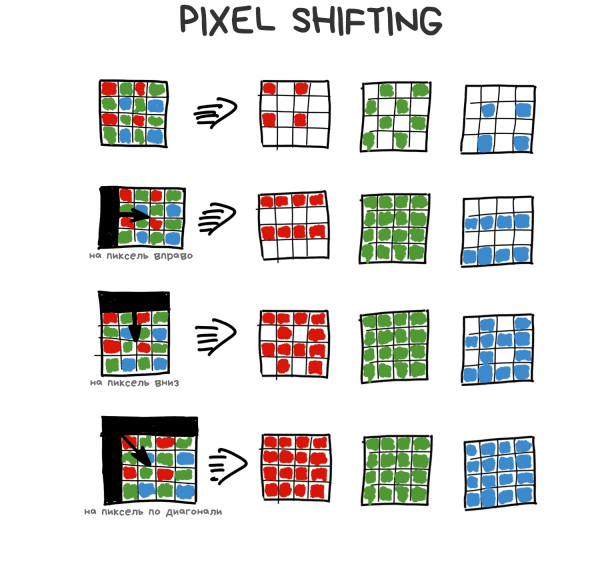
O tremor das nossas mãos ao tirar fotos com o telefone torna esse processo uma consequência natural. Nas versões mais recentes do Google Pixel, isso é implementado e sempre ativado quando você usa o zoom no telefone — é chamado de Super Res Zoom (sim, também gosto do nome implacável deles). Os chineses também copiaram isso para seus smartphones, embora o resultado tenha sido um pouco inferior.
Sobrepor fotos ligeiramente deslocadas permite coletar mais informações sobre a cor de cada pixel, o que significa reduzir o ruído, aumentar a nitidez e elevar a resolução sem aumentar o número físico de megapixels do sensor. Os flagships Android modernos fazem isso automaticamente, enquanto seus usuários nem sequer pensam sobre isso.
Focus stacking — qualquer profundidade de campo e refoco na pós-produção.
O método veio da macrofotografia, onde uma pequena profundidade de campo sempre foi um problema. Para ter todo o objeto em foco, era necessário tirar várias fotos com o foco deslocado para frente e para trás, para depois costurá-las em uma única imagem nítida. O mesmo método foi frequentemente usado por amantes da fotografia de paisagens, tornando o primeiro e o segundo planos tão nítidos quanto a diarréia.
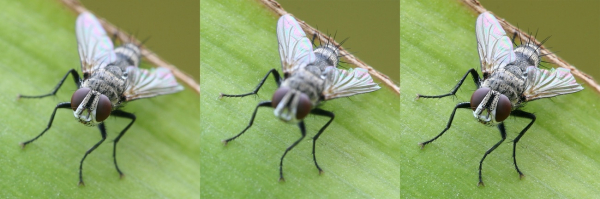
Tudo isso também chegou aos smartphones, embora sem muito burburinho. Em 2013, foi lançado o Nokia Lumia 1020 com o 'Refocus App', e em 2014 o Samsung Galaxy S5 com o modo 'Selective Focus'. Eles funcionavam de forma similar: ao pressionar o botão, tiravam rapidamente 3 fotos — uma com o foco 'normal', uma com o foco deslocado para frente e outra com o deslocado para trás. O programa alinhava as imagens e permitia escolher uma delas, o que era apresentado como um controle 'real' de foco na pós-produção.
Não houve mais processamento, pois mesmo esse truque simples foi suficiente para pregar mais um prego no caixão da Lytro e de seus equivalentes com seu 'verídico' refoco. A propósito, vamos falar sobre eles (mestre das transições nível 80).
Matrizes computacionais — campos de luz e plenóptica
Como entendemos acima, nossas matrizes são um horror em palafitas. Nós apenas acostumamos e tentamos viver com isso. Sua estrutura pouco mudou desde o início dos tempos. Nós apenas aprimoramos o processo — reduzimos a distância entre os pixels, lutamos contra ruídos e interferências e adicionamos pixels especiais para o funcionamento do autofoco por fase. Mas basta pegar até mesmo a câmera reflex mais cara e tentar fotografar um gato correndo em iluminação de sala — o gato, de maneira suave, vencerá.
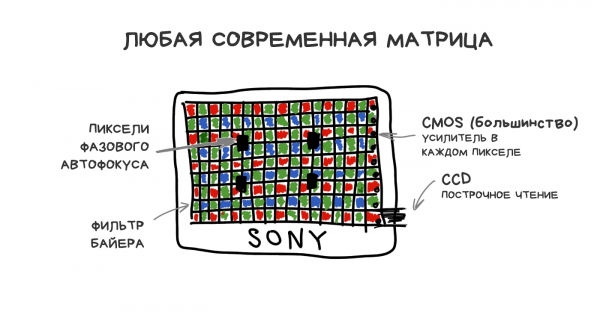
Já tentamos há muito inventar algo melhor. Muitas tentativas e pesquisas nessa área podem ser encontradas buscando por 'sensor computacional' ou 'sensor não Bayer', e até o exemplo do Pixel Shifting acima pode ser considerado uma tentativa de melhorar matrizes por meio de cálculos. No entanto, as histórias mais promissoras nos últimos vinte anos vêm do mundo das chamadas câmeras plenópticas.
Para que você não adormeça com a expectativa de palavras difíceis que se aproximam, deixo a dica de que a câmera dos últimos Google Pixel é, na verdade, 'um pouco' plenóptica. Apenas com dois pixels a mais, mas isso já permite que ela calcule a verdadeira profundidade óptica da imagem sem a necessidade de uma segunda câmera como a de todos os outros.
A plenoptic camera é uma poderosa ferramenta que ainda não foi totalmente explorada. Permita-me compartilhar uma das minhas recentes , de onde tirei os exemplos.
Uma câmera plenóptica — em breve estará em todos os lugares.
Inventada em 1994, montada em Stanford em 2004. A primeira câmera de consumo — Lytro, lançada em 2012. A indústria de VR está atualmente experimentando ativamente com tecnologias semelhantes.
A diferença entre uma câmera comum e uma plenóptica está em uma única modificação — a matriz é coberta por uma grade de lentes, cada uma das quais cobre vários pixels reais. Assim:
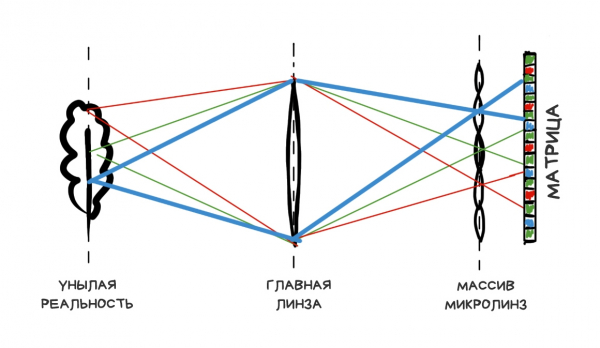
se calcular corretamente a distância da grade até a matriz e o tamanho da abertura, a imagem resultante terá nítidos clusters de pixels — mini-versões da imagem original.
Descobri que se pegarmos um pixel central de cada cluster e unirmos a imagem somente com eles — ela não será diferente de uma foto tirada por uma câmera comum. Sim, perdemos um pouco em resolução, mas podemos simplesmente pedir à Sony para adicionar mais megapixels nas novas matrizes.
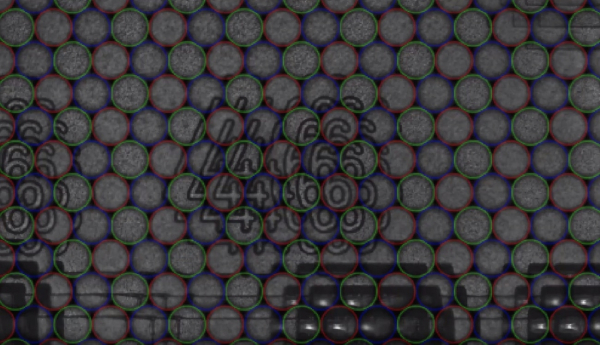
A diversão apenas começa. Se pegarmos outro pixel de cada cluster e novamente unirmos a imagem — obteremos uma foto normal, mas com um pequeno deslocamento de um pixel. Assim, usando clusters de 10 × 10 pixels, teremos 100 imagens do objeto de "pontos" um pouco diferentes.
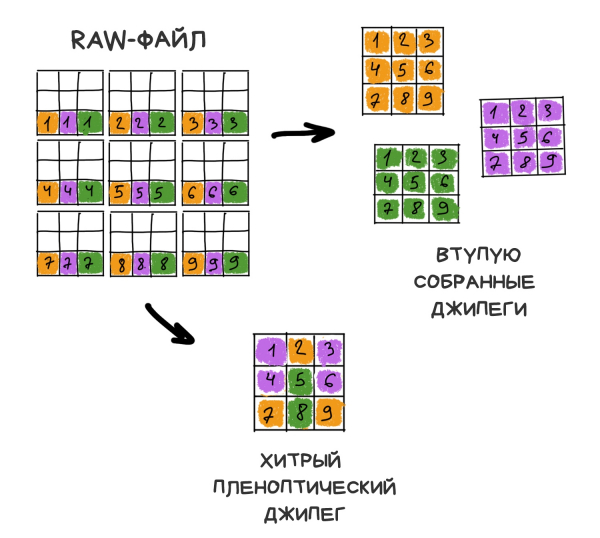
Cluster maior — mais imagens, mas menor resolução. No mundo dos smartphones com matrizes de 41 megapixels, podemos ignorar um pouco a resolução, mas há um limite. Precisamos manter o equilíbrio.
Ok, montamos a câmera plenóptica, e o que isso nos proporciona?
Foco verdadeiro
O recurso sobre o qual todos os jornalistas tagarelaram em artigos sobre a Lytro — a capacidade de ajustar o foco de maneira verdadeira na pós-produção. Por verdadeiro, queremos dizer que não usamos algoritmos de desfoque, mas apenas os pixels disponíveis, selecionando ou médias deles dos clusters na ordem certa.
Uma fotografia RAW de uma câmera plenóptica parece estranha. Para obter um JPEG nítido como de costume, é necessário montá-lo primeiro. Isso envolve selecionar cada pixel do JPEG de um dos clusters do RAW. Dependendo de como os escolhemos, o resultado mudará.
Por exemplo, quanto mais distante estiver o cluster do ponto de impacto do raio original, mais desfocado esse raio se torna. Isso é devido à óptica. Para obter uma imagem deslocada em foco, precisamos apenas escolher pixels a uma distância desejada do original – seja mais perto ou mais longe.
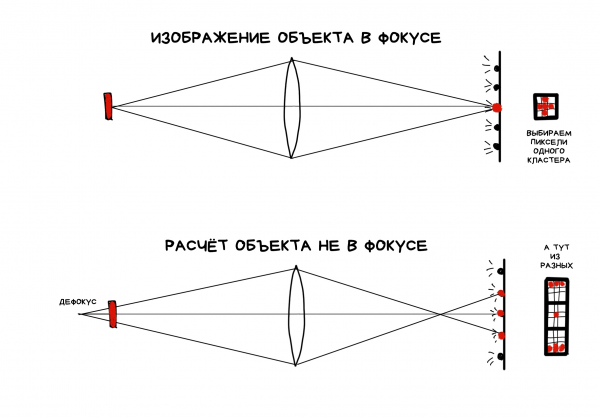
Ajustar o foco para mais perto foi mais complicado – fisicamente, havia menos desses pixels nos clusters. Inicialmente, os desenvolvedores não queriam permitir que os usuários focassem manualmente – a câmera decidia isso programaticamente. Os usuários não gostaram dessa perspectiva, então a função foi adicionada em firmwares posteriores com o nome de "modo criativo", mas o reajuste de foco foi fortemente limitado exatamente por essa razão.
Mapa de profundidade e 3D com uma única câmera
Uma das operações mais simples em plenóptica é obter um mapa de profundidade. Para isso, basta coletar duas diferentes imagens e calcular o quanto os objetos nelas estão deslocados. Quanto mais deslocados, mais longe da câmera.
Recentemente, o Google comprou e descontinuou a Lytro, mas utilizou suas tecnologias para seu VR e... para a câmera no Pixel. A partir do Pixel 2, a câmera se tornou "um pouco" plenóptica pela primeira vez, embora com clusters de apenas dois pixels. Isso permitiu ao Google não instalar uma segunda câmera, como os outros, e calcular o mapa de profundidade exclusivamente a partir de uma única foto.
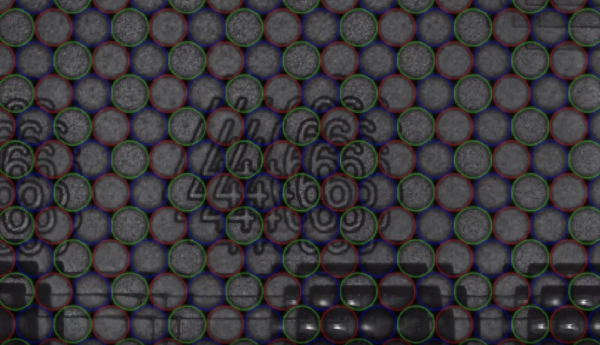
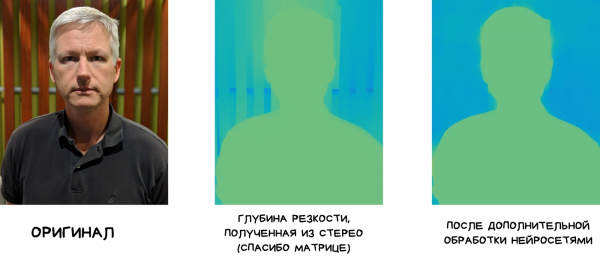
O mapa de profundidade é construído a partir de duas imagens, deslocadas em um subpixel. Isso é suficiente para calcular um mapa binário de profundidade e separar o primeiro plano do fundo, mantendo este último em um moderno desfoque. O resultado dessa separação é ainda suavizado e "melhorado" por redes neurais treinadas para aprimorar mapas de profundidade (e não para desfoque, como muitos pensam).
Outra vantagem é que a plenóptica em smartphones nos foi oferecida quase de graça. Já estávamos colocando lentes nesses minúsculos sensores para aumentar o fluxo de luz. Nos próximos Pixels, o Google planeja ir além e cobrir quatro fotodiodos com uma lente.
Fonte: 3dnews.ru
