

Foi publicado um guia detalhado sobre a otimização do ambiente Linux para alcançar o máximo desempenho no processamento de requisições HTTP. Os métodos propostos elevaram a performance do manipulador JSON baseado na biblioteca libreactor em um ambiente Amazon EC2 (4 vCPU) de 224 mil requisições API por segundo nas configurações padrão do Amazon Linux 2 com kernel 4.14 para 1,2 milhão de requisições por segundo após as otimizações realizadas (um aumento de 436%), além de reduzir a latência no processamento de requisições em 79%. Os métodos propostos não são específicos para libreactor e funcionam com outros servidores http, incluindo nginx, Actix, Netty e Node.js (libreactor foi utilizado nos testes porque a solução baseada nele mostrou melhor desempenho).
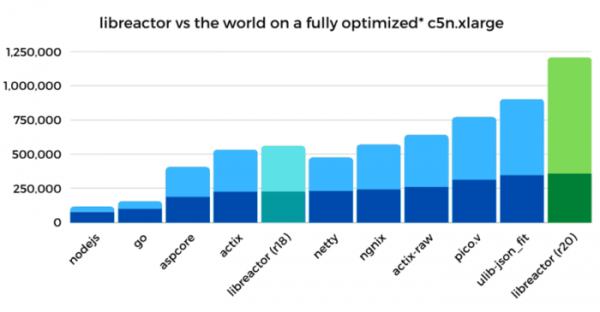
Principais otimizações:
- Otimização do código do libreactor. Foi usada como base a versão R18 do conjunto Techempower, que foi melhorada por meio da remoção do código que limita o número de núcleos de CPU utilizados (a otimização permitiu um aumento na performance de 25-27%), compilação no GCC com as opções "-O3" (aumento de 5-10%) e "-march-native" (5-10%), substituição das chamadas read/write por recv/send (5-10%) e redução da sobrecarga ao usar pthreads (2-3%). O ganho total de desempenho após a otimização do código foi de 55%, e a taxa de transferência aumentou de 224k req/s para 347k req/s.
- Desativação da proteção contra vulnerabilidades causadas pela execução especulativa de instruções. O uso de parâmetros na inicialização do kernel "nospectre_v1 nospectre_v2 pti=off mds=off tsx_async_abort=off" permitiu um aumento de desempenho de 28%, e a taxa de transferência aumentou de 347k req/s para 446k req/s. O ganho isolado do parâmetro "nospectre_v1" (proteção contra Spectre v1 + SWAPGS) foi de 1-2%, "nospectre_v2" (proteção contra Spectre v2) — 15-20%, "pti=off" (Spectre v3/Meltdown) — 6%, "mds=off tsx_async_abort=off" (MDS/Zombieload e TSX Asynchronous Abort) — 6%. As configurações para proteção contra ataques L1TF/Foreshadow (l1tf=flush), iTLB multihit, Speculative Store Bypass e SRBDS foram mantidas inalteradas, pois não impactaram o desempenho, uma vez que não se cruzaram com a configuração testada (por exemplo, específicas para KVM, virtualização aninhada e outros modelos de CPU).
- Desativação dos mecanismos de auditoria e bloqueio de chamadas de sistema com o comando "auditctl -a never,task" e a especificação da opção "—security-opt seccomp=unconfined" ao iniciar o contêiner docker. O ganho total de desempenho foi de 11%, e a taxa de transferência aumentou de 446k req/s para 495k req/s.
- Desativação do iptables/netfilter por meio da descarregamento dos módulos do kernel relacionados. A ideia de desativar o firewall, que não era utilizado na solução de servidor específica, foi impulsionada pelos resultados de perfilamento, que mostraram que a execução da função nf_hook_slow consumia 18% do tempo. Observa-se que o nftables funciona de maneira mais eficiente do que o iptables, mas o iptables ainda é utilizado no Amazon Linux. Após a desativação do iptables, o ganho de desempenho foi de 22%, e a capacidade de processamento aumentou de 495k req/s para 603k req/s.
- Redução da migração de manipuladores entre diferentes núcleos de CPU para aumentar a eficiência do uso do cache do processador. A otimização foi feita tanto no nível de vinculação de processos do libreactor aos núcleos de CPU (CPU Pinning), quanto através da fixação de manipuladores de rede do kernel (Receive Side Scaling). Por exemplo, foi desativado o irqbalance e feita a configuração explícita dos vínculos de filas ao CPU em /proc/irq/$IRQ/smp_affinity_list. Para usar o mesmo núcleo de CPU para processar o processo libreactor e a fila de pacotes de entrada, foi utilizado um manipulador BPF próprio, conectado através da configuração do flag SO_ATTACH_REUSEPORT_CBPF ao criar o socket. Para vincular as filas de pacotes de saída ao CPU, foram alteradas as configurações em /sys/class/net/eth0/queues/tx-<n>/xps_cpus. O ganho total de desempenho foi de 38%, e a capacidade de processamento aumentou de 603k req/s para 834k req/s.
- Otimização do tratamento de interrupções e uso de polling. A ativação do modo adaptive-rx no driver ENA e manipulações com o sysctl net.core.busy_read permitiram aumentar o desempenho em 28% (a capacidade de processamento aumentou de 834k req/s para 1.06M req/s, e as latências diminuíram de 361μs para 292μs).
- Desativação de serviços do sistema que causavam bloqueios desnecessários na pilha de rede. A desativação do dhclient e a configuração endereços IP manualmente resultaram em um aumento de desempenho de 6%, e a capacidade de processamento aumentou de 1.06M req/s para 1.12M req/s. A razão do impacto do dhclient no desempenho foi analisada no tráfego usando um socket raw.
- Combate ao Spin Lock. A mudança da pilha de rede para o modo "noqueue" através do sysctl "net.core.default_qdisc=noqueue" e "tc qdisc replace dev eth0 root mq" resultou em um aumento de desempenho de 2%, e a capacidade de processamento aumentou de 1.12M req/s para 1.15M req/s.
- Otimizações finais, como desativar o GRO (Generic Receive Offload) com o comando «ethtool -K eth0 gro off» e substituir o algoritmo de controle de congestionamento de cubic para reno usando sysctl «net.ipv4.tcp_congestion_control=reno». O aumento total de desempenho foi de 4%. A capacidade de resposta aumentou de 1.15M req/s para 1.2M req/s.
Além das otimizações que funcionaram, o artigo também examina métodos que não levaram ao aumento de desempenho esperado. Por exemplo, os seguintes métodos foram ineficazes:
- A execução separada do libreactor não apresentou diferença de desempenho em comparação à execução em um contêiner. A troca de writev por send, o aumento de maxevents em epoll_wait, e os experimentos com versões e flags do GCC (o efeito foi notável apenas para as flags «-O3» e «-march-native») não tiveram impacto.
- A atualização do kernel Linux para as versões 4.19 e 5.4, o uso dos escalonadores SCHED_FIFO e SCHED_RR, e manipulações de sysctl como kernel.sched_min_granularity_ns, kernel.sched_wakeup_granularity_ns, transparent_hugepages=never, skew_tick=1 e clocksource=tsc não afetaram o desempenho.
- No driver ENA, a ativação dos modos Offload (segmentação, scatter-gather, checksum rx/tx), a montagem com a flag «-O3» e a aplicação dos parâmetros ena.rx_queue_size e ena.force_large_llq_header não influenciaram.
- As alterações no stack de rede não resultaram em aumento de desempenho:
- Desativação do IPv6: ipv6.disable=1
- Desativação do VLAN: modprobe -rv 8021q
- Desativação da verificação da fonte do pacote
- net.ipv4.conf.all.rp_filter=0
- net.ipv4.conf.eth0.rp_filter=0
- net.ipv4.conf.all.accept_local=1 (efeito negativo)
- net.ipv4.tcp_sack=0
- net.ipv4.tcp_dsack=0
- net.ipv4.tcp_mem/tcp_wmem/tcp_rmem
- net.core.netdev_budget
- net.core.dev_weight
- net.core.netdev_max_backlog
- net.ipv4.tcp_slow_start_after_idle=0
- net.ipv4.tcp_moderate_rcvbuf=0
- net.ipv4.tcp_timestamps=0
- net.ipv4.tcp_low_latency=1
- SO_PRIORITY
- TCP_NODELAY
Fonte: opennet.ru
