

O projeto OpenAI, que se dedica ao desenvolvimento de projetos de acesso público na área de inteligência artificial, publicou resultados relacionados ao sistema de reconhecimento de fala Whisper. Afirmam que para a fala em inglês, o sistema oferece níveis de confiabilidade e precisão de reconhecimento automático próximos aos do reconhecimento realizado por humanos. O código da implementação de referência, baseado no framework PyTorch, e um conjunto de modelos já treinados, prontos para uso, estão abertos. O código é disponibilizado sob a licença MIT.
Para treinar o modelo, foram utilizados 680 mil horas de dados de fala, coletados de várias coleções que abrangem diferentes idiomas e áreas temáticas. Cerca de 1/3 dos dados de fala utilizados no treinamento são de idiomas diferentes do inglês. O sistema proposto lida corretamente com situações como pronúncia com sotaque, presença de ruídos de fundo e uso de jargão técnico. Além de transcrever fala em texto, o sistema também pode traduzir fala de qualquer língua para o inglês e detectar a presença de fala em um fluxo de áudio.
Os modelos foram formados em duas variantes: um modelo para o idioma inglês e um modelo multilíngue que suporta, entre outros, os idiomas russo, ucraniano e bielorrusso. Cada variante é dividida em 5 opções, que diferem em tamanho e no número de parâmetros cobertos pelo modelo. Quanto maior o tamanho, maior a precisão e qualidade do reconhecimento, mas também maiores são os requisitos de tamanho da memória de vídeo da GPU e menor é a performance. Por exemplo, a opção mínima inclui 39 milhões de parâmetros e requer 1 GB de memória de vídeo, enquanto a máxima inclui 1550 milhões de parâmetros e requer 10 GB de memória de vídeo. A opção mínima é 32 vezes mais rápida que a máxima.
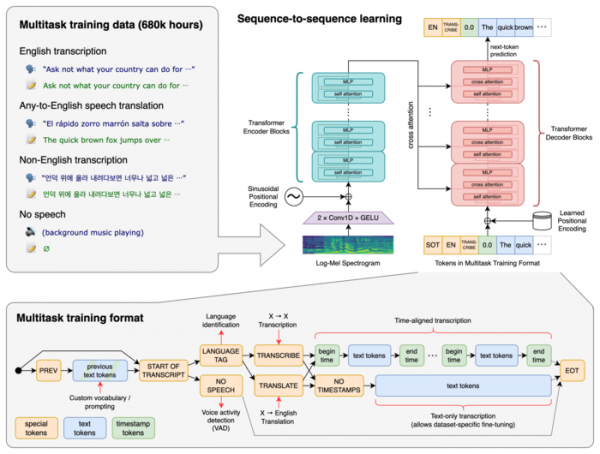
O sistema utiliza a arquitetura de rede neural "Transformer", que inclui um codificador e um decodificador interagindo entre si. O som é dividido em trechos de 30 segundos, que são convertidos em um espectrograma log-Mel e enviados para o codificador. O resultado do codificador é passado para o decodificador, que prevê a representação textual, misturada com tokens especiais, permitindo resolver tarefas como identificação de idioma, consideração da cronologia da pronúncia de frases, transcrição de fala em diferentes idiomas e tradução para o inglês em um único modelo.
Fonte: opennet.ru
