

A empresa Stability AI lançou a segunda edição do sistema de aprendizado de máquina Stable Diffusion, capaz de sintetizar e modificar imagens com base em um modelo proposto ou descrição em linguagem natural. O código das ferramentas para treinar a rede neural e gerar imagens foi escrito na linguagem Python usando o framework PyTorch e publicado sob a licença MIT. Os modelos já treinados estão disponíveis sob a licença permissiva Creative ML OpenRAIL-M, permitindo uso comercial. Além disso, um gerador de imagens online de demonstração está disponível.
Melhorias principais na nova edição do Stable Diffusion:
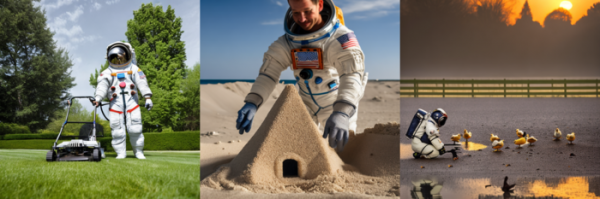
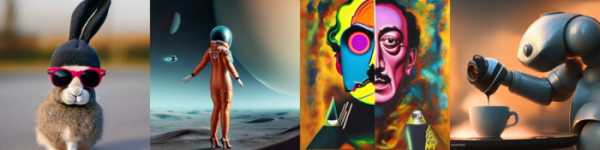
- Uma nova modelo de síntese de imagens a partir de descrições de texto foi criada — SD2.0-v, que suporta a geração de imagens com resolução de 768×768. O novo modelo foi treinado usando a coleção LAION-5B, que inclui 5,85 bilhões de imagens com descrições de texto. O modelo utiliza o mesmo conjunto de parâmetros que o modelo Stable Diffusion 1.5, mas difere na transição para um codificador fundamentalmente diferente OpenCLIP-ViT/H, que permitiu melhorar significativamente a qualidade das imagens resultantes.

- Uma versão simplificada SD2.0-base foi preparada, treinada em imagens de 256×256 usando um modelo clássico de predição de ruído e que suporta a geração de imagens com resolução de 512×512.

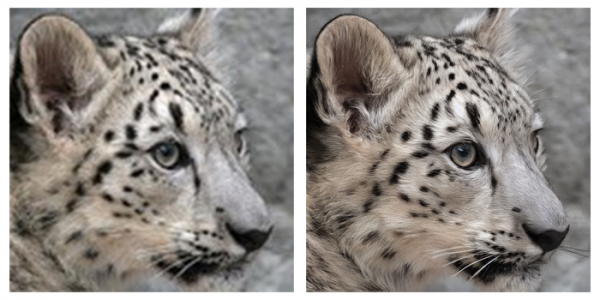
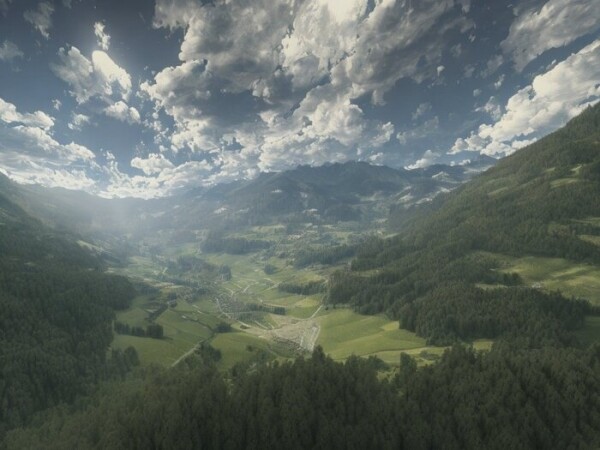
- Foi oferecida a possibilidade de usar a tecnologia de superamostragem (Super Resolution) para aumentar a resolução da imagem original sem perda de qualidade, utilizando algoritmos de escalonamento espacial e reconstrução de detalhes. O modelo de processamento de imagens fornecido (SD20-upscaler) suporta um aumento de quatro vezes na escala, permitindo formar imagens com resolução de 2048×2048.

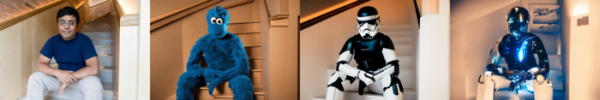
- Foi proposta a modelo SD2.0-depth2img, que considera a profundidade e a disposição espacial dos objetos. Para a avaliação monocular da profundidade, é utilizada o sistema MiDaS. O modelo permite sintetizar novas imagens usando outra imagem como modelo, que podem diferir radicalmente do original, mas manter a composição geral e a profundidade. Por exemplo, é possível usar a pose de uma pessoa em uma fotografia para formar outro personagem na mesma pose.


- Modelo atualizado para modificação de imagens — SD 2.0-inpainting, que permite substituir e alterar partes da imagem usando sugestões textuais.
- Otimização dos modelos realizada para uso em sistemas comuns com uma GPU.
Fonte: opennet.ru
