

No âmbito do projeto de pesquisa começou o trabalho para adicionar ao GCC uma funcionalidade que permite dividir o processo de compilação em vários threads executados em paralelo. Atualmente, para aumentar a velocidade de compilação em sistemas multinúcleo, a nível da utilidade make, são lançados processos separados do compilador, cada um deles responsável pela compilação de um arquivo de código separado. O novo projeto experimenta a paralelização a nível do compilador, o que potencialmente permitirá aumentar a eficiência em sistemas multinúcleo.
Para testes uma ramificação separada de paralelização do GCC, na qual foi proposto um novo parâmetro "—param=num-threads=N" para definir o número de threads. Na fase inicial, foram implementadas otimizações interprocedurais em threads separadas, que são chamadas ciclicamente para cada função e se prestam bem à paralelização. Operações GIMPLE foram extraídas para threads separadas, responsáveis por otimizações independentes de hardware que avaliam a interação entre funções.
Na próxima etapa, também está previsto extrair para threads separadas as otimizações RTL interprocedurais, que consideram as características da plataforma de hardware. Após isso, planeja-se implementar a paralelização das otimizações intraprocedurais (IPA), aplicáveis ao código dentro da função, independentemente das particularidades da chamada. O elo limitante até agora é o coletor de lixo, que foi adicionado com um bloqueio global, desativando as operações de coleta de lixo durante a execução em modo multithread (no futuro, o coletor de lixo será adaptado para a execução multithread do GCC).
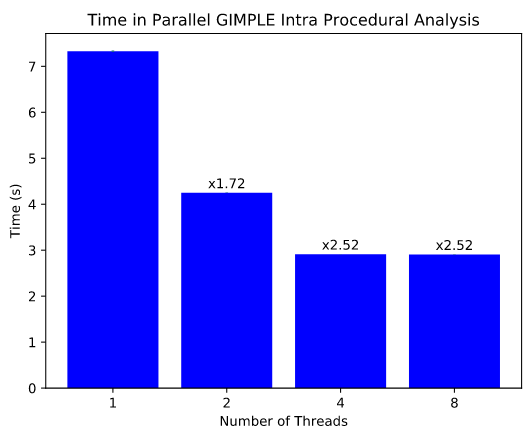
Para avaliar a mudança de desempenho, um conjunto de testes foi preparado, realizando a compilação do arquivo gimple-match.c, que inclui mais de 100 mil linhas de código e 1700 funções. Os testes em um sistema com CPU Intel Core i5-8250U com 4 núcleos físicos e 8 virtuais (Hyperthreading) mostraram uma redução no tempo de execução das otimizações Intra Procedural GIMPLE de 7 para 4 segundos ao executar 2 threads e para 3 segundos ao executar 4 threads, ou seja, um aumento na velocidade da fase de compilação considerada de 1.72 e 2.52 vezes, respectivamente. Os testes também mostraram que o uso de núcleos virtuais durante o Hyperthreading não resulta em aumento de desempenho.
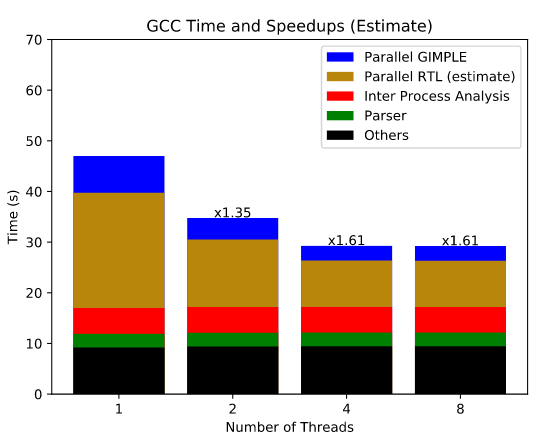
O tempo total de compilação diminuiu aproximadamente em 10%, mas as previsões indicam que a paralelização das otimizações RTL permitirá resultados mais significativos, já que essa fase leva consideravelmente mais tempo durante a compilação. Estima-se que, após a paralelização do RTL, o tempo total de compilação será reduzido em 1,61 vezes. Além disso, será possível reduzir o tempo de compilação em mais 5-10% por meio da paralelização das otimizações IPA.
Fonte: opennet.ru
