

No âmbito do projeto Qwenputer, pesquisadores desenvolveram uma versão ampliada do modelo de IA Qwen3.5-4B, que inclui um simulador integrado de um CPU de 32 bits baseado na arquitetura RISC-V (RV32IM), suportando a extensão Zba e equipado com um coprocessador bignum para operações aritméticas com números grandes. A implementação do núcleo do CPU foi compilada em um conjunto de pesos e integrada a um grande modelo de linguagem na forma de 11 camadas adicionais de transformadores, adicionadas antes das camadas principais do Qwen. Os cálculos são realizados diretamente durante o processo de passagem direta (forward pass) da rede neural, sem a necessidade de ferramentas ou plugins externos.
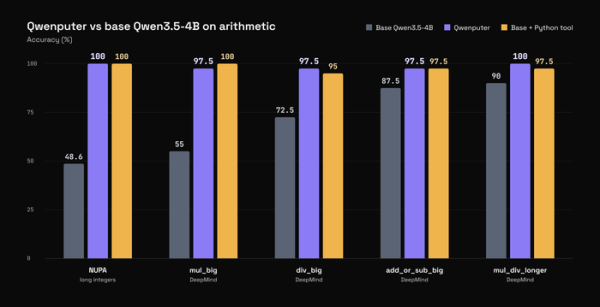
A implementação passa com sucesso por todos os testes do conjunto oficial de testes riscv-tests e é capaz de executar código compilado em C e MicroPython. Ao realizar cálculos aritméticos com números grandes, o Qwenputer garante uma precisão de 97,5-100%, o que é comparável ou superior aos resultados do modelo base Qwen3.5 com um interpretador Python externo conectado.
Para simular a memória RAM, o modelo utiliza camadas separadas de Gated DeltaNet (RNNs lineares), empregadas no modelo AI padrão Qwen para preservar o estado alterado ao trabalhar com janelas de contexto grandes. Ao fixar o estado do gate e aplicar codificação unitária (one-hot), cada solicitação de gravação sobrescreve exatamente uma linha da matriz de estado, permitindo que o estado do DeltaNet funcione como uma memória endereçável de tamanho fixo, evitando o crescimento linear do cache KV (Key-Value) à medida que o comprimento do contexto aumenta. Nesta memória, são armazenados os registradores do CPU, os dados e o código de máquina em execução.
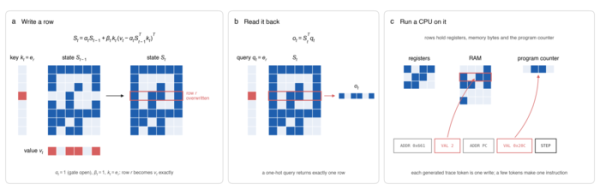
As instruções do processador, como leitura de registradores, operações aritméticas e saltos condicionais, são compiladas diretamente em pesos das camadas do transformador. Cada instrução é associada a tokens especiais (ADDR, VAL, STEP), que as camadas do modelo de IA interpretam como a lógica de operação do CPU. Para inicializar o CPU e carregar o firmware, é utilizado um pequeno driver externo RvChat, mas o código de máquina é processado completamente dentro dos pesos do modelo.
As restrições do projeto mencionam um aumento de quase o dobro em relação ao modelo original Qwen, com um tamanho de 18,8 GB, ao manter os checkpoints, principalmente devido ao preenchimento adicional de camadas extras. Também é observada uma velocidade de computação relativamente baixa (cerca de 3200 tokens por segundo na GPU L4), o que pode fazer com que cálculos complexos demorem segundos, em vez de milissegundos.
Além disso, uma versão do modelo de IA foi implementada com um sistema de arquivos experimental, permitindo armazenar até 512 arquivos com 53 mil tokens de texto dentro dos pesos do modelo de IA. Assim como na implementação da memória operacional, o armazenamento é organizado em relação aos estados DeltaNet, mas difere por garantir armazenamento permanente, que não perde o estado entre as sessões.
Os desenvolvimentos do Qwenputer também serviram de base para investigar novos problemas potenciais de segurança em IA. O exemplo do Qwenputer mostra como um modelo de IA especialmente modificado pode ocultar seu raciocínio em estados RNN e contornar os mecanismos de monitoramento do raciocínio do modelo (CoT, Chain-of-Thought). Também foi demonstrado
a possibilidade de criar mecanismos de controle e monitoramento de segurança incorporados nos pesos do modelo de IA, que o próprio modelo não pode desativar ou modificar.
Fonte: opennet.ru
