

Os desenvolvedores do OrioleDB analisaram o estado atual da API de baixo nível utilizada para o acesso de extensões a tabelas e índices no PostgreSQL (API de Método de Acesso a Tabelas/Índices) e propuseram maneiras de melhorá-la. Desde a sua introdução no PostgreSQL 12, essa API permite aos desenvolvedores criar mecanismos alternativos de armazenamento de dados. No entanto, apesar de existir essa API e dos conhecidos limites do mecanismo de armazenamento embutido, até agora não surgiram motores de armazenamento transacionais totalmente funcionais implementados exclusivamente como extensões.
As funções mais requisitadas para motores de tabela alternativos no PostgreSQL são:
- Implementações alternativas de MVCC, como armazenamento baseado em log UNDO.
- Tabelas organizadas por índice, onde o índice não é um complemento opcional à tabela que acelera as consultas, mas representa a estrutura de dados principal onde os dados da tabela são armazenados.
As mudanças necessárias na API Table/Index AM para dar suporte a implementações alternativas de MVCC são discutidas com base na extensão OrioleDB, criada para abordar as deficiências conhecidas do mecanismo de armazenamento embutido do PostgreSQL. O problema é que, para uma integração completa do OrioleDB com o PostgreSQL, são necessárias alterações no código do PostgreSQL, o que complica a implementação do projeto e destaca a necessidade de modernização da API atual do Table AM.
A API Table AM não impõe diretamente a forma de implementação do MVCC. No entanto, a API Table AM e a API Index AM fazem a seguinte suposição: cada TID (Identificador de Tupla/Linha) é indexado por todos os índices ou não é indexado de forma alguma. Mesmo que a Index AM tenha várias referências a um único TID (por exemplo, GIN), todas essas referências devem corresponder ao mesmo valor indexado.
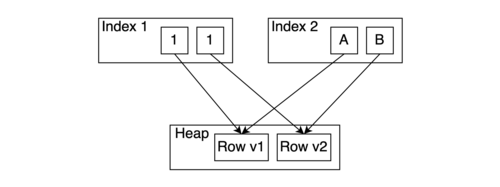
Esse princípio foi criticado por aumentar o número de operações de gravação ('amplificação de gravação') — se um atributo indexado é atualizado, é necessário atualizar cada índice na tabela. Para tirar pleno proveito do log UNDO ou construir outro método de armazenamento sem 'amplificação de gravação' (como o método WARM), é necessário violar essa suposição.
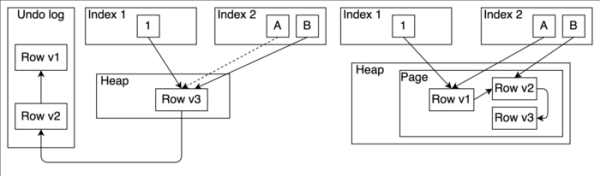
A tabela AM baseada em UNDO, que não violará essa suposição, é semelhante ao método HOT (Heap-Only Tuples), exceto que as versões antigas das linhas são mantidas no log UNDO e não precisam caber na mesma página. No entanto, segundo os autores, essa vantagem não é suficiente para justificar a existência de uma tabela AM separada.
Limitações práticas da API existente:
- Durante a atualização de uma linha da tabela, os índices são atualizados de forma 'tudo ou nada'.
- A API Index AM não possui a capacidade de excluir determinados tuplos de forma pontual. Atualmente, é possível excluir tuplos dos índices em massa através dos métodos ambulkdelete e amvacuumcleanup. Tentar implementar uma exclusão pontual através dessa API resultaria em baixa eficiência, uma vez que a maioria das implementações atuais precisaria escanear todo o índice. Além disso, a API não permite especificar quais dos tuplos que referenciam o mesmo TID devem ser excluídos. Ela pode excluir apenas todos eles.
- Os índices atualmente referenciam as linhas da tabela pelo número de bloco (32 bits) e o número de deslocamento (16 bits). E apenas 11 bits do número de deslocamento podem ser transmitidos com segurança do TID da tabela para todos os métodos de acesso do índice. Nesse caso, implementações alternativas de MVCC podem precisar armazenar uma carga útil adicional (payload) juntamente com o TID. Por exemplo, no OrioleDB, um ou mais bits são necessários para implementar índices de 'marcação de exclusão' ou informações completas sobre visibilidade.
Foram propostos dois métodos para superar as limitações na prática:
Abordagem 1: A API Index AM oferece possibilidades para a implementação alternativa de MVCC.
Enquanto a tabela AM continua a ser responsável por todos os componentes do MVCC, a Index AM fornece as capacidades necessárias para uma implementação alternativa de MVCC, a saber: armazenamento de carga útil personalizada (payload) juntamente com o TID, método de exclusão pontual e até mesmo método de atualização pontual (se o TID no índice não puder ser alterado, a carga útil personalizada pode). Além disso, como é necessário permitir que vários tuplos do índice referenciem o mesmo TID, os métodos da API utilizados ao escanear o índice também precisarão ser atualizados.
Abordagem 2: Índices que suportam MVCC.
Uma alternativa seria permitir índices que suportam MVCC. Ou seja, o 'executor' (ou, possivelmente, o Table AM) simplesmente chama os métodos insert() e delete() no Index AM, enquanto o Index AM fornece a possibilidade de varredura levando em conta o MVCC. Isso simplificaria significativamente a varredura usando apenas índices (index-only). Mesmo todo o Table AM nesse caso poderia se tornar uma camada intermediária, armazenando dados no índice.
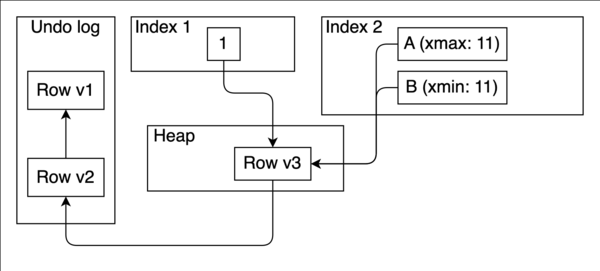
O diagrama abaixo apresenta um exemplo. O valor do índice 2 é atualizado pela transação 11 de 'A' para 'B'. Portanto, o valor 'A' é marcado como xmax == 11, e o valor 'B' é marcado como xmin == 11. Assim, pode-se escanear o índice 2 e obter apenas os tuplos visíveis de acordo com o MVCC sem verificações da pilha (heap). A coleta de lixo do índice 2 também pode ser realizada sem o uso da pilha.
Ao implementar todas as inovações listadas na API de métodos de acesso a índices, é improvável que seja possível atualizar todos os índices para suportar todas as novas capacidades simultaneamente. É mais realista permitir várias implementações para um método de acesso a índice. Por exemplo, além do B-tree padrão, a extensão poderá implementar um B-tree alternativo com suporte a MVCC dentro do índice e suporte a identificadores de registro de comprimento arbitrário.
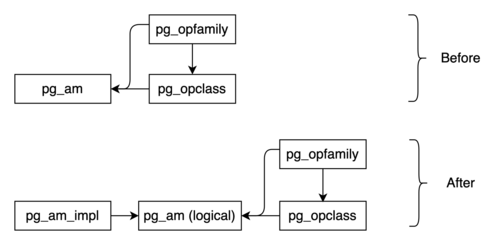
Assim, propõe-se revisar não apenas a API do Table AM, mas também a API do Index AM, que tem servido à comunidade PostgreSQL por muitos anos. Além disso, sugere-se dividir o Index AM em uma camada lógica e uma camada de implementação. Essa arquitetura reimaginada permitirá que o PostgreSQL suporte diferentes modelos de armazenamento.
Fonte: opennet.ru
