

SciPy (pronunciado como sai pai) é um pacote de procedimentos matemáticos aplicados baseado na extensão do Numpy Python. Com o SciPy, uma sessão interativa do Python se transforma em um ambiente completo de processamento de dados e prototipagem de sistemas complexos, como MATLAB, IDL, Octave, R-Lab e SciLab. Hoje, quero falar brevemente sobre como aplicar alguns algoritmos de otimização conhecidos no pacote scipy.optimize. Um guia mais detalhado e atualizado sobre a aplicação das funções pode sempre ser obtido usando o comando help() ou com Shift+Tab.
Introdução
Para evitar que eu e os leitores tenhamos que procurar e ler as fontes originais, as referências às descrições dos métodos serão principalmente para a Wikipedia. Geralmente, essas informações são suficientes para entender os métodos em termos gerais e as condições de sua aplicação. Para compreender a essência dos métodos matemáticos, iremos às referências de publicações mais confiáveis, que podem ser encontradas no final de cada artigo ou em seu mecanismo de busca favorito.
Assim, o módulo scipy.optimize inclui a implementação dos seguintes procedimentos:
- Minimização condicional e incondicional de funções escalares de várias variáveis (minim) usando diferentes algoritmos (simples de Nelder-Mead, BFGS, gradientes conjugados de Newton, e )
- Otimização global (por exemplo: , )
- Minimização de resíduos (least_squares) e algoritmos de ajuste de curvas não lineares (curve_fit)
- Minimização de funções escalares de uma variável (minim_scalar) e busca de raízes (root_scalar)
- Resolvedores multidimensionais de sistemas de equações (root) utilizando diferentes algoritmos (híbrido de Powell, ou métodos em larga escala, como ).
Neste artigo, vamos considerar apenas o primeiro item desta lista.
Minimização incondicional de uma função escalar de várias variáveis
A função minim do pacote scipy.optimize fornece uma interface geral para resolver problemas de minimização condicional e incondicional de funções escalares de várias variáveis. Para demonstrar seu funcionamento, precisaremos de uma função adequada de várias variáveis que iremos minimizar de várias maneiras.
Para esses fins, a função de Rosenbrock de N variáveis, que tem a seguinte forma:

Embora a função de Rosenbrock e suas matrizes de Jacobiano e Hessiana (primeira e segunda derivadas, respectivamente) já estejam definidas no pacote scipy.optimize, vamos defini-la manualmente.
import numpy as np

def rosen(x):
    """A função de Rosenbrock"""
    return np.sum(100.0*(x[1:]-x[:-1]**2.0)**2.0 + (1-x[:-1])**2.0, axis=0)
Para melhor visualização, vamos plotar em 3D os valores da função de Rosenbrock em relação a duas variáveis.
Código para plotagem
from mpl_toolkits.mplot3d import Axes3D
import matplotlib.pyplot as plt
from matplotlib import cm
from matplotlib.ticker import LinearLocator, FormatStrFormatter

# Configurando o gráfico 3D
fig = plt.figure(figsize=[15, 10])
ax = fig.gca(projection='3d')

# Definindo o ângulo de visão
ax.view_init(45, 30)

# Criando dados para o gráfico
X = np.arange(-2, 2, 0.1)
Y = np.arange(-1, 3, 0.1)
X, Y = np.meshgrid(X, Y)
Z = rosen(np.array([X,Y]))

# Desenhando a superfície
surf = ax.plot_surface(X, Y, Z, cmap=cm.coolwarm)
plt.show()
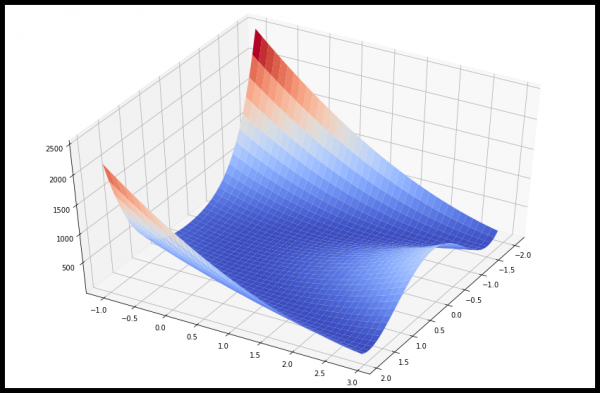
Sabendo previamente que o mínimo é 0 em  , vamos considerar exemplos de como determinar o valor mínimo da função de Rosenbrock utilizando diferentes procedimentos do scipy.optimize.
Método Simplex de Nelder-Mead
Supondo que temos um ponto inicial x0 em um espaço de 5 dimensões. Vamos encontrar o ponto de mínimo da função de Rosenbrock mais próximo a ele usando o algoritmo (o algoritmo é especificado como o valor do parâmetro method):
from scipy.optimize import minimize
x0 = np.array([1.3, 0.7, 0.8, 1.9, 1.2])
res = minimize(rosen, x0, method='nelder-mead',
    options={'xtol': 1e-8, 'disp': True})
print(res.x)
A otimização foi concluída com sucesso.
Valor atual da função: 0.000000
Iterações: 339
Avaliações da função: 571
[1. 1. 1. 1. 1.]O método Simplex é a forma mais simples de minimizar uma função claramente definida e bastante suave. Ele não requer o cálculo de derivadas da função, sendo suficiente informar apenas seus valores. O método de Nelder-Mead é uma boa escolha para problemas de minimização simples. No entanto, como não utiliza estimativas de gradiente, pode levar mais tempo para encontrar o mínimo.
Método de Powell
Outro algoritmo de otimização, que calcula apenas os valores das funções, é o . Para usá-lo, deve-se definir method = ‘powell’ na função minim.
x0 = np.array([1.3, 0.7, 0.8, 1.9, 1.2])
res = minimize(rosen, x0, method='powell',
    options={'xtol': 1e-8, 'disp': True})
print(res.x)
A otimização foi concluída com sucesso.
Valor atual da função: 0.000000
Iterações: 19
Avaliações da função: 1622
[1. 1. 1. 1. 1.]Algoritmo de Broyden-Fletcher-Goldfarb-Shanno (BFGS)
Para obter uma convergência mais rápida à solução, o procedimento usa um gradiente da função objetivo. O gradiente pode ser fornecido como uma função ou calculado usando diferenças de primeira ordem. De qualquer forma, geralmente, o método BFGS requer menos chamadas de função do que o método simplex.
Vamos encontrar a derivada da função de Rosenbrock de forma analítica:


Esta expressão é válida para as derivadas de todas as variáveis, exceto a primeira e a última, que são definidas como:


Vamos ver uma função Python que calcula esse gradiente:
def rosen_der(x):
    xm = x[1:-1]
    xm_m1 = x[:-2]
    xm_p1 = x[2:]
    der = np.zeros_like(x)
    der[1:-1] = 200 * (xm - xm_m1 ** 2) - 400 * (xm_p1 - xm ** 2) * xm - 2 * (1 - xm)
    der[0] = -400 * x[0] * (x[1] - x[0] ** 2) - 2 * (1 - x[0])
    der[-1] = 200 * (x[-1] - x[-2] ** 2)
    return der
A função que calcula o gradiente é especificada como o valor do parâmetro jac da função minim, como mostrado abaixo.
res = minimize(rosen, x0, method='BFGS', jac=rosen_der, options={'disp': True})
print(res.x)
A otimização foi concluída com sucesso.
Valor atual da função: 0.000000
Itens: 25
Avaliações de função: 30
Avaliações de gradiente: 30
[1.00000004 1.0000001 1.00000021 1.00000044 1.00000092]O algoritmo de gradientes conjugados (Newton)
O algoritmo é um método modificado de Newton.
O método de Newton baseia-se na aproximação da função em uma região local por um polinômio de segunda ordem:

onde  é a matriz das segundas derivadas (matriz Hessiana, hessiano).
Se o hessiano for positivo definido, é possível encontrar o mínimo local dessa função igualando o gradiente nulo da forma quadrática a zero. O resultado é uma expressão:

O hessiano inverso é calculado usando o método dos gradientes conjugados. Um exemplo de uso desse método para minimizar a função de Rosenbrock é mostrado abaixo. Para usar o método Newton-CG, é necessário especificar uma função que calcula o hessiano.
O hessiano da função de Rosenbrock de forma analítica é igual a:


onde  e
 , define a matriz
 .
Os restantes elementos não nulos da matriz são iguais a:


Por exemplo, em um espaço de cinco dimensões N = 5, a matriz Hessiana para a função de Rosenbrock tem a forma de banda:

O código que calcula esse hessiano junto com o código para minimizar a função de Rosenbrock usando o método dos gradientes conjugados (Newton):
def rosen_hess(x):
    x = np.asarray(x)
    H = np.diag(-400*x[:-1],1) - np.diag(400*x[:-1],-1)
    diagonal = np.zeros_like(x)
    diagonal[0] = 1200*x[0]**2-400*x[1]+2
    diagonal[-1] = 200
    diagonal[1:-1] = 202 + 1200*x[1:-1]**2 - 400*x[2:]
    H = H + np.diag(diagonal)
    return H

res = minimize(rosen, x0, method='Newton-CG',
               jac=rosen_der, hess=rosen_hess,
               options={'xtol': 1e-8, 'disp': True})
print(res.x)
A otimização foi encerrada com sucesso.
Valor atual da função: 0.000000
Iterações: 24
Avaliações de função: 33
Avaliações de gradiente: 56
Avaliações de hessiana: 24
[1. 1. 1. 0.99999999 0.99999999]Exemplo de definição da função de produto da hessiana e de um vetor arbitrário
Em problemas reais, o cálculo e o armazenamento de toda a matriz hessiana podem exigir recursos significativos de tempo e memória. No entanto, não é necessário definir a matriz hessiana em si, pois apenas o vetor, correspondente ao produto da hessiana com outro vetor arbitrário, é necessário para o procedimento de minimização. Assim, do ponto de vista computacional, é muito preferível definir imediatamente uma função que retorne o resultado do produto da hessiana com um vetor arbitrário.
Vamos considerar a função hess, que aceita o vetor de minimização como primeiro argumento e um vetor arbitrário como segundo argumento (junto com outros argumentos da função minimizada). No nosso caso, calcular o produto da hessiana da função de Rosenbrock com um vetor arbitrário não é muito complicado. Se p — vetor arbitrário, então o produto  é dado por:

A função que calcula o produto da hessiana e de um vetor arbitrário é passada como o valor do argumento hessp da função minimize:
def rosen_hess_p(x, p):
    x = np.asarray(x)
    Hp = np.zeros_like(x)
    Hp[0] = (1200*x[0]**2 - 400*x[1] + 2)*p[0] - 400*x[0]*p[1]
    Hp[1:-1] = -400*x[:-2]*p[:-2]+(202+1200*x[1:-1]**2-400*x[2:])*p[1:-1]
    -400*x[1:-1]*p[2:]
    Hp[-1] = -400*x[-2]*p[-2] + 200*p[-1]
    return Hp

res = minimize(rosen, x0, method='Newton-CG',
               jac=rosen_der, hessp=rosen_hess_p,
               options={'xtol': 1e-8, 'disp': True})
A otimização foi encerrada com sucesso.
         Valor atual da função: 0.000000
         Iterações: 24
         Avaliações de função: 33
         Avaliações de gradiente: 56
         Avaliações de hessiana: 66
Algoritmo de região de confiança (trust region) dos gradientes conjugados (Newton)
Uma má condição da matriz hessiana e direções de busca incorretas podem fazer com que o algoritmo dos gradientes conjugados de Newton seja ineficaz. Nesses casos, prefere-se (trust-region) dos gradientes conjugados de Newton.
Exemplo de definição da matriz hessiana:
res = minimize(rosen, x0, method='trust-ncg',
               jac=rosen_der, hess=rosen_hess,
               options={'gtol': 1e-8, 'disp': True})
print(res.x)
Otimização encerrada com sucesso.
Valor atual da função: 0.000000
Itens: 20
Avaliações da função: 21
Avaliações do gradiente: 20
Avaliações da Hessiana: 19
[1. 1. 1. 1. 1.]Exemplo com a função de produto da Hessiana e um vetor arbitrário:
res = minimize(rosen, x0, method='trust-ncg',
                jac=rosen_der, hessp=rosen_hess_p,
                options={'gtol': 1e-8, 'disp': True})
print(res.x)
Otimização encerrada com sucesso.
Valor atual da função: 0.000000
Itens: 20
Avaliações da função: 21
Avaliações do gradiente: 20
Avaliações da Hessiana: 0
[1. 1. 1. 1. 1.]Métodos do tipo Krylov
Assim como o método trust-ncg, os métodos do tipo Krylov são bem adequados para resolver problemas em larga escala, uma vez que utilizam apenas produtos matriciais-vetoriais. Seu cerne reside na resolução do problema em uma região de confiança limitada pelo subespaço truncado de Krylov. Para problemas indeterminados, é preferível utilizar este método, já que ele requer menos iterações não lineares devido ao menor número de produtos matriciais-vetoriais por subproblema, em comparação com o método trust-ncg. Além disso, a solução da sub-tarefa quadrática é encontrada com mais precisão do que com o método trust-ncg.
Exemplo de definição da matriz hessiana:
res = minimize(rosen, x0, method='trust-krylov',
               jac=rosen_der, hess=rosen_hess,
               options={'gtol': 1e-8, 'disp': True})

Otimização encerrada com sucesso.
         Valor atual da função: 0.000000
         Itens: 19
         Avaliações da função: 20
         Avaliações do gradiente: 20
         Avaliações da Hessiana: 18

print(res.x)

    [1. 1. 1. 1. 1.]
Exemplo com a função de produto da Hessiana e um vetor arbitrário:
res = minimize(rosen, x0, method='trust-krylov',
               jac=rosen_der, hessp=rosen_hess_p,
               options={'gtol': 1e-8, 'disp': True})

Otimização encerrada com sucesso.
         Valor atual da função: 0.000000
         Itens: 19
         Avaliações da função: 20
         Avaliações do gradiente: 20
         Avaliações da Hessiana: 0

print(res.x)

    [1. 1. 1. 1. 1.]
Algoritmo de resolução aproximada na região de confiança
Todos os métodos (Newton-CG, trust-ncg e trust-krylov) são bem adequados para resolver problemas em larga escala (com milhares de variáveis). Isso se deve ao fato de que o algoritmo subjacente de gradientes conjugados pressupõe um cálculo aproximado da matriz inversa da Hessiana. A solução é encontrada de forma iterativa, sem uma decomposição explícita da Hessiana. Como é necessário definir apenas a função para o produto da Hessiana com um vetor arbitrário, este algoritmo é especialmente bom para trabalhar com matrizes esparsas (diagonais em faixa). Isso proporciona baixo consumo de memória e uma economia significativa de tempo.
Em problemas de tamanho médio, os custos de armazenamento e a fatorização da matriz Hessiana não são decisivos. Isso significa que é possível obter uma solução em menos iterações, resolvendo as subtarefas da região de confiança quase exatamente. Para isso, algumas equações não lineares são resolvidas iterativamente para cada subtarefa quadrática. Essa abordagem geralmente requer 3 ou 4 decomposições da matriz de Cholesky da Hessiana. Como resultado, o método converge em menos iterações e requer menos avaliações da função objetivo do que outros métodos da região de confiança. Este algoritmo implica apenas na definição da matriz Hessiana completa e não suporta a possibilidade de usar a função do produto da Hessiana e um vetor arbitrário.
Exemplo de minimização da função de Rosenbrock:
res = minimize(rosen, x0, method='trust-exact',
               jac=rosen_der, hess=rosen_hess,
               options={'gtol': 1e-8, 'disp': True})
res.x
A otimização foi concluída com sucesso.
Valor atual da função: 0.000000
Iterações: 13
Avaliações da função: 14
Avaliações do gradiente: 13
Avaliações da Hessiana: 14
array([1., 1., 1., 1., 1.])Aqui vamos parar. No próximo artigo, tentarei contar o mais interessante sobre minimização condicionada, a aplicação da minimização na resolução de problemas de aproximação, minimização de funções de uma variável, minimizadores arbitrários e busca de raízes de sistemas de equações com o pacote scipy.optimize.
Fonte:
Fonte: habr.com
