

Os resultados dos testes das versões mais recentes dos SGBDs Redis 8.0 e Valkey 8.1 foram apresentados, com declarações de otimizações significativas no desempenho. Em todos os testes realizados, o fork desenvolvido pela comunidade superou o projeto original, principalmente devido à implementação no Valkey de um novo mecanismo para processamento assíncrono de entrada/saída multitarefa, que foi fornecido ao projeto pela Amazon.
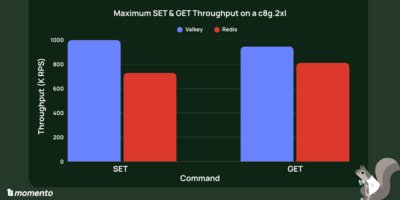
No ambiente de teste AWS Graviton4 c8g.2xlarge com 8 VCPU, o Valkey 8.1.1 conseguiu alcançar um desempenho de 999,8 mil solicitações SET por segundo, enquanto no Redis 8.0 foi atingido um nível de 729,4 mil solicitações por segundo. Em geral, a taxa de transferência do Valkey foi 37% superior à do Redis para operações SET e 16% superior para operações GET. Além disso, em comparação ao Redis, o projeto Valkey demonstrou uma redução nas latências no processamento de solicitações em 30% para operações SET e em 60% para operações GET.
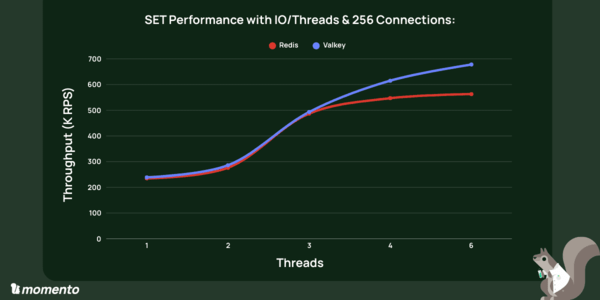
Além disso, foi realizada uma análise da variação da taxa de transferência e das latências em função do número de manipuladores executados em paralelo no modo de processamento multitarefa de entrada/saída. Com até 3 threads, Valkey e Redis mostram resultados aproximadamente iguais, mas então o Valkey se destaca. Com 6 threads em um sistema com 8 VCPU, o desempenho do Valkey alcançou 678 mil solicitações SET por segundo, enquanto o Redis ficou em 563 mil solicitações por segundo, com um limite de 256 conexões simultâneas. Ao aumentar as conexões para 400, o desempenho do Valkey cresceu para 832 mil solicitações SET por segundo.
Após a otimização do processamento de interrupções no sistema para reduzir a troca de contexto, o Valkey conseguiu aumentar o desempenho para 999,8 mil solicitações SET por segundo. O cerne da otimização consistiu em alocar 2 VCPU para o processamento de interrupções e vincular as 6 VCPU restantes aos threads de processamento de entrada/saída do Valkey e do Redis, para evitar a migração de manipuladores entre as CPUs. sudo ethtool -L ens34 combined 2 # limitando o número de manipuladores IRQ a 2 grep ens34 /proc/interrupts # verificando quais manipuladores estão ativos (99 e 100) echo 1 | sudo tee /proc/irq/99/smp_affinity # vinculando o manipulador 99 ao núcleo 1 echo 2 | sudo tee /proc/irq/100/smp_affinity # vinculando o manipulador 100 ao núcleo 2 # Iniciando o SGBD (para o Redis, troque valkey/valkey:8.1.1 por redis:8.0) vinculando o contêiner aos núcleos de CPU 2-7 docker run —network="host" —rm \ —cpuset-cpus="2-7" valkey/valkey:8.1.1 \ —save "" —appendonly no —io-threads 6 \ —protected-mode no —maxmemory 10gb
Para testes de desempenho, foi utilizado o comando: docker run —network="host" —rm —cpuset-cpus="2-7" \ valkey/valkey:8.0.1 valkey-benchmark \ -h 172.31.4.92 -p 6379 -t SET,GET -n 100000000 -c 256 \ -r 3000000 —threads 6 -d 1024
Fonte: opennet.ru
