

Foi lançado o Redis 8.4, um sistema de gerenciamento de banco de dados NoSQL. O Redis oferece funcionalidades para armazenar dados no formato chave/valor, ampliadas pelo suporte a formatos de dados estruturados, como listas, hashes e conjuntos, além da possibilidade de executar scripts de manipuladores em Lua no lado do servidor. O código do projeto é escrito em C e é distribuído sob a licença AGPLv3.
O Redis suporta transações que permitem executar um grupo de comandos em um único passo, garantindo a consistência e a sequência (comandos de outras requisições não podem interferir) na execução do conjunto de comandos especificado, e em caso de problemas, permitindo reverter as mudanças. Todos os dados são totalmente armazenados em memória. Bibliotecas de cliente estão disponíveis para a maioria das linguagens populares, incluindo Perl, Python, PHP, Java, Ruby e Tcl.
Para o gerenciamento de dados, são fornecidos comandos como incremento/decremento, operações padrão em listas e conjuntos (união, interseção), renomeação de chaves, seleções múltiplas e funções de ordenação. Dois modos de armazenamento são suportados: sincronização periódica de dados no disco e manutenção de um log de alterações no disco. No segundo caso, é garantida a preservação completa de todas as alterações. É possível organizar replicação de dados master-slave em vários servidores, realizada em modo não bloqueante. Também está disponível o modo de troca de mensagens 'publicação/inscrição', onde um canal é criado e mensagens desse canal são distribuídas para clientes que se inscrevem.
Principais mudanças no Redis 8.4:
- Adicionada o comando "FT.HYBRID" com a implementação de busca híbrida, combinando em uma única consulta funcionalidades de busca de texto completo e busca vetorial, levando em consideração tanto coincidências diretas quanto proximidade semântica. Suporte para agregação de resultados com a sintaxe do comando "FT.AGGREGATE".
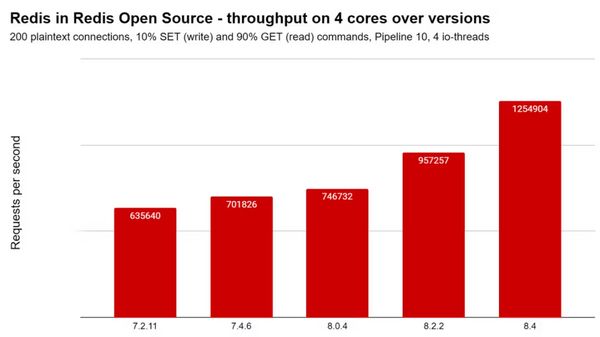
- Aumentada a taxa de transferência em aplicações típicas do Redis para caching. Por exemplo, em cargas de trabalho que incluem 10% de operações de gravação (SET) e 90% de operações de leitura (GET) com valores de string de 1 KB, houve um aumento de 30% na taxa de transferência.

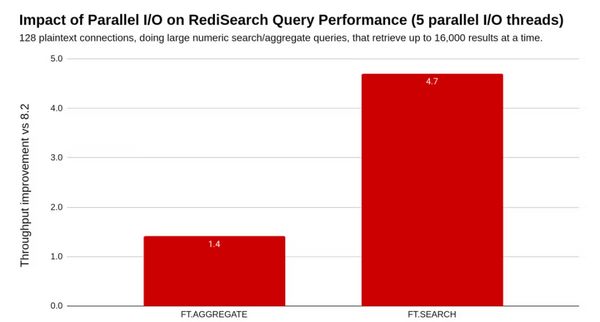
- Aumentada a performance das operações de busca (FT.SEARCH) e agregação de resultados (FT.AGGREGATE). Em sistemas sob carga com um grande número de consultas paralelas, observou-se um aumento na taxa de transferência e redução de latência de até 4,7 vezes durante buscas e de 1,4 vezes durante a agregação de resultados.

- Otimizada a alocação de memória ao executar consultas, e fornecida a possibilidade de ajustar o comportamento ao esgotar a memória disponível (OOM, out-of-memory).
- Reduzido o consumo de memória ao armazenar pequenas strings (até 7 bytes) em estruturas do tipo JSON. Por exemplo, um array em JSON que inclui 500 pequenos elementos no formato chave/valor agora ocupa 37% menos memória.
- Aumentada a eficiência de armazenamento de arrays numéricos em JSON, cujos elementos possuem um único tipo (se antes o tipo era salvo para cada elemento, agora o tipo é salvo uma vez para todo o array). Em testes realizados, esses arrays com um milhão de elementos homogêneos agora requerem de 50% a 92% menos memória, dependendo do tipo.
- Adicionadas opções IFEQ, IFNE, IFDEQ e IFDNE ao comando SET, permitindo que uma única operação atualize a chave de string em situações onde o valor associado não foi alterado por outro cliente desde sua extração.
- Foi adicionada o comando XDELEX para remoção atômica de uma chave de string, se o valor associado não tiver mudado desde a extração.
- Foi adicionada a comando DIGEST, que retorna o hash do valor associado à chave especificada.
- Na comando XREADGROUP, foi adicionada a opção "CLAIM " para ler tanto mensagens pendentes (idle pending) quanto recebidas (incoming).
- Foi adicionada a comando MSETEX para definir ou atualizar atômica e simultaneamente várias chaves de string, além de atualizar seu tempo de vida.
- Foi adicionado um mecanismo de migração atômica de slots entre nós de cluster (ASM — Atomic Slot Migration), que é similar à replicação síncrona total, mas opera no nível de slots individuais de armazenamento de dados. Foi adicionada a comando CLUSTER MIGRATION, através da qual é possível importar slots de outros nós, rastrear o progresso da migração e marcar operações de migração pendentes, se necessário.
- Foi adicionada a comando CLUSTER SLOT-STATS para avaliar estatísticas no cluster com relação a slots individuais, como o número de chaves, carga de CPU e entrada/saída de rede.
Fonte: opennet.ru
