

Em junho deste ano, a pequena cidade suíça de Rapperswil sediou pela décima vez um evento chamado . Desta vez, mais de quinhentos entusiastas de Haskell, desde iniciantes até os fundadores da linguagem, se reuniram. Embora os organizadores chamem isso de hackathon, não é uma conferência ou hackathon no sentido clássico. Seu formato se difere dos eventos tradicionais de programação. Descobrimos o ZuriHac por acaso, participamos dele e agora sentimos que é nosso dever compartilhar sobre essa descoberta surpreendente!
Sobre nós
Este artigo foi preparado por dois estudantes do terceiro ano do programa de „Matemática Aplicada e Informática“ da HSE - São Petersburgo: Vasily Alférov e Elizaveta Vasilenko. O interesse pela programação funcional para ambos começou com um ciclo de palestras de D. N. Moskvin no segundo ano da universidade. Atualmente, Vasily participa do programa Google Summer of Code, onde está implementando grafos algébricos na linguagem Haskell sob a supervisão da equipe do projeto . Elizaveta aplicou as habilidades adquiridas em programação funcional em seu trabalho de curso, que se dedicou à implementação de um algoritmo de anti-unificação com aplicação posterior na teoria de tipos.
Formato do evento
O público-alvo inclui proprietários de projetos de código aberto, programadores que desejam participar de seu desenvolvimento, pesquisadores em programação funcional e simplesmente pessoas apaixonadas por Haskell. Este ano, no local do evento – a universidade HSR Hochschule für Technik Rapperswil – reuniram-se desenvolvedores de mais de cinquenta projetos abertos em Haskell de todo o mundo, para apresentar seus produtos e interessar novas pessoas em seu desenvolvimento.
Fotos do Twitter
O esquema é muito simples: você deve escrever algumas frases sobre seu projeto e enviá-las aos organizadores, que publicarão as informações sobre seu projeto na página do evento. Além disso, no primeiro dia, os autores dos projetos têm trinta segundos para contar brevemente no palco o que estão fazendo e o que precisa ser feito. Depois, as pessoas que se interessam buscam os autores e fazem perguntas detalhadas sobre as tarefas.
Atualmente não temos projetos abertos próprios, mas queremos muito contribuir para os já existentes, por isso nos registramos como participantes comuns. Durante três dias, trabalhamos com duas equipes de desenvolvedores. Através do estudo conjunto do código e da comunicação ao vivo, conseguimos tornar a interação entre os autores do projeto e os contribuidores bastante produtiva – no ZuriHac conseguimos entender novas áreas e ajudamos duas equipes completamente diferentes, resolvendo uma tarefa em cada um dos projetos.
Além da valiosa prática, também ocorreram várias palestras e workshops no ZuriHac. Duas palestras, em particular, nos marcaram. Na primeira, Andrey Mokhov, da Universidade de Newcastle, falou sobre funtores aplicativos seletivos — uma classe de tipos que deve servir como intermediária entre funtores aplicativos e monadas. Na outra palestra, um dos fundadores do Haskell, Simon Peyton Jones, explicou como funciona a inferência de tipos no compilador GHC.
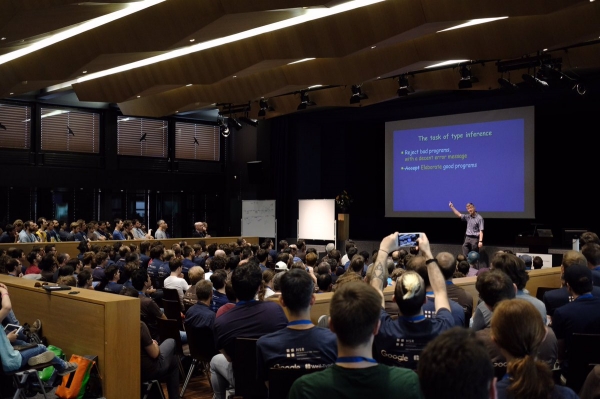
Palestra de Simon Peyton Jones. Foto do Twitter
Os workshops realizados durante o hackathon foram divididos em três categorias, dependendo do nível de preparo dos participantes. As tarefas propostas para os participantes que se juntaram ao desenvolvimento dos projetos também apresentavam marcações de dificuldade. A comunidade pequena, mas unida, de programadores funcionais acolhe novos membros com alegria. No entanto, para entender as palestras de Andrey Mokhov e Simon Peyton Jones, o curso de programação funcional que fizemos na universidade foi extremamente útil.
Para os participantes comuns e os autores dos projetos, a inscrição para o evento é gratuita. Nós nos inscrevemos no início de junho, e logo fomos rapidamente transferidos da lista de espera para a lista de participantes confirmados.
Agora vamos falar sobre os projetos em que participamos do desenvolvimento.
Pandoc
é um conversor universal de documentos textuais, de fato — de qualquer formato para qualquer outro. Por exemplo, de docx para pdf, ou de Markdown para MediaWiki. Seu autor, John MacFarlane, é professor de filosofia na Universidade da Califórnia em Berkeley. De fato, o Pandoc é bastante conhecido, e alguns dos nossos conhecidos ficaram surpresos ao saber que o Pandoc foi escrito em Haskell.
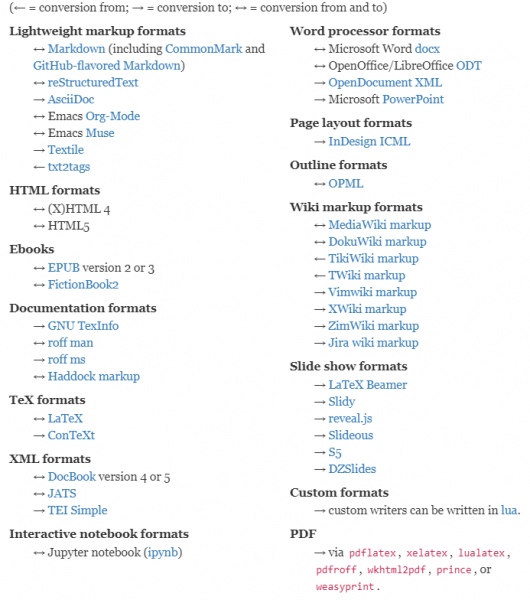
Lista de formatos de documentos suportados pelo Pandoc. No site, há também um gráfico inteiro, mas esta imagem não cabe no artigo.
Claro, o Pandoc não implementa a conversão direta para cada par de formatos. Para suportar uma tão ampla variedade de transformações, utiliza-se uma solução arquitetônica padrão: primeiro, todo o documento é traduzido para uma representação interna intermediária especial, e depois, com base nessa representação interna, um documento é gerado em outro formato. A representação interna é chamada pelos desenvolvedores de 'AST', que significa Árvore de Sintaxe Abstrata, ou . É muito simples visualizar a representação intermediária: basta definir como formato de saída o 'native'
$ cat example.html
<h1>Olá, Mundo!</h1>

$ pandoc -f html -t native example.html
[Cabeçalho 1 ("hello-world",[],[]) [Str "Olá,",Space,Str "Mundo!"]]
Leitores que trabalharam um pouco com Haskell podem, a partir desse pequeno exemplo, supor que o Pandoc foi escrito em Haskell: a saída desse comando é a representação das estruturas internas do Pandoc em formato de string, criada à semelhança do que geralmente se faz em Haskell, por exemplo, na biblioteca padrão.
Assim, aqui podemos ver que a representação interna é uma estrutura recursiva, onde cada nó interno contém uma lista. Por exemplo, no nível mais alto, há uma lista com um único elemento — um cabeçalho de primeiro nível com os atributos 'hello-world', [], []. Dentro desse cabeçalho está uma lista com a string 'Hello,', um espaço e a string 'World!'.
Como pode ser visto, a representação interna não é muito diferente do HTML. Ela representa uma árvore, onde cada nó interno fornece informações sobre a formatação de seus descendentes, e nas folhas está o conteúdo propriamente dito do documento.
Se olharmos para a implementação específica, o tipo de dados para todo o documento é definido assim:
data Pandoc = Pandoc Meta [Block]Aqui, Block são exatamente os vértices internos mencionados acima, enquanto Meta é a metainformação sobre o documento, como título, data de criação, autores — para diferentes formatos esta informação varia, e o Pandoc tenta preservar essas informações sempre que possível durante a conversão de formato para formato.
Quase todos os construtores do tipo Block — por exemplo, Header ou Para (parágrafo) — aceitam como argumentos atributos e uma lista de nós de nível inferior — que normalmente são do tipo Inline. Por exemplo, Space ou Str são construtores do tipo Inline, e a tag HTML se transforma também em seu tipo especial Inline. Não vemos sentido em fornecer uma definição completa desses tipos, mas notamos que ela pode ser consultada aqui. .
É interessante notar que o tipo Pandoc é um monóide. Isso significa que existe algum documento vazio, e que os documentos podem ser concatenados. Isso é conveniente ao escrever Readers — é possível dividir o documento em partes com uma lógica arbitrária, analisar cada uma separadamente e, em seguida, reunir tudo em um único documento. Nesse processo, as metainformações serão recolhidas de todas as partes do documento ao mesmo tempo.
Na conversão, digamos, de LaTeX para HTML, primeiro um módulo especial chamado LaTeXReader transforma o documento de entrada em um AST, depois outro módulo chamado HTMLWriter converte o AST em HTML. Graças a essa arquitetura, não é necessário escrever um número quadrático de conversões — basta para cada novo formato escrever um Reader e um Writer, e todos os pares de conversões possíveis serão automaticamente suportados.
É evidente que essa arquitetura tem suas desvantagens, que já foram previstas por especialistas em arquitetura de software. A mais significativa é o custo de fazer mudanças na árvore sintática. Se a mudança for suficientemente séria, será necessário modificar o código em todos os Readers e Writers. Por exemplo, uma das tarefas que desafiam os desenvolvedores do Pandoc é o suporte a formatos complexos de tabelas. Atualmente, o Pandoc só consegue lidar com tabelas muito simples, com cabeçalho, colunas e valores em cada célula. Por exemplo, o atributo colspan em HTML será simplesmente ignorado. Uma das razões para tal comportamento é a falta de um esquema único de representação de tabelas em todos ou pelo menos muitos formatos — e, portanto, não está claro em que formato as tabelas devem ser armazenadas na representação interna. Mas mesmo após a escolha de uma representação específica, será necessário mudar absolutamente todos os Readers e Writers que suportam o trabalho com tabelas.
A linguagem Haskell foi escolhida não apenas pelo grande amor dos autores pela programação funcional. Haskell é conhecida por suas amplas capacidades de manipulação de texto. Um dos exemplos é a biblioteca — uma biblioteca que utiliza ativamente os conceitos da programação funcional — monoides, mónadas, funtores aplicativos e alternativos — para escrever parsers arbitrários. Todo o poder do Parsec pode ser visto em no HaskellWiki, onde é analisado um parser completo de uma linguagem de programação imperativa simples. Naturalmente, o Parsec é amplamente utilizado no Pandoc.
Se descrevermos de forma breve, as mónadas são usadas para parsing sequencial, onde primeiro um é lido e depois o outro. Por exemplo, neste caso:
whileParser :: Parser Stmt
whileParser = whiteSpace >> statement
Primeiro é necessário ler o espaço em branco, e depois o statement — que também tem o tipo Parser Stmt.
Funtores alternativos são usados para retroceder caso o parsing não funcione. Por exemplo,
statement :: Parser Stmt
statement = parens statement  sequenceOfStmt
Significa que devemos tentar ler o statement entre parênteses ou tentar ler vários statements em sequência.
Funtores aplicativos são usados principalmente como caminhos curtos para as mónadas. Por exemplo, suponha que a função tok lê algum token (esta é uma função real do LaTeXReader). Vamos analisar essa combinação
const tok tokEla lerá dois tokens consecutivos e retornará o primeiro deles.
Para todas essas classes, em Haskell existem belos operadores simbólicos, o que torna a programação de Readers parecida com arte ASCII. Apenas admire este código extraordinário.
Nossas tarefas estavam relacionadas ao LaTeXReader. A tarefa de Vasily era desenvolver suporte para os comandos mbox e hbox, úteis na elaboração de pacotes em LaTeX. A responsabilidade de Elizabeth era adicionar suporte para o comando epigraph, que permite formatar epígrafes em documentos LaTeX.
Hatrace
Em sistemas operacionais similares ao UNIX, a chamada de sistema ptrace é frequentemente implementada. Ela é útil para depuração e simulação de ambientes de programas, permitindo rastrear as chamadas de sistema feitas por um programa. Por exemplo, a ferramenta bastante útil strace utiliza exatamente o ptrace internamente.
Hatrace é uma biblioteca que fornece uma interface para ptrace em Haskell. O fato é que o próprio ptrace é bastante complexo e usá-lo diretamente pode ser bem complicado, especialmente a partir de linguagens funcionais.
Ao ser iniciado, o Hatrace funciona como o strace e aceita argumentos semelhantes. Sua diferença em relação ao strace é que também é uma biblioteca, oferecendo uma interface mais simples do que apenas ptrace.
Com o hatrace, já conseguimos detectar um bug problemático no compilador Haskell GHC — ao ser terminado em um momento inoportuno, ele gera arquivos objeto incorretos e não os recompila ao reiniciar. O rastreamento dos syscalls permitiu reproduzir de forma confiável o erro em uma única execução, onde finalizações aleatórias reproduziam o erro em cerca de duas horas.
Adicionamos à biblioteca interfaces de syscalls — Elizabeth adicionou brk e Vasily adicionou mmap. Como resultado do nosso trabalho, é possível usar os argumentos desses syscalls de forma mais simples e precisa ao usar a biblioteca.
Fonte: habr.com
