

De 30 de novembro a 1 de dezembro, ocorreu em Nizhny Novgorod. Os participantes foram desafiados a criar um protótipo de solução de produto utilizando o Intel OpenVINO toolkit. Os organizadores forneceram uma lista de temas sugeridos, mas a decisão final coube às equipes. Além disso, o uso de modelos não incluídos no produto era incentivado.
Neste artigo, falaremos sobre como criamos nosso protótipo de produto, com o qual acabamos conquistando o primeiro lugar.
Mais de 10 equipes participaram do hackathon. É bom notar que algumas delas vieram de outras regiões. O local escolhido para o hackathon foi o complexo “Kremlin na Pochaina”, que estava decorado com fotos antigas de Nizhny Novgorod, criando uma atmosfera encantadora! (Lembro que atualmente o escritório central da Intel está localizado em Nizhny Novgorod). Os participantes tiveram 26 horas para programar e, no final, era necessário apresentar sua solução. Um dos pontos positivos foi a presença de uma sessão de demonstração, para garantir que tudo o que foi idealizado fosse realmente implementado, e não apenas deixado como ideias na apresentação. Também houve mercadorias, lanches e comida!
Além disso, a Intel ofereceu câmeras, Raspberry PI e Neural Compute Stick 2, conforme solicitado.
Escolha da tarefa
Uma das partes mais desafiadoras da preparação para um hackathon de tema livre é a escolha do problema. Assim, decidimos criar algo que ainda não existisse no produto, uma vez que foi mencionado no anúncio que isso seria bem-vindo.
Analisando , que estão incluídos no produto na versão atual, chegamos à conclusão de que a maioria deles resolve diversas questões de visão computacional. De fato, é muito difícil imaginar um problema na área de visão computacional que não possa ser resolvido usando o OpenVINO, e mesmo que consiga pensar em um, é complicado encontrar modelos pré-treinados disponíveis publicamente. Então, decidimos explorar outra direção — focar no processamento e análise de fala. Estamos considerando um problema interessante de reconhecimento de emoções pela fala. É importante mencionar que o OpenVINO já possui um modelo que determina as emoções de uma pessoa pelo rosto, mas:
- Teoricamente, é possível criar um algoritmo combinado que funcione tanto com som quanto com imagem, o que deve aumentar a precisão.
- As câmeras geralmente têm um ângulo de visão estreito, para cobrir uma grande área, você precisaria de mais de uma câmera, o som não possui essa limitação.
Desenvolvendo a ideia: vamos basear a ideia no segmento de varejo. É possível determinar a satisfação do cliente nos caixas das lojas. Se um dos clientes estiver insatisfeito com o serviço e começar a elevar a voz, podemos chamar imediatamente o administrador para ajudar.
Nesse caso, precisamos adicionar reconhecimento de voz, isso nos permitirá diferenciar os funcionários da loja dos clientes, fornecendo análises para cada indivíduo. Além disso, também poderemos analisar o comportamento dos próprios funcionários da loja, avaliando a atmosfera no grupo, soa bem!
Estamos formando os requisitos para nossa solução:
- Tamanho pequeno do dispositivo-alvo
- Operação em tempo real
- Baixo custo
- Fácil escalabilidade
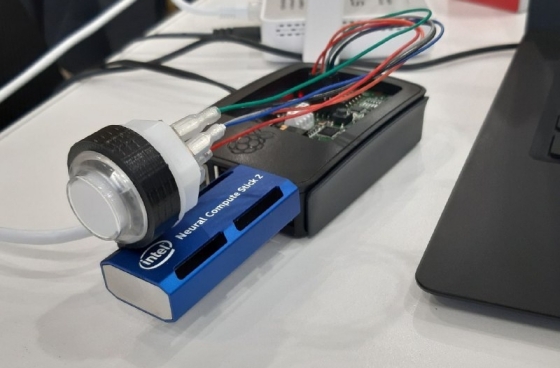
Assim, escolhemos o Raspberry Pi 3 como dispositivo-alvo com .
Aqui, é importante observar uma característica importante do NCS — ele funciona melhor com arquiteturas CNN padrão, se você precisar executar um modelo com camadas personalizadas, então espere uma otimização de baixo nível.
O próximo passo é conseguir um microfone. Um microfone USB comum funcionará, embora não combine muito bem com o RPI. Mas aqui a solução está literalmente ao alcance. Para gravar a voz, decidimos usar a placa Voice Bonnet do kit , que possui um microfone estéreo soldado.
Baixamos o Raspbian do e gravamos em um pen drive, testando se o microfone funciona com o seguinte comando (ele gravará um áudio de 5 segundos e salvará em um arquivo):
arecord -d 5 -r 16000 test.wavVale ressaltar que o microfone é muito sensível e capta bem os ruídos. Para corrigir isso, vamos ao alsamixer, escolhemos os dispositivos de captura e reduzimos o nível de sinal de entrada para 50-60%.
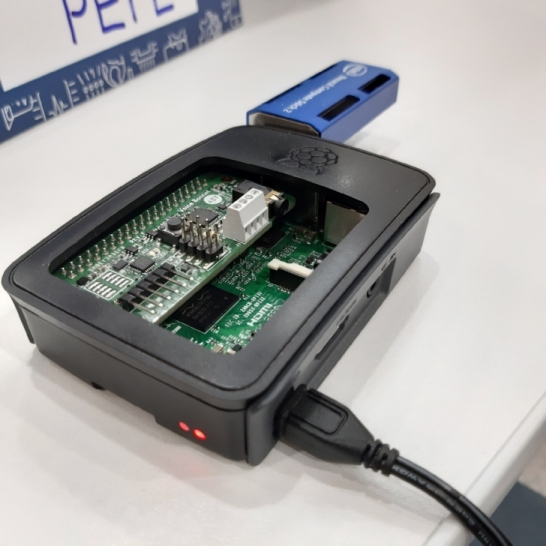
Ajustamos o corpo com uma lima e tudo se encaixa, podemos até fechar com a tampa.
Adicionamos um botão indicador.
Durante a desmontagem do AIY Voice Kit, lembramos que há um botão RGB, cuja iluminação pode ser controlada programaticamente. Procuramos 'Google AIY Led' e encontramos a documentação:
Por que não usar esse botão para exibir a emoção reconhecida? Temos apenas 7 classes, e o botão tem 8 cores, que são suficientes!
Conectamos o botão via GPIO ao Voice Bonnet, carregamos as bibliotecas necessárias (já instaladas na distribuição do AIY projects)
from aiy.leds import Leds, Color
from aiy.leds import RgbLeds
Vamos criar um dicionário, onde cada emoção corresponde a uma cor em forma de Tupla RGB e um objeto da classe aiy.leds.Leds, através do qual atualizaremos a cor:
led_dict = {'neutral': (255, 255, 255), 'happy': (0, 255, 0), 'sad': (0, 255, 255), 'angry': (255, 0, 0), 'fearful': (0, 0, 0), 'disgusted':  (255, 0, 255), 'surprised':  (255, 255, 0)}
leds = Leds()
E, finalmente, após cada nova previsão de emoção, atualizaremos a cor do botão de acordo com ela (pela chave).
leds.update(Leds.rgb_on(led_dict.get(classes[prediction])))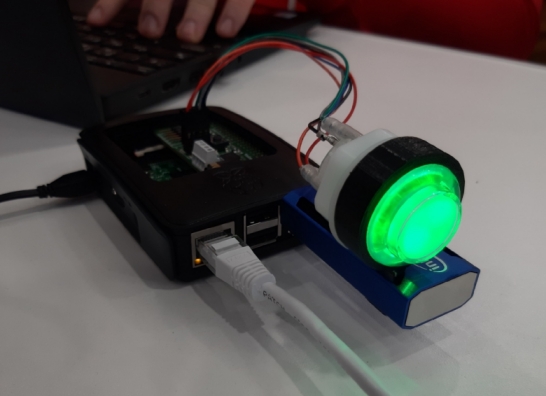
Botão, acenda!
Trabalhando com a voz
Usaremos pyaudio para capturar o fluxo do microfone e webrtcvad para filtrar o ruído e detectar a voz. Além disso, criaremos uma fila, onde iremos adicionar e retirar trechos de voz de forma assíncrona.
Como o webrtcvad tem uma limitação no tamanho do fragmento apresentado — ele deve ser igual a 10/20/30ms, e o treinamento do modelo para reconhecimento de emoções (como descobriremos mais adiante) foi feito em um dataset de 48kHz, iremos capturar chunks de tamanho 48000×20ms/1000×1(mono)=960 bytes. O webrtcvad retornará True/False para cada um desses chunks, indicando a presença ou ausência de voz no chunk.
Implementaremos a seguinte lógica:
- Iremos adicionar à lista aqueles chunks onde há voz, se não houver voz, incrementamos o contador de chunks vazios.
- Se o contador de chunks vazios >=30 (600 ms), então verificamos o tamanho da lista de chunks acumulados, se for >250, adicionamos à fila, caso contrário, consideramos que a duração da gravação não é suficiente para enviá-la ao modelo para identificar o falante.
- Se o contador de chunks vazios ainda < 30, e o tamanho da lista de chunks acumulados ultrapassou 300, então adicionaremos o trecho à fila para uma previsão mais precisa. (pois com o tempo as emoções tendem a mudar)
 def to_queue(frames):
    d = np.frombuffer(b''.join(frames), dtype=np.int16)
    return d

framesQueue = queue.Queue()
def framesThreadBody():
    CHUNK = 960
    FORMAT = pyaudio.paInt16
    CHANNELS = 1
    RATE = 48000

    p = pyaudio.PyAudio()
    vad = webrtcvad.Vad()
    vad.set_mode(2)
    stream = p.open(format=FORMAT,
                channels=CHANNELS,
                rate=RATE,
                input=True,
                frames_per_buffer=CHUNK)
    false_counter = 0
    audio_frame = []
    while process:
        data = stream.read(CHUNK)
        if not vad.is_speech(data, RATE):
            false_counter += 1
            if false_counter >= 30:
                if len(audio_frame) > 250:
                    framesQueue.put(to_queue(audio_frame,timestamp_start))
                    audio_frame = []
                    false_counter = 0

        if vad.is_speech(data, RATE):
            false_counter = 0
            audio_frame.append(data)
            if len(audio_frame) > 300:
                framesQueue.put(to_queue(audio_frame,timestamp_start))
                audio_frame = []
Chegou a hora de procurar modelos pré-treinados disponíveis publicamente, vamos ao github, pesquisamos, mas lembramos que temos uma limitação na arquitetura utilizada. Esta parte é bastante complicada, pois é necessário testar os modelos com nossos dados de entrada e, além disso, converter para o formato interno do OpenVINO — IR (Representação Intermediária). Testamos cerca de 5 a 7 soluções diferentes no github, e enquanto o modelo para reconhecimento de emoções funcionou imediatamente, com o reconhecimento de voz foi necessário um tempo maior — são utilizadas arquiteturas mais complexas.
Paramos nas seguintes:
- Emoções na voz —
Ela funciona com o seguinte princípio: o áudio é cortado em trechos de tamanho específico, e para cada um desses trechos, extraímos e em seguida os fornecemos como entrada para a CNN - Reconhecimento de voz —
Aqui, em vez de MFCC, trabalhamos com espectrogramas, após a FFT, enviamos o sinal para a CNN, onde obtemos uma representação vetorial da voz na saída.
A seguir, falaremos sobre a conversão de modelos, começando pela teoria. O OpenVINO inclui vários módulos:
- Open Model Zoo, modelos dos quais podem ser utilizados e incluídos em seu produto
- Model Optimizer, que permite converter modelos de diversos formatos de frameworks (Tensorflow, ONNX, etc.) para o formato de Representação Intermediária, com o qual trabalharemos a seguir
- Inference Engine permite executar modelos em formato IR em processadores Intel, chips Myriad e aceleradores Neural Compute Stick
- A versão mais eficiente do OpenCV (com suporte ao Inference Engine)
Cada modelo no formato IR é descrito por dois arquivos: .xml e .bin.
Os modelos são convertidos para o formato IR através do Model Optimizer da seguinte maneira:python /opt/intel/openvino/deployment_tools/model_optimizer/mo_tf.py --input_model speaker.hdf5.pb --data_type=FP16 --input_shape [1,512,1000,1]--data_typepermite escolher o formato dos dados que o modelo utilizará. Os formatos suportados são FP32, FP16 e INT8. A escolha do tipo de dado ideal pode proporcionar um bom ganho de desempenho.
--input_shapeindica as dimensões dos dados de entrada. A possibilidade de alterá-las dinamicamente parece estar disponível na API C++, mas não aprofundamos tanto e, para um dos modelos, simplesmente fixamos isso.
A seguir, tentaremos carregar o modelo já convertido no formato IR através do módulo DNN no OpenCV e realizar uma forward sobre ele.import cv2 as cv emotionsNet = cv.dnn.readNet('emotions_model.bin', 'emotions_model.xml') emotionsNet.setPreferableTarget(cv.dnn.DNN_TARGET_MYRIAD)A última linha, neste caso, permite redirecionar os cálculos para o Neural Compute Stick; normalmente, os cálculos são realizados no processador, mas no caso do Raspberry Pi isso não se aplicará, será necessário um stick.
Em seguida, a lógica é a seguinte: vamos dividir nosso áudio em janelas de tamanho específico (neste caso, 0.4s), cada uma dessas janelas será transformada em MFCC, que depois serão alimentadas na rede:
emotionsNet.setInput(MFCC_from_window)
result = emotionsNet.forward()
Depois, vamos pegar a classe mais frequentemente encontrada para todas as janelas. É uma solução simples, mas para o hackathon não é necessário inventar algo muito complexo, a menos que haja tempo. Temos muito trabalho pela frente, então vamos continuar — entendendo o reconhecimento por voz. Precisamos criar uma base onde as espectrogramas de vozes gravadas previamente fiquem armazenadas. Como temos pouco tempo, resolveremos isso como pudermos.
Ou seja, criamos um script para gravar um trecho de voz (ele funciona da mesma maneira que descrito acima, mas quando interrompido pelo teclado, ele salvará a voz em um arquivo).
Vamos tentar:
python3 voice_db/record_voice.py test.wavGravamos as vozes de várias pessoas (neste caso, três membros da equipe)
Em seguida, para cada voz gravada, aplicamos a transformada rápida de Fourier, obtemos a espectrograma e a salvamos como uma matriz numpy (.npy):for file in glob.glob("voice_db/*.wav"): spec = get_fft_spectrum(file) np.save(file[:-4] + '.npy', spec)Mais detalhes no arquivo
create_base.py
No final, ao executar o script principal, receberemos inicialmente os embeddings dessas espectrogramas:for file in glob.glob("voice_db/*.npy"): spec = np.load(file) spec = spec.astype('float32') spec_reshaped = spec.reshape(1, 1, spec.shape[0], spec.shape[1]) srNet.setInput(spec_reshaped) pred = srNet.forward() emb = np.squeeze(pred)Após receber o embedding do trecho de áudio, podemos determinar a quem ele pertence, calculando a distância cosseno entre o trecho e todas as vozes na base (quanto menor, maior a probabilidade) — para a demonstração, estabelecemos um limite de 0,3):
        dist_list = cdist(emb, enroll_embs, metric="cosine")
        distances = pd.DataFrame(dist_list, columns = df.speaker)
Por fim, destaco que a velocidade de inferência foi rápida e permitiu a adição de mais 1-2 modelos (em uma amostra de 7 segundos, a inferência levava 2,5). Já não conseguíamos adicionar novos modelos e focamos na escrita do protótipo do aplicativo web.
Aplicativo Web
Ponto importante: levamos o roteador de casa e configuramos nossa rede local, facilitando a conexão entre o dispositivo e os laptops na rede.
O backend é um canal de mensagens contínuo entre o frontend e o Raspberry Pi, baseado na tecnologia websocket (http sobre protocolo tcp).
A primeira etapa é obter informações processadas do Raspberry, ou seja, previsões empacotadas em json, que ao longo do caminho ficam armazenadas em um banco de dados, permitindo a formação de estatísticas sobre o estado emocional do usuário ao longo do período. Em seguida, esse pacote é enviado para o frontend, que utiliza a assinatura e a obtenção de pacotes do endpoint websocket. Todo o mecanismo do backend é construído na linguagem golang, escolhida por sua adequação a tarefas assíncronas, que são bem gerenciadas por goroutines.
Ao acessar o endpoint, o usuário se registra e é inserido na estrutura, depois ocorre a recepção de sua mensagem. Tanto o usuário quanto a mensagem são inseridos em um hub comum, de onde as mensagens são enviadas adiante (para o frontend assinado), e se o usuário fecha a conexão (Raspberry ou frontend), sua assinatura é anulada e ele é removido do hub.
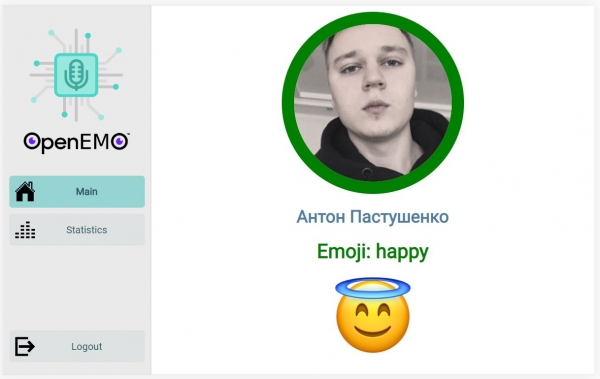
Aguardamos a conexão com o backendO front-end é um aplicativo web desenvolvido em JavaScript utilizando a biblioteca React para acelerar e simplificar o processo de desenvolvimento. O objetivo deste aplicativo é a visualização de dados obtidos por meio de algoritmos executados no lado do back-end e diretamente no Raspberry Pi. A página possui roteamento por seções, implementado com react-router, mas o principal interesse é a página inicial, onde um fluxo contínuo de dados do servidor chega em tempo real através da tecnologia WebSocket. O Raspberry Pi detecta a voz, determina a afiliação a uma pessoa específica da base de dados registrada e envia uma lista de probabilidades ao cliente. O cliente exibe os dados mais recentes, mostra a foto da pessoa que com maior probabilidade falou no microfone, assim como a emoção com que pronuncia as palavras.

Página inicial com previsões atualizáveisConclusão
Não conseguimos concluir tudo como planejado, simplesmente não tivemos tempo, então nossa principal esperança estava na demonstração, na expectativa de que tudo funcionasse. Na apresentação, falamos sobre como tudo foi estruturado, quais modelos foram adotados e quais problemas enfrentamos. Depois, houve a parte da demonstração — os especialistas circularam pela sala aleatoriamente e se aproximaram de cada equipe para ver o protótipo funcionando. Fizeram perguntas para nós, cada um respondeu sobre sua parte, deixamos a web no notebook e realmente funcionou como esperado.
Vale ressaltar que o custo total da nossa solução foi de 150$:
- Raspberry Pi 3 ~ 35$
- Google AIY Voice Bonnet (é possível usar a placa respeaker) ~ 15$
- Intel NCS 2 ~ 100$
Como melhorar:
- Utilizar registro do cliente — pedir para ler um texto gerado aleatoriamente
- Adicionar mais alguns modelos: a partir da voz, é possível determinar o gênero e a idade
- Separar vozes que soam simultaneamente (diarização)
Repositório:

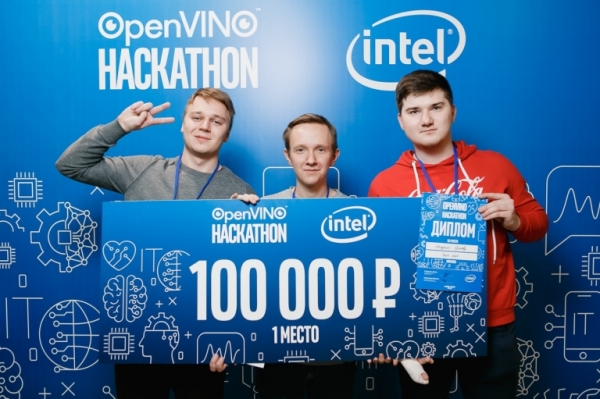
Cansados, mas felizes nósEm conclusão, gostaríamos de agradecer aos organizadores e participantes. Dos projetos de outras equipes, pessoalmente gostamos da solução para monitoramento de vagas de estacionamento disponíveis. Para nós, foi uma experiência incrível de imersão no produto e desenvolvimento. Espero que mais eventos interessantes, incluindo sobre o tema de IA, sejam realizados nas regiões.
Fonte: habr.com
