

O código de produtos de software para aprendizado de máquina muitas vezes é complexo e bastante confuso. A detecção e eliminação de bugs nele é uma tarefa que consome muitos recursos. Até mesmo as mais simples exigem uma abordagem séria em relação à arquitetura da rede, à inicialização de pesos e à otimização da rede. Um pequeno erro pode levar ao surgimento de problemas indesejados.
Este artigo é dedicado ao algoritmo de depuração de suas redes neurais.
A Skillbox recomenda: Curso Prático .
Lembramos: para todos os leitores do «Habr» — desconto de 10.000 rublos na inscrição em qualquer curso Skillbox com o código promocional «Habr».
O algoritmo consiste em cinco etapas:
- início simples;
- validação de perdas;
- verificação de resultados intermediários e conexões;
- diagnóstico de parâmetros;
- monitoramento do funcionamento.
Se algo lhe parecer mais interessante do que o restante, você pode ir diretamente a essas seções.
Início Simples
Depurar uma rede neural com arquitetura complexa, regularização e programador de taxa de aprendizado é mais difícil do que uma rede comum. Aqui estamos sendo um pouco astutos, pois este item de depuração tem uma relação indireta, mas ainda é uma recomendação importante.
O início simples consiste na criação de um modelo simplificado e seu treinamento em um único conjunto (ponto) de dados.
Primeiro criamos um modelo simplificado
Para um início rápido, criamos uma pequena rede com uma única camada oculta e verificamos se tudo funciona corretamente. Em seguida, complicamos o modelo gradualmente, verificando cada novo aspecto de sua estrutura (camada adicional, parâmetro, etc.), e seguimos em frente.
Treinamos o modelo em um único conjunto (ponto) de dados
Como uma verificação rápida da viabilidade do seu projeto, você pode usar um ou dois pontos de dados para o treinamento, a fim de confirmar se o sistema está funcionando corretamente. A rede neural deve mostrar 100% de precisão no treinamento e na verificação. Se não for o caso, ou o modelo é muito pequeno, ou você já tem um bug.
Mesmo que tudo esteja bem, prepare o modelo para passar por uma ou várias épocas antes de avançar.
Avaliação de Perdas
A avaliação de perdas é a principal maneira de refinar o desempenho do modelo. Você precisa garantir que a perda corresponda à tarefa, e que as funções de perda sejam avaliadas em uma escala correta. Se você estiver usando mais de um tipo de perda, certifique-se de que todas estejam na mesma ordem e corretamente escalonadas.
É importante estar atento às perdas iniciais. Verifique o quão próximo o resultado real está do esperado, se o modelo começou com uma suposição aleatória. Em : "Certifique-se de que você está obtendo o resultado esperado ao começar a trabalhar com um pequeno número de parâmetros. É melhor verificar imediatamente a perda de dados (definindo o grau de regularização como zero). Por exemplo, para CIFAR-10 com um classificador Softmax, esperamos que as perdas iniciais sejam 2.302, pois a probabilidade difusa esperada é de 0,1 para cada classe (já que existem 10 classes), e a perda Softmax é a probabilidade logarítmica negativa da classe correta como -ln(0.1) = 2.302."
Para um exemplo binário, faz-se um cálculo semelhante para cada uma das classes. Aqui, por exemplo, os dados: 20% 0's e 80% 1's. A perda inicial esperada será de até -0,2ln(0,5) - 0,8ln(0,5) = 0,693147. Se o resultado for maior que 1, isso pode indicar que os pesos da rede neural não estão devidamente equilibrados ou que os dados não estão normalizados.
Verificamos os resultados intermediários e as conexões
Para depurar a rede neural, é necessário entender a dinâmica dos processos dentro da rede e o papel das camadas intermediárias, uma vez que elas estão interconectadas. Aqui estão erros típicos que você pode encontrar:
- expressões incorretas para atualizações de gradiente;
- atualizações de pesos não aplicadas;
- gradientes desaparecendo ou explodindo (exploding gradients).
Se os valores dos gradientes forem zero, isso significa que a taxa de aprendizado no otimizador é muito baixa, ou que você encontrou uma expressão incorreta para a atualização do gradiente.
Além disso, é necessário monitorar os valores das funções de ativação, pesos e atualizações de cada uma das camadas. Por exemplo, o montante das atualizações de parâmetros (pesos e vieses) .
Há um fenômeno conhecido como “Dying ReLU” ou , quando neurônios ReLU produzem zero após aprender um grande valor negativo (bias) para seus pesos. Esses neurônios nunca mais serão ativados em nenhum dos dados.
Você pode usar a verificação do gradiente para identificar esses erros aproximando o gradiente com um método numérico. Se estiver próximo dos gradientes calculados, o retropropagação foi implementada corretamente. Para criar uma verificação do gradiente, confira estes excelentes recursos do CS231. e , assim como do Andrew Ng sobre o tema.
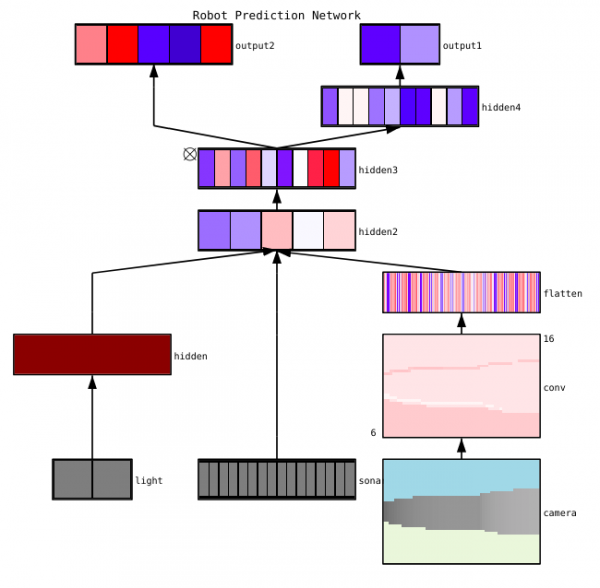
indica três principais métodos de visualização de redes neurais:
- Pré-dimensionais — métodos simples que nos mostram a estrutura geral do modelo treinado. Eles incluem a saída das formas ou filtros de camadas individuais da rede neural e dos parâmetros em cada camada.
- Baseados em ativações. Neles, deciframos as ativações de neurônios individuais ou grupos de neurônios para entender suas funções.
- Baseados em gradientes. Esses métodos tendem a manipular os gradientes formados a partir da passagem para frente e para trás durante o treinamento do modelo (incluindo mapas de importância e mapas de ativação da classe).
Existem várias ferramentas úteis para visualizar ativações e conexões de camadas individuais, como e .
Diagnóstico de parâmetros
Redes neurais têm muitos parâmetros que interagem entre si, complicando a otimização. De fato, esta seção é objeto de pesquisa ativa por especialistas, portanto, as sugestões abaixo devem ser vistas apenas como dicas, pontos de partida a partir dos quais você pode se basear.
Tamanho do lote (batch size) — se é necessário que o tamanho do lote seja grande o suficiente para obter estimativas precisas do gradiente do erro, mas pequeno o suficiente para que a descida do gradiente estocástico (SGD) possa organizar sua rede. Tamanhos de lote pequenos levarão a uma rápida convergência devido ao ruído no processo de treinamento e, posteriormente, a dificuldades de otimização. Mais informações podem ser encontradas .
Taxa de aprendizado — muito baixa levará a uma convergência lenta ou ao risco de ficar preso em mínimos locais. Ao mesmo tempo, uma alta taxa de aprendizado causará a divergência da otimização, pois você corre o risco de "saltar" através de uma parte da função de perda que é profunda, mas estreita. Tente usar um agendamento de taxa para reduzí-la durante o treinamento da rede neural. No curso CS231n .
Recorte de Gradiente — recorte dos gradientes dos parâmetros durante a retropropagação até um valor máximo ou norma limite. Útil para resolver problemas com gradientes explosivos que você pode encontrar no terceiro item.
Normalização em Lote — é usada para normalizar os dados de entrada de cada camada, ajudando a resolver o problema do desvio covariante interno. Se você estiver usando Dropout e Batch Norm juntamente, .
Descida de Gradiente Estocástica (SGD) — há várias variantes de SGD que utilizam momento, taxas de aprendizagem adaptativas e o método de Nesterov. No entanto, nenhuma delas tem uma vantagem clara em termos de eficiência de aprendizagem ou generalização ().
Regularização — é crucial para construir um modelo generalizável, pois adiciona uma penalização pela complexidade do modelo ou valores extremos dos parâmetros. Essa é uma forma de reduzir a variância do modelo sem aumentar significativamente seu viés. Mais .
Para avaliar tudo por conta própria, você precisa desativar a regularização e verificar o gradiente da perda de dados por conta própria.
Dropout — é mais um método para organizar sua rede e evitar sobrecarga. Durante o treinamento, o dropout é aplicado apenas mantendo a atividade do neurônio com uma certa probabilidade p (hiperparâmetro) ou definindo-o como zero no caso contrário. Como resultado, a rede deve usar um subconjunto diferente de parâmetros para cada lote de treinamento, o que diminui a dominância de certos parâmetros.
Importante: se você estiver usando tanto o dropout quanto a normalização em lote, tenha cuidado com a ordem dessas operações ou até mesmo com seu uso conjunto. Tudo isso ainda está sendo amplamente discutido e complementado. Aqui estão duas discussões importantes sobre o tema e .
Controle de desempenho
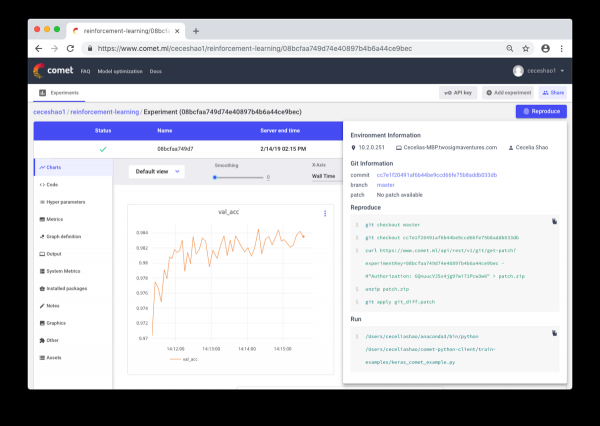
Trata-se da documentação de processos de trabalho e experimentos. Se nada for documentado, é fácil esquecer, por exemplo, qual a velocidade de aprendizado ou o peso das classes utilizadas. Com o controle, é possível revisar e reproduzir experimentos anteriores sem problemas. Isso ajuda a reduzir o número de experimentos duplicados.
No entanto, a documentação manual pode se tornar uma tarefa complexa em caso de grande volume de trabalho. Aqui, ferramentas como Comet.ml se tornam úteis, ajudando a registrar automaticamente conjuntos de dados, alterações de código, histórico de experimentos e modelos de produção, incluindo informações chave sobre seu modelo (hiperparâmetros, métricas de desempenho do modelo e dados do ambiente).
Redes neurais podem ser bastante sensíveis a pequenas mudanças, o que pode levar a uma queda no desempenho do modelo. O rastreamento e a documentação do trabalho são o primeiro passo a ser tomado para padronizar o ambiente e modelar.
Espero que este post possa ser um ponto de partida para você começar a depurar sua rede neural.
A Skillbox recomenda:
- Curso Prático de Dois Anos .
- Curso online .
- Curso prático de um ano .
Fonte: habr.com
