

Compania Stability AI a publicat a doua ediție a sistemului de învățare automată Stable Diffusion, capabil să sintetizeze și să modifice imagini pe baza unui șablon propus sau a unei descrieri textuale în limbaj natural. Codul instrumentelor pentru antrenarea rețelei neuronale și generarea imaginilor este scris în limbajul Python utilizând cadrul PyTorch și este publicat sub licența MIT. Modelele deja antrenate sunt deschise sub licența permisivă Creative ML OpenRAIL-M, care permite utilizarea în scopuri comerciale. De asemenea, este disponibil un generator de imagini online demonstrativ.
Îmbunătățiri cheie în noua ediție Stable Diffusion:
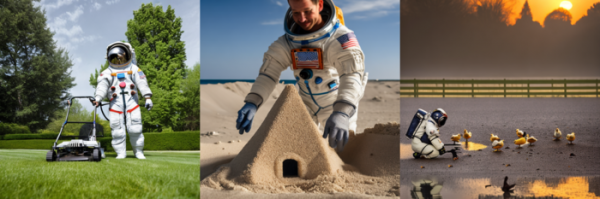
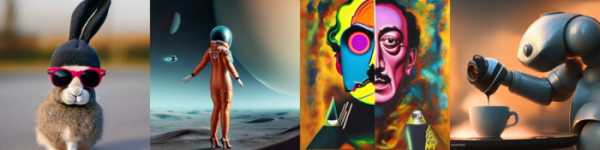
- A fost creat un nou model de sinteză a imaginilor pe baza descrierii textuale — SD2.0-v, care suportă generarea de imagini cu o rezoluție de 768×768. Noua model este antrenat folosind colecția LAION-5B, care include 5.85 miliarde de imagini cu descrieri textuale. Modelul utilizează aceleași set de parametri ca și modelul Stable Diffusion 1.5, dar se distinge prin trecerea la utilizarea unui codificator cu totul diferit, OpenCLIP-ViT/H, care a permis să se îmbunătățească semnificativ calitatea imaginilor rezultate.

- A fost pregătită o variantă simplificată, SD2.0-base, antrenată pe imagini de 256×256 folosind modelul clasic de predicție a zgomotului și care suportă generarea de imagini cu o rezoluție de 512×512.

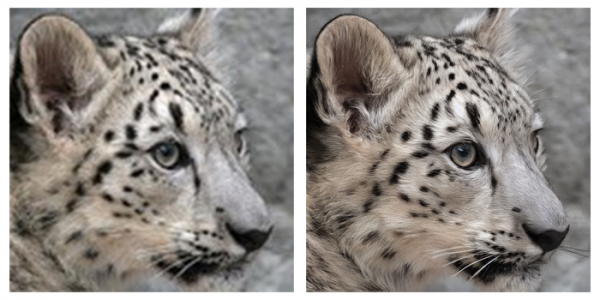
- A fost oferită posibilitatea de a utiliza tehnologia de super-sampling (Super Resolution) pentru a mări rezoluția imaginii originale fără a scădea din calitate, folosind algoritmi de scalare spațială și reconstrucție a detaliilor. Modelul de procesare a imaginilor oferit (SD20-upscaler) suportă quadruplarea scalei, ceea ce permite generarea de imagini cu o rezoluție de 2048×2048.

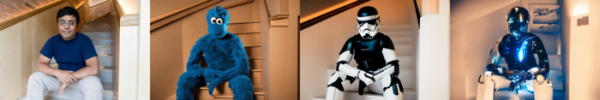
- A fost propus modelul SD2.0-depth2img, care ia în considerare profunzimea și poziționarea spațială a obiectelor. Pentru evaluarea monocolor a adâncimii se utilizează sistemul MiDaS. Modelul permite sintetizarea de noi imagini, folosind o altă imagine ca șablon, care pot diferi radical de original, dar păstrează compoziția generală și adâncimea. De exemplu, poate fi utilizată postura unei persoane dintr-o fotografie pentru a crea un alt personaj în aceeași poziție.


- Modelul pentru modificarea imaginilor a fost actualizat - SD 2.0-inpainting, care permite, prin intermediul sugestiilor textuale, să înlocuiești și să modifici părți din imagine.
- Au fost optimizate modelele pentru utilizarea pe sisteme obișnuite cu un singur GPU.
Sursa: opennet.ro
