

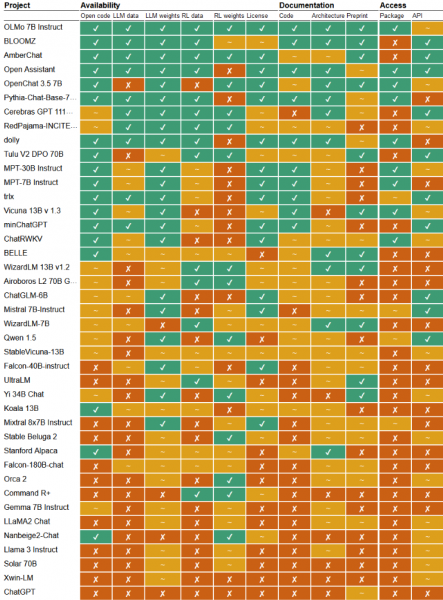
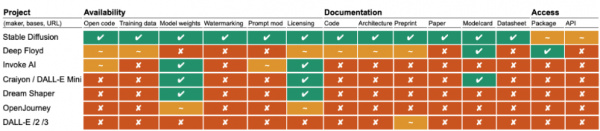
Cercetătorii de la Universitatea Nijmegen (Olanda) au pregătit un clasament al deschiderii a 40 de mari modele lingvistice și 7 modele pentru generarea de imagini din descrieri textuale, pe care producătorii le declară ca fiind deschise. Din cauza faptului că criteriile de deschidere a modelelor de învățare automată sunt încă în formare, în prezent a apărut o situație în care sunt distribuite modele, sub pretextul că sunt deschise, care au o licență ce limitează domeniul de utilizare (de exemplu, multe modele interzic utilizarea în proiecte comerciale). De asemenea, adesea producătorii nu oferă acces la datele utilizate pentru formare, nu dezvăluie detalii despre implementare sau nu deschid complet codul aferent.
Cele mai multe modele, promovate ca fiind „deschise”, ar trebui de fapt considerate ca „coeficienți deschiși” sau mai precis „coeficienți disponibili”, deoarece sunt distribuite sub licențe restrictive, care interzic utilizarea în produse comerciale. Cercetătorii terți pot experimenta cu astfel de modele, dar nu au posibilitatea de a adapta modelul la nevoile lor sau de a inspecta implementarea. Peste jumătate din modele nu oferă detalii despre datele utilizate pentru formare și de asemenea nu publică informații despre structura internă și arhitectură.
Cele mai deschise sunt recunoscute modelele BloomZ, AmberChat, OLMo, Open Assistant și Stable Diffusion, care sunt publicate sub licențe deschise împreună cu datele originale, codul și implementarea API. Modelele de la Google (Gemma 7B), Microsoft (Orca 2) și Meta (Llama 3), promovate de producători ca fiind deschise, s-au situat spre finalul clasamentului, deoarece nu oferă acces la datele originale, nu dezvăluie detalii tehnice despre implementare, iar coeficienții modelului sunt distribuiți sub licențe care limitează domeniul de utilizare. Modelul popular Mistral 7B s-a situat aproximativ în mijlocul clasamentului, deoarece este livrat sub o licență deschisă, dar este doar parțial documentat, nu dezvăluie datele utilizate pentru formare și are un cod însoțitor care nu este complet deschis.
Cercetătorii au propus 14 criterii de deschidere a modelelor AI, care acoperă condițiile de distribuire a codului, a datelor pentru antrenament, a coeficientelor, a variantelor de date și a coeficientelor optimizate cu ajutorul învățării prin întărire (RL), precum și disponibilitatea pachetelor gata de utilizare, API-urilor, documentației și descrierii detaliate a implementării.
Conform propunerii organizației OSI (Open Source Initiative) pentru definiția preliminară a AI-ului deschis, principalele criterii de deschidere a sistemului AI sunt oferirea posibilităților de utilizare în orice scop fără a necesita obținerea unei permisiuni separate; studiul funcționării sistemului și inspecția componentelor sale; efectuarea de modificări pentru orice scop; transmiterea altor persoane atât a variantei originale, cât și a versiunii editate după efectuarea modificărilor.
Pentru a permite modificarea, sistemul AI trebuie să includă:
- Informații detaliate despre datele utilizate la antrenament și metodologia de învățare. Informațiile trebuie să fie suficient de detaliate pentru ca un dezvoltator profesionist să poată recrea un sistem AI echivalent, folosind aceleași sau date similare pentru antrenament.
- Disponibilitatea codului sursă care permite atât rularea sistemului AI, cât și efectuarea procesului său de antrenament (în tabelul menționat anterior, în coloana „cod” pentru multe modele este indicat „~”, ceea ce implică o disponibilitate parțială a codului, când codul pentru rularea modelului este disponibil, dar nu și codul pentru antrenare sau crearea modelului). Codul ar trebui să acopere și domenii precum preprocesare, verificarea datelor și tokenizarea. De asemenea, ar trebui să fie furnizată o descriere detaliată a arhitecturii modelului.
- Parametrii modelului (coeficientii) indicând disponibilitatea unei versiuni pregătite de utilizare a stării după antrenament sau a unei variante finale optimizate a modelului.
Sursa: opennet.ro
