

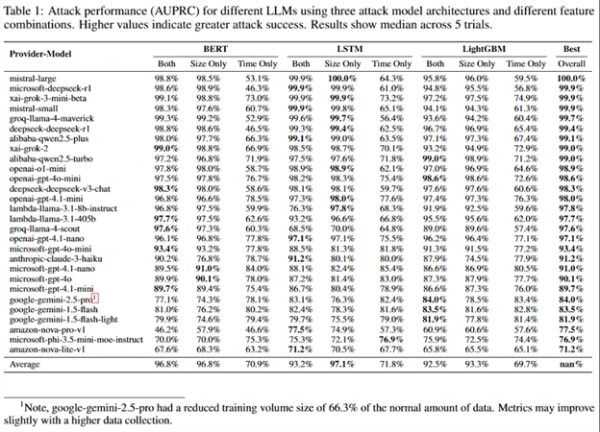
Cercetătorii în domeniul securității de la Microsoft au dezvoltat o tehnică de atac prin canale laterale numită Whisper Leak, care, pe baza analizei pasive a traficului criptat transmis printr-o conexiune TLS, permite clasificarea subiectelor interogărilor către servicii bazate pe modele linguistice mari. Informațiile despre dimensiunea pachetelor de date și întârzierile dintre trimiterea acestora s-au dovedit a fi suficiente pentru a determina subiectele interogărilor către chatboții AI cu o acuratețe de peste 98%. În practică, metoda propusă poate fi utilizată pentru a identifica în traficul utilizatorului anumite subiecte ale interogărilor, de exemplu, încercările de a obține informații despre activități ilegale, fără a decripta conținutul.
Instrumentele pentru extragerea datelor din dump-uri de trafic, antrenarea modelului și testarea metodei au fost publicate pe GitHub. Posibilitatea de a efectua atacul a fost demonstrată pentru 28 de modele linguistice mari populare de la cei mai mari furnizori. De exemplu, acuratețea determinării interogărilor pe tema „spălare de bani” pentru multe servicii AI a fost de 100%, în urma analizei traficului cu 1 interogare dorită și 10.000 de interogări care nu erau legate de subiectul respectiv.
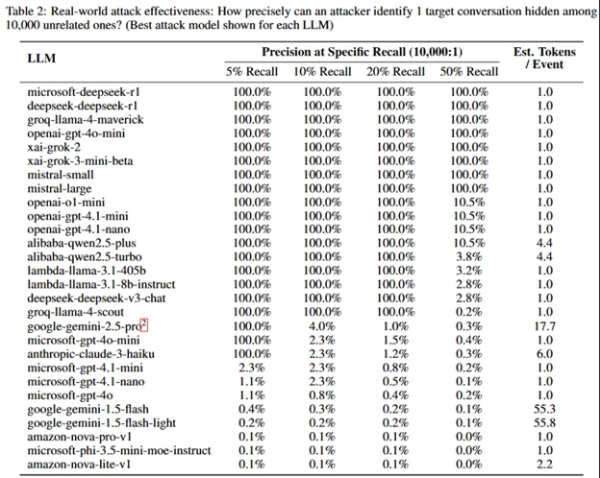
Cauza scurgerii de informații este că modelele generează răspunsuri la interogări pas cu pas, token cu token, folosind fiecare token anterior ca context pentru a determina următorul cuvânt sau frază cel mai probabil. Astfel, pentru fiecare token este trimis un pachet de date separat, iar întârzierea dintre pachete corespunde întârzierii dintre determinarea de către model a următorului token.
În TLS, dacă nu se folosește compresia datelor, mărimea textului criptat este egală cu dimensiunea textului necriptat plus o constantă. Când se creează un model care corelează seturile de tokenuri căutate cu dimensiunile pachetelor și întârzierile dintre trimiterea acestora, se poate determina cu o precizie suficientă prezența temelor dorite în trafic. În cursul cercetării, au fost pregătite trei variante de modele de învățare automată bazate pe arhitecturi de rețele neuronale LightGBM, Bi-LSTM și BERT. Pentru fiecare model au fost efectuate experimente pentru a determina subiectul dorit analizând doar dimensiunea pachetelor, doar întârzierile dintre pachete și ambele criterii.
Pentru a reduce eficiența analizei pasive a tematicii căutărilor, dezvoltatorii de servicii AI sunt sfătuiți să adauge umplutură randomizată, să bufferizeze transmiterea token-urilor sau să efectueze substituția de pachete fictive.
Sursa: opennet.ro
