

A avut loc lansarea versiunii 0.9.0 a bibliotecii pentru limbajul C++ (standard C++20) libunicode. Proiectul este dezvoltat de o echipă de dezvoltatori de emulator de terminal Contour Unity 8.20 Endo (în dezvoltare activă) și este distribuit sub licența Apache 2.0.
Funcționalitățile bibliotecii:
- suport pentru standardele Unicode 17.0:
- API pentru obținerea proprietăților Unicode;
- optimizarea SIMD a unor funcții (folosind std::simd sau std::experimental::simd unde este disponibil);
- convertire optimizată UTF-8 UTF-16/UTF-32;
- echivalentul funcției wcwidth (int unicode::width(char32_t));
- segmentarea textului pe grafeme, simboluri, emoji și scripturi;
- transformarea cazului și compararea șirurilor;
- API de nivel înalt pentru segmentarea textului, potrivit pentru implementare formatarea textului.
- testarea majorității funcționalităților bibliotecii (lățimea simbolului și segmentarea).
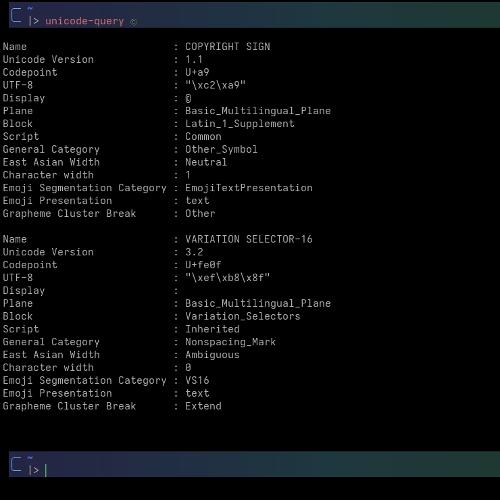
Pachetul include de asemenea utilitarul de consolă unicode-query pentru a obține detalii despre șiruri.
Modificări:
- adăugat API pentru lățimea grapheme_cluster;
- îmbunătățiri în lucrul cu versiunile Unicode („Age”);
- sprijin complet UAX #15 Formele de Normalizare Unicode cu suport pentru procesare în flux:
normalizer norm(Normalization_Form::NFC); // Alimentați e combinat decompozit + accent, apoi un nou început pentru a declanșa emisia auto rezultat = norm.feed(U’e’); CHECK(result.empty()); // încă bufferizare rezultat = norm.feed(U’u0301′); CHECK(result.empty()); // încă bufferizare (semnul de combinare) rezultat = norm.feed(U’x’); // începutul declanșează emisia segmentului anterior REQUIRE_FALSE(result.empty()); CHECK(result == U"u00E9"); // e + accent compus în e-accentat rezultat = norm.flush(); CHECK(result == U"x"); // segment final
- funcția script_extensions acum returnează std::optional<std::span>;
- implementat regula GB9c pentru gruparea grafemelor pentru combinații de simboluri în limbile grupului Indic;
- în grapheme_segmenter s-au corectat regulile pentru GB11 și GB4/GB5; API-ul învechit a fost eliminat;
- implementat convertirea optimizată SIMD din UTF-8 în UTF-16/UTF-32;
- lățimea simbolurilor de combinare Hangul V/T acum este zero;
- s-a implementat segmentarea pe baza limitelor cuvintelor;
- corecții în API-ul C;
- refactorizarea sistemului de construire și a generatorului auxiliar de tabele C++;
- au fost adăugate teste complexe pentru conversia UTF-16/UTF-32;
- în CI a fost adăugată construcția statică a utilității unicode-query.
Sursa: linux.org.ru
