

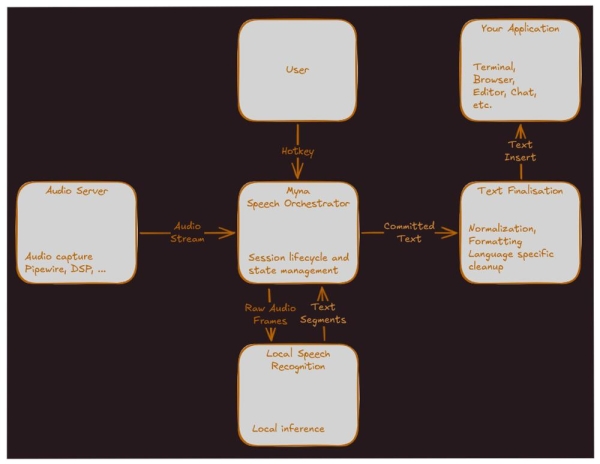
Canonical a lansat proiectul Myna — un nou sistem de conversie a vorbirii în text pentru Ubuntu Desktop. Proiectul este destinat dictării integrate: utilizatorul apasă o combinație de taste, vorbește, iar textul recunoscut apare în aplicația activă. În anunț se subliniază că Myna ar trebui să fie percepută ca o parte firescă a desktop-ului Ubuntu și să funcționeze cu respectarea intimității utilizatorului. Lista limbilor de intrare acceptate la momentul publicării știrii nu a fost comunicată.
Prima țintă a proiectului este Ubuntu 26.10. În această etapă, Canonical nu încearcă să dezvolte un asistent vocal complet sau un sistem de control al desktop-ului prin voce. Dezvoltatorii au limitat intenționat domeniul primei versiuni la dictarea de bază și fiabilă: apăsați combinația de taste, pronunțați textul și obțineți rezultatul în câmpul de introducere actual. Mediul de testare inițial este Ubuntu Desktop pe Wayland cu GNOME, dar arhitectura este planificată să rămână suficient de deschisă pentru suportul viitor al altor medii.
Myna este destinat recunoașterii locale a vorbirii. După instalarea modelurilor necesare, nu este necesară o conexiune la internet pentru funcționarea dictării, iar microfonul trebuie utilizat doar după activarea explicită de către utilizator, audio-ul este procesat în memorie și apoi eliminat, iar înregistrările nu sunt trimise către servicii externe. În specificația proiectului, de asemenea, se menționează că soluția ar trebui să evite păstrarea audio-ului în mod implicit și să nu comute în mod invizibil pe un serviciu cloud.
Codul și documentația Myna sunt publicate în repository-ul Canonical pe GitHub. Proiectul este descris ca o aplicație ușoară de speech-to-text pentru Ubuntu Desktop și este distribuit sub licența GPL-3.0. Totuși, proiectul se află într-o etapă incipientă: în repository nu există încă versiuni publicate, iar specificația arhitecturală are statutul de Proposed.
Funcții și caracteristici principale ale Myna
Dictare push-to-talk. Utilizatorul menține apăsată o combinație de taste personalizabilă, vorbește, iar sistemul introduce textul recunoscut în câmpul de introducere ales. Dictarea se încheie după eliberarea tastei.
Recunoașterea locală a vorbirii. Recunoașterea se efectuează pe mașina utilizatorului printr-un stack de inferență local. Aceasta reduce dependența de cloud și permite funcționarea fără rețea după instalarea modelurilor.
Procesarea privată a audio-ului. Microfonul se activează doar în timpul sesiunii de dictare a utilizatorului. Audio nu ar trebui să fie înregistrat pe disc în mod implicit, se folosește un buffer limitat în memorie, care este șters după încheierea sesiunii.
Indicator vizual de activitate. În timpul înregistrării și transcrierii, utilizatorul trebuie să vadă un indicator de stare clar. În specificație sunt menționate stările precum Înregistrare, Transcriere, Finalizare și Eroare.
Inserarea doar a textului stabil. În prima implementare, ipotezele intermediare de recunoaștere nu ar trebui să fie introduse direct în aplicație. Doar textul final confirmat este trimis în câmpul țintă.
Post-procesarea textului. Transcrierea brută poate trece prin normalizare, punctuație, capitalizare, formatare și transformarea formelor vorbite în cele scrise, de exemplu, “douăzeci și doi” → “22”.
Selectarea limbii de dictare. Sistemul ar trebui să suporte o limbă de dictare personalizabilă, bazându-se în mod implicit pe limba interfeței utilizatorului, dacă pentru aceasta este disponibil un model adecvat.
Profilele de calitate ale modelului. În specificație sunt prevăzute diferite profile de model: o variantă ușoară cu un consum mai mic de resurse, un profil standard echilibrat și o variantă de calitate superioară, dar mai grea.
Funcționare în siguranță cu focalizarea de intrare. Câmpul pentru inserarea textului este selectat la începutul sesiunii. Dacă focalizarea ferestrei se schimbă în timpul dictării, sistemul nu ar trebui să trimită textul în mod silencios într-o altă aplicație.
Blocat în câmpuri protejate. Dictarea ar trebui să fie blocată în câmpuri de parolă, feronerie de autentificare și alte locuri protejate, dacă aplicația sau toolkit-ul permit acest lucru.
Integrarea cu Wayland/GNOME. Prima versiune este orientată spre Wayland și GNOME. Pentru inserția inițială a textului se ia în considerație IBus, iar în viitor se preconizează un mod mai nativ prin protocoale de metodă de intrare/text-input.
Setările utilizatorului. În interfața de setări planificată ar trebui să existe activarea/dezactivarea STT, alegerea tastei rapide, limba de dictare, microfonul, profilul modelului, opțiunile de post-procesare și indicatorul de activitate.
În prima iterație, printre funcțiile care rămân în afara proiectului se numără activarea prin cuvinte cheie, ascultarea de fundal constantă, recunoașterea în cloud, asistentul vocal, comenzile vocale, gestionarea desktop-ului, traducerea vorbelor, identificarea vorbitorului, detectarea automată a limbii și istoricul dictezelor. Cu alte cuvinte, Canonical nu începe cu un „asistent AI”, ci cu o funcție mai pragmatică: introducerea vocală locală a textului în aplicațiile obișnuite Ubuntu.
Sursa: linux.org.ru
